AlphaEvolve, Harbor, Gemini 4 Argon으로 에이전트 스킬 최적화 도구 빌드하기
Ivan Nardini
AI Developer Relations Engineer
Anant Nawalgaria
Group Product Manager & Sr. Staff Engineer
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
매일 점점 더 많은 사람들이 소프트웨어 엔지니어링 작업을 완료하기 위해 Google Antigravity 및 OpenCode와 같은 코딩 에이전트를 사용하고 있습니다. 하지만 이러한 도구가 제대로 작동하려면 요청 사항이 필요하며, 출력의 품질은 입력의 품질에 따라 달라집니다. 개발자는 코드 빌드, 테스트, 배포를 통해 에이전트를 안내하는 에이전트 스킬을 활용하여 워크플로를 자동화하는 강력한 방법을 확보할 수 있습니다.
하지만 대부분의 스킬은 수동으로 작성되므로 출력을 평가하지 않고는 어떤 요청 사항이 효과적인지 알기 어렵습니다.
스킬의 효과를 측정하기 위해 공개 벤치마크인 Terminal-Bench 2.0의 작업에서 Gemini 3.8 Flash를 사용하여 OpenCode를 실행했습니다. 결과는 불확실했습니다. 기준 스킬을 사용했을 때 에이전트는 시도의 약 3분의 2를 통과했지만, 스킬을 사용하지 않았을 때도 결과는 거의 동일했습니다. 더 확실한 결과가 필요했습니다.
이를 달성하기 위해 Google은 코드를 최적화하는 방식으로 스킬을 최적화하는 AlphaEvolve를 사용했습니다. Gemini가 새 버전을 제안하면 평가자가 점수를 매기고 검색은 더 높은 점수를 받은 버전을 유지합니다. Harbor를 사용하면 실제 작업을 수행하는 실제 코딩 에이전트가 평가자 역할을 할 수 있습니다. AlphaEvolve를 몇 차례 반복 실행하는 것만으로도 5%의 개선 효과를 확인했습니다.
다음과 같이 동일한 루프를 빌드할 수 있습니다.
-
스킬을 프로그램으로 취급: AlphaEvolve는 스킬의 텍스트를 다시 작성할 수 있습니다.
-
에이전트가 평가하도록 하기: Harbor는 실제 작업에서 스킬을 사용하여 에이전트를 실행합니다.
-
점수의 신뢰도 높이기: 각 버전을 기준 스킬과 비교하고 두 버전을 동시에 실행합니다.
-
처음 접하는 작업에서 최적의 버전 확인: 최종 검증을 위해 검색에서 사용하지 않은 일부 작업을 따로 남겨둡니다.
스킬을 프로그램으로 취급
AlphaEvolve는 시드 프로그램에서 두 마커 사이의 코드를 개선하도록 설계되었습니다. 스킬은 이름, 설명, 마크다운 요청 사항이 포함된 SKILL.md 파일이므로 마커 사이에 텍스트를 넣고 Gemini가 다시 작성하도록 합니다.
AlphaEvolve는 Google Cloud에서 작동하며 코드를 실행하지 않습니다. 피드백은 평가자가 무엇이 '더 나은' 결과인지 판단하여 반환하는 점수와 메모로 구성됩니다.
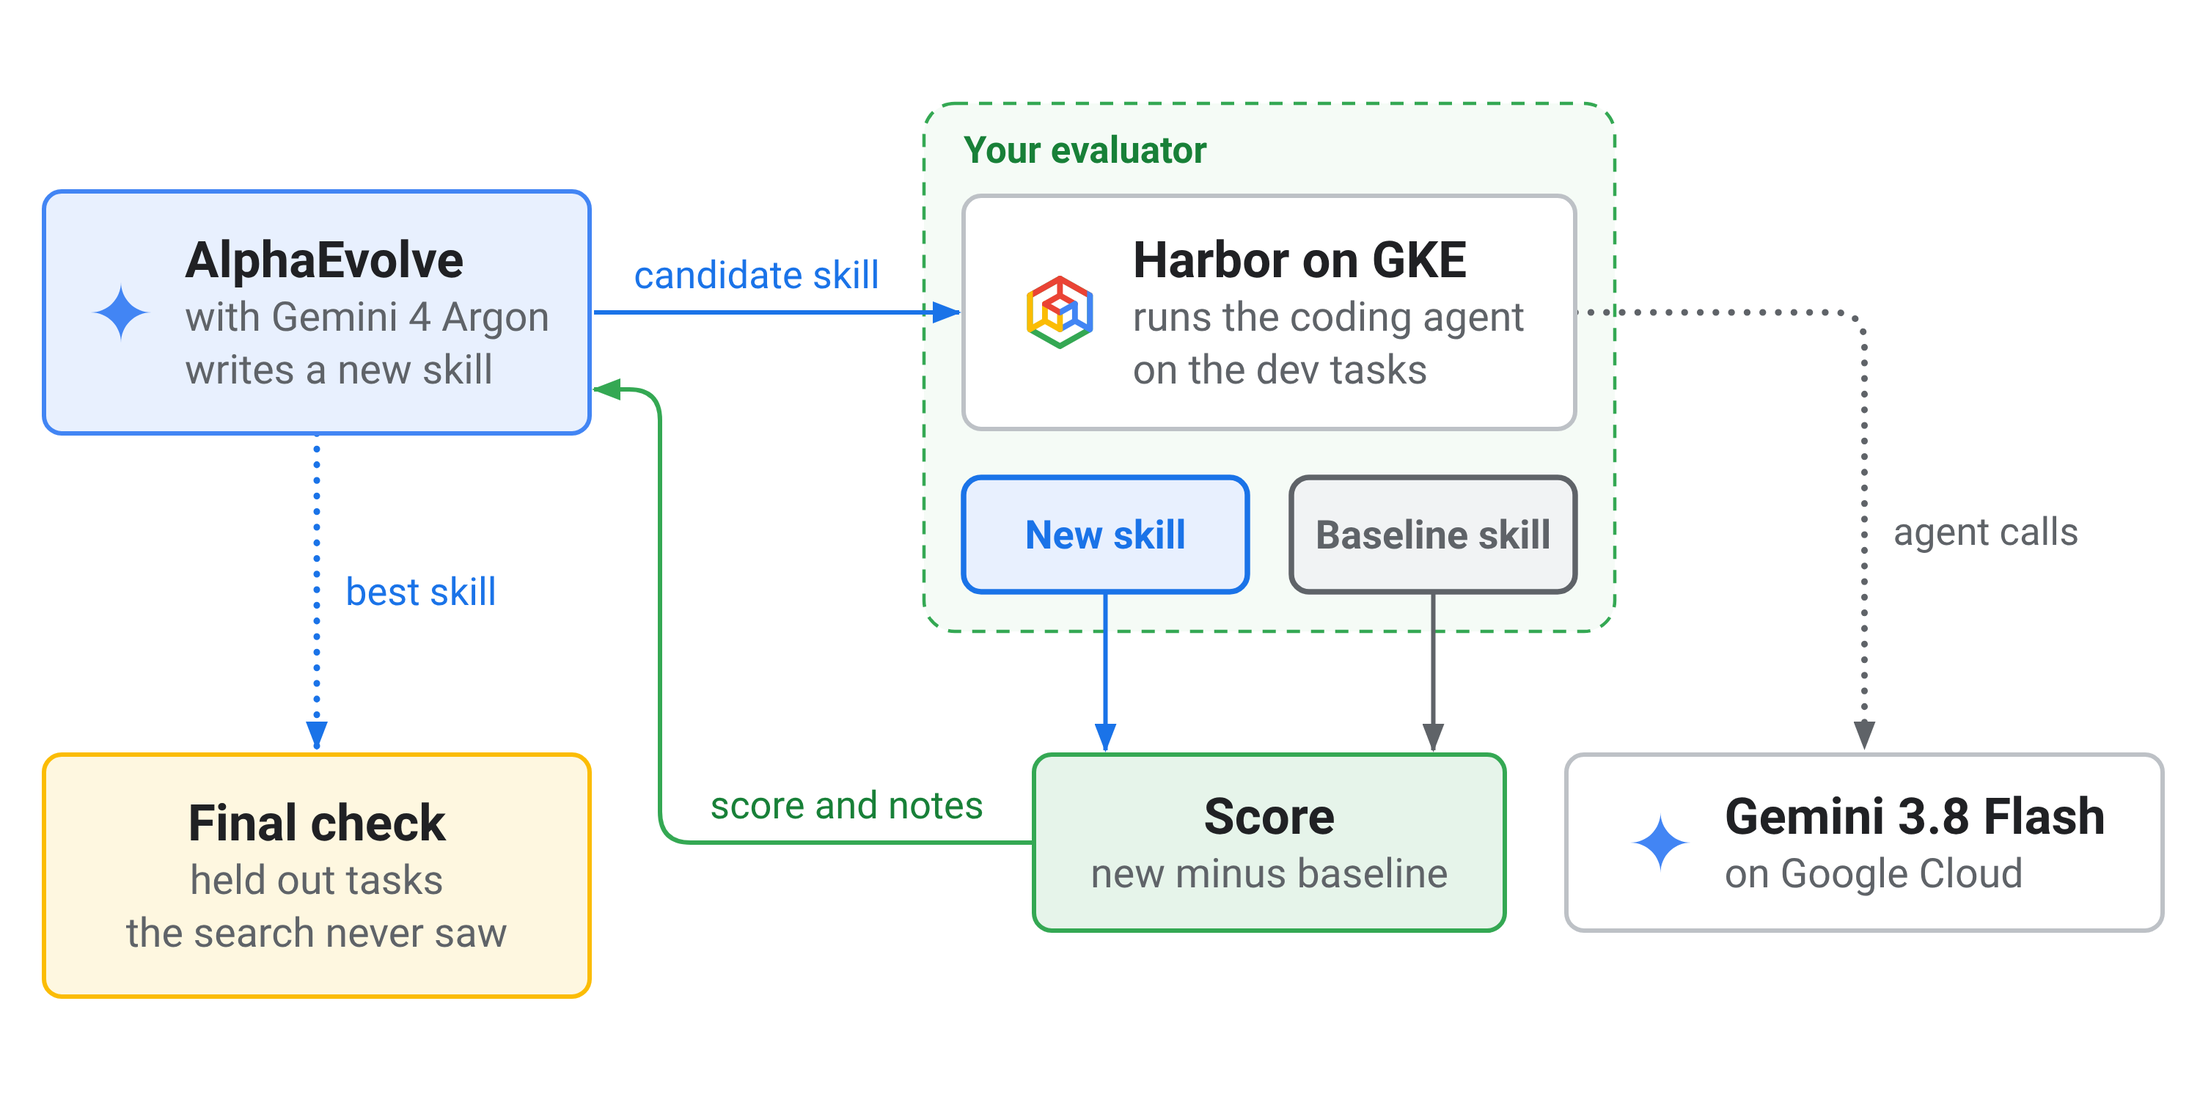
이미지 1. AlphaEvolve가 스킬을 제안하면 Harbor는 기준 스킬과 함께 해당 스킬을 사용하는 에이전트를 실행하고 점수와 메모를 AlphaEvolve로 다시 보냅니다.
에이전트가 평가하도록 하기
Harbor는 벤치마크 작업에서 에이전트를 실행하며, 각 시도는 자체 컨테이너에서 이루어집니다. Google은 시도당 하나의 포드를 사용하여 Google Kubernetes Engine(GKE)에서 이를 실행했으며, 단일 검색으로 수천 개의 에이전트 시도를 실행했습니다.
평가자는 각 후보에 대해 통과 및 실패 여부에 따른 점수와 실패하거나 타임아웃된 작업에 대한 간단한 메모를 반환합니다. 그런 다음 AlphaEvolve는 이러한 메모를 Gemini에 전송하여 다음 버전을 만듭니다.
점수의 신뢰도 높이기
에이전트의 평가 점수에는 노이즈가 있을 수 있습니다. 동일한 벤치마크에 대한 초기 실행 중 하나에서는 모델의 지연 시간이 후보 점수 간 차이의 대부분을 설명했습니다. 각 후보가 동일한 작업에서 기준 스킬과 동시에 실행되므로 점수에 차이가 나타납니다.
처음 접하는 작업에서 최적의 버전 확인하기
가장 뛰어난 스킬은 신중한 체크리스트로 구성된 기준 스킬과 다릅니다. 기준 스킬은 먼저 읽고, 실패를 재현하고, 검증된 작은 단계로 작업합니다. 반면 AlphaEvolve의 버전은 시간 제한을 중심으로 구성된 프로토콜입니다.
배운 내용
AlphaEvolve는 가장 흔한 실패 원인인 시간 부족에 초점을 맞췄습니다. 평가자의 메모에 보고된 바와 같이 검색 시도의 약 3분의 1이 시간 제한에 도달했으며, AlphaEvolve의 가장 뛰어난 스킬은 이 제한을 중심으로 구성되었습니다.
또한 검색을 실행하는 것이 루프를 빌드하는 것보다 더 어렵다는 사실을 알게 되었습니다. 약 10시간이 지난 후에는 검색에서 새로운 후보를 평가하지 못했습니다. 모델 응답이 느려지는 동안 지연 시간 검사로 인해 모든 평가가 보류되었고 전체 에이전트 로그가 컨트롤러의 디스크를 가득 채웠습니다. 장시간 검색을 수행하기 전에 모델 응답이 느려지는 시간대와 로그 스토리지에 대한 계획을 세우는 것이 중요합니다.
또한 에이전트 스킬 권장사항에 따라 에이전트에 부족한 부분을 보완하는 스킬을 추가했을 때 효과가 있었습니다. 기준 스킬은 측정 가능한 차이를 보이지 않은 반면, 답을 보유한 스킬은 개발 작업에서 점수를 33점 높였습니다.
Google의 가설은 오늘날의 모델과 코딩 에이전트가 이미 코딩 작업에 맞게 조정되어 있으므로 일반적인 조언만으로는 개선 효과를 얻기 어렵다는 것입니다. 그렇다면 검색을 통해 구체적인 개선 기회를 찾을 수 있습니다. AlphaEvolve의 가장 뛰어난 스킬은 에이전트의 가장 흔한 실패 원인인 시간 부족을 중심으로 구성되었습니다.
다음 단계
Google은 검색을 통해 추가할 수 있는 비즈니스 규칙이 에이전트에 부족한 엔터프라이즈 에이전트 하네스(시스템 프롬프트, 정책 요청 사항, 도구)에서 AlphaEvolve를 테스트하고 있습니다. 가상의 은행을 대상으로 고객 서비스 테스트 사례를 조사한 한 소규모 연구에서 AlphaEvolve는 Google이 심어 놓은 잘못된 정책 규칙을 찾아 수정하고, 이 수정사항을 이전에 접하지 않은 사례에도 적용했습니다.
다른 소규모 연구에서는 결과가 엇갈렸으며, 전체 연구가 완료되면 최종 결과를 공유할 예정입니다.
시작하기
-
Google Cloud의 AlphaEvolve: GitHub 저장소
-
벤치마크 및 하네스: Terminal-Bench 2.0 및 Harbor.
-
에이전트 스킬: agentskills.io 및 opencode 스킬 문서의 형식
읽어 주셔서 감사합니다. LinkedIn 또는 X에서 자체 테스트 결과를 알려주세요.