이제 Google Cloud에서 서버리스 Spark로 데이터 처리 및 데이터 과학 작업을 간소화하세요

Marek Wolczanski
Data Platform Engineer, OpenX
Abhishek Kashyap
Director, Product Management
* 본 아티클의 원문은 2022년 2월 4일 Google Cloud 블로그(영문)에 게재되었습니다.
오늘날 대부분의 기업이 데이터 엔지니어링, 데이터 탐색, 머신러닝 사용 사례에 빠르고, 단순하고, 프로그래밍 언어 사용이 유연한 Apache Spark를 사용합니다. 하지만 클러스터 관리와 인프라 조정이 매우 비효율적이고 다양한 사용 사례에 대한 통합 경험이 부족하여 생산성이 떨어짐에 따라, 거버넌스 위험이 증가하고 기업이 Spark를 통해 달성할 수 있는 잠재 가치가 줄어들고 있습니다.
오늘 Google Cloud에서는 업계 최초로 자동 확장 가능한 서버리스 Spark의 정식 버전을 발표합니다. 더불어 BigQuery를 통해 Spark의 비공개 미리보기를 제공함에 따라 BigQuery 사용자들이 데이터 분석에 BigQuery SQL와 함께 서버리스 Spark를 사용할 수 있게 됩니다. 이에 따라 사용자가 ETL, 데이터 과학, 데이터 분석 사용 사례를 규모에 따라 원활하게 이용할 수 있습니다.
Spark용 Dataproc 서버리스(정식 버전)
IDC에 따르면 개발자들은 업무 시간의 40%를 코드 작성에, 60%를 인프라 조정 및 클러스터 관리에 사용합니다. 하지만 모든 Spark 개발자가 인프라 전문가는 아니므로 이러한 작업 방식은 많은 비용을 발생시키고 생산성에 타격을 줍니다.
이제 정식 버전으로 제공되는 서버리스 Spark는 다음과 같은 장점을 통해 이러한 문제를 해결합니다.
- 개발자가 코드와 로직에 집중할 수 있습니다. 클러스터를 관리하거나 인프라를 조정할 필요가 없습니다. 개발자가 원하는 인터페이스에서 Spark 작업을 제출할 수 있으며 작업의 필요에 맞게 자동 확장되도록 처리됩니다.
- 데이터 엔지니어링팀이 사용자를 위해 인프라를 관리하고 모니터링할 필요가 없습니다. 시간을 더 가치 있는 데이터 엔지니어링 업무에 투입할 수 있습니다.
- 인프라 실행 시간이 아닌 작업 기간에 대해서만 비용을 지불합니다.
OpenX의 서버리스 Spark 사용 사례: 부담이 과중한 클러스터 관리에서 서버리스로 전환
OpenX는 게시자와 수요 파트너를 위한 최대 규모의 독립 광고 거래소 네트워크로, 낡은 MapReduce 파이프라인을 마이그레이션하고 있었습니다. 이전 MapReduce 클러스터는 여러 작업에서 공유했기 때문에 빈번하게 클러스터 크기를 업데이트하고 자동 확장 처리를 관리해야만 했으며 업그레이드와 기타 복구 불가능한 이유 때문에 클러스터를 수시로 다시 만들어야 했습니다.
OpenX는 Google Cloud의 서버리스 Spark를 사용하여 모든 클러스터 리소스를 추상화하고 작업에만 집중했습니다. 그러자 팀 생산성이 크게 향상되었으며 인프라 비용도 절감되었습니다. OpenX 입장에서 서버리스 Spark는 클러스터 수명 주기 관리의 유지 비용은 말할 것도 없고 리소스 관점에서도 더 저렴했습니다.
구현하는 도중에 OpenX는 우선 기존 파이프라인 특성을 평가했습니다. 입력 크기 시간당 일괄 워크로드의 크기는 시간당 1.7~2.8TB 압축된 Avro로 다양합니다. 파이프라인은 다른 작업과 함께 공유 클러스터에서 작동했고 데이터 셔플링이 필요하지 않습니다.
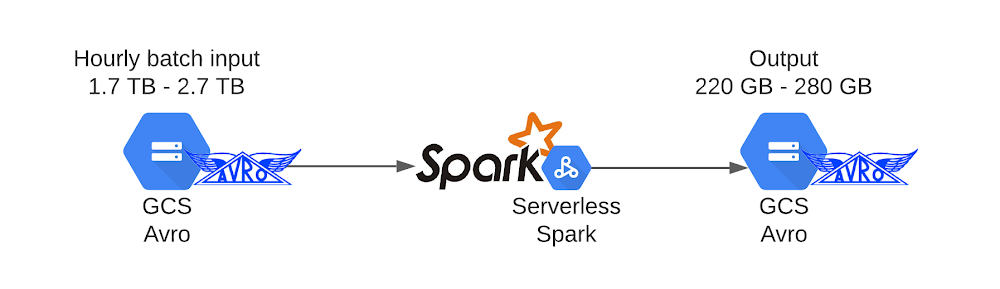
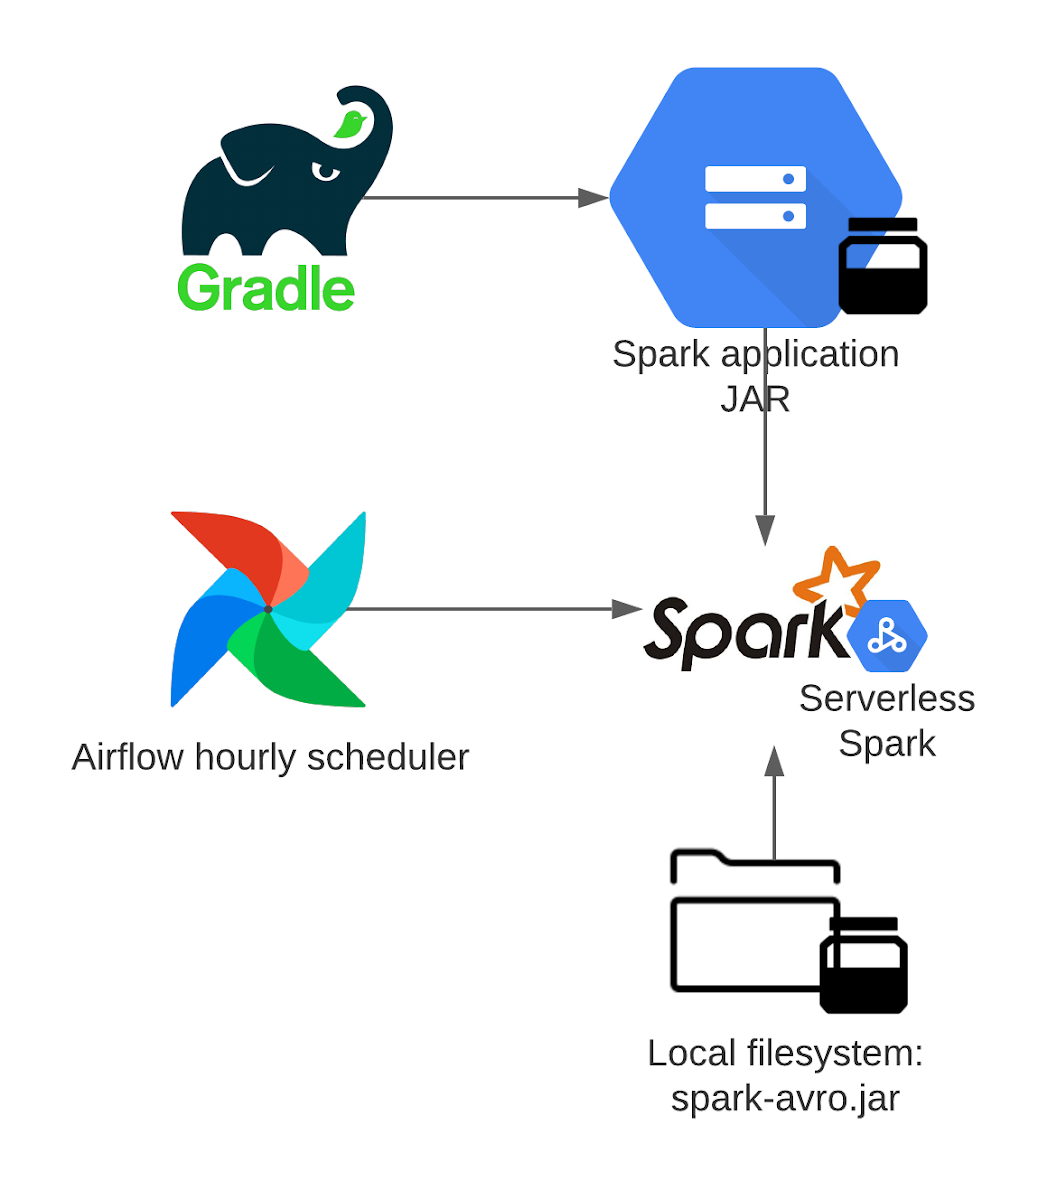
Airflow Kubernetes 작업자는 플로우를 설정하기 위해 워크로드 아이덴티티에 할당됩니다. 워크로드 아이덴티티는 Airflow의 DataprocCreateBatchOperator 플러그인을 사용하여 Dataproc 서버리스 일괄 서비스에 작업을 제출합니다. 일괄 작업은 맞춤형 서비스 계정에 할당되고 Spark 애플리케이션 jar은 Gradle 플러그인을 사용하여 Google Cloud Storage에 제공됩니다. Dataproc 배치가 여기서 jar을 직접 로드할 수 있기 때문입니다. 또 다른 작업 종속 항목(Spark-Avro)은 드라이버나 작업자 파일 시스템에서 로드됩니다. 시간별 데이터 크기가 하루 중 변하기 때문에 이후 배치 작업은 처음에 실행기 100개(1vCPU + 4GB RAM)의 크기로 시작하여 자동 확장 처리가 필요에 따라 리소스를 추가합니다.
BigQuery를 통한 서버리스 Spark(미리보기)
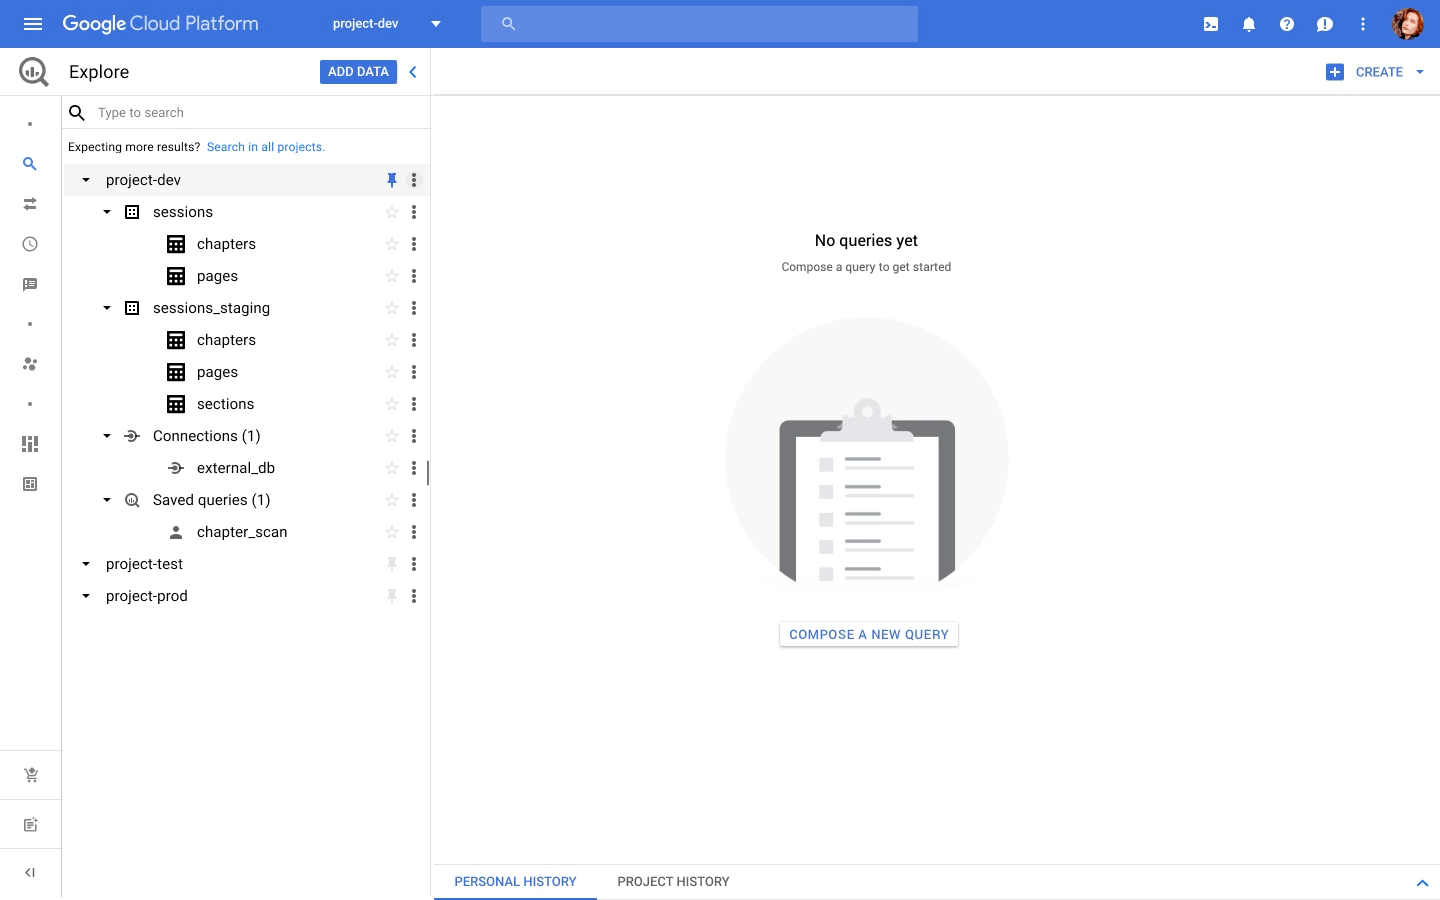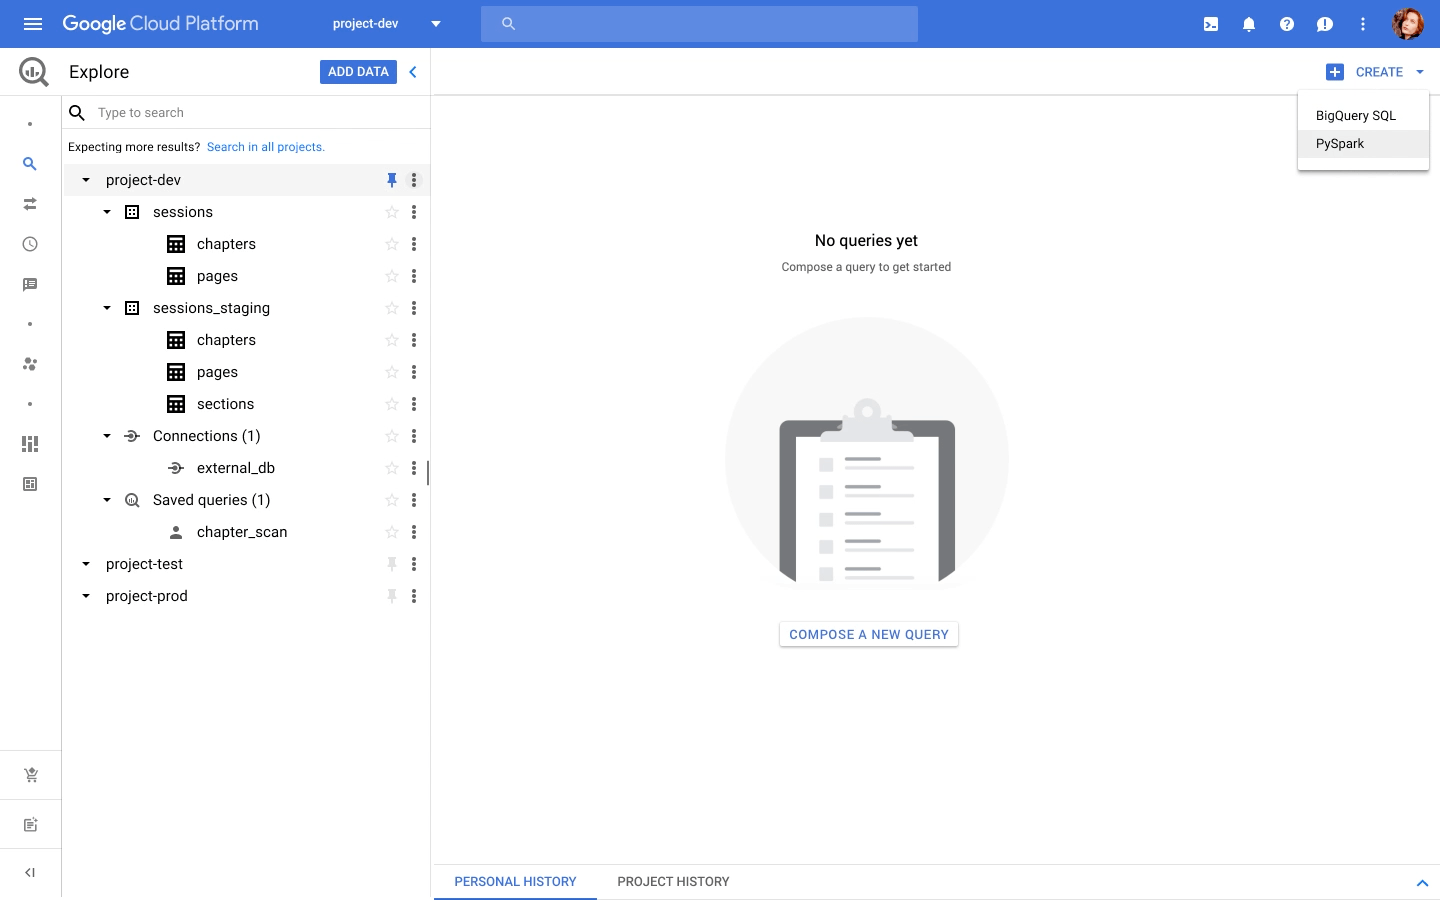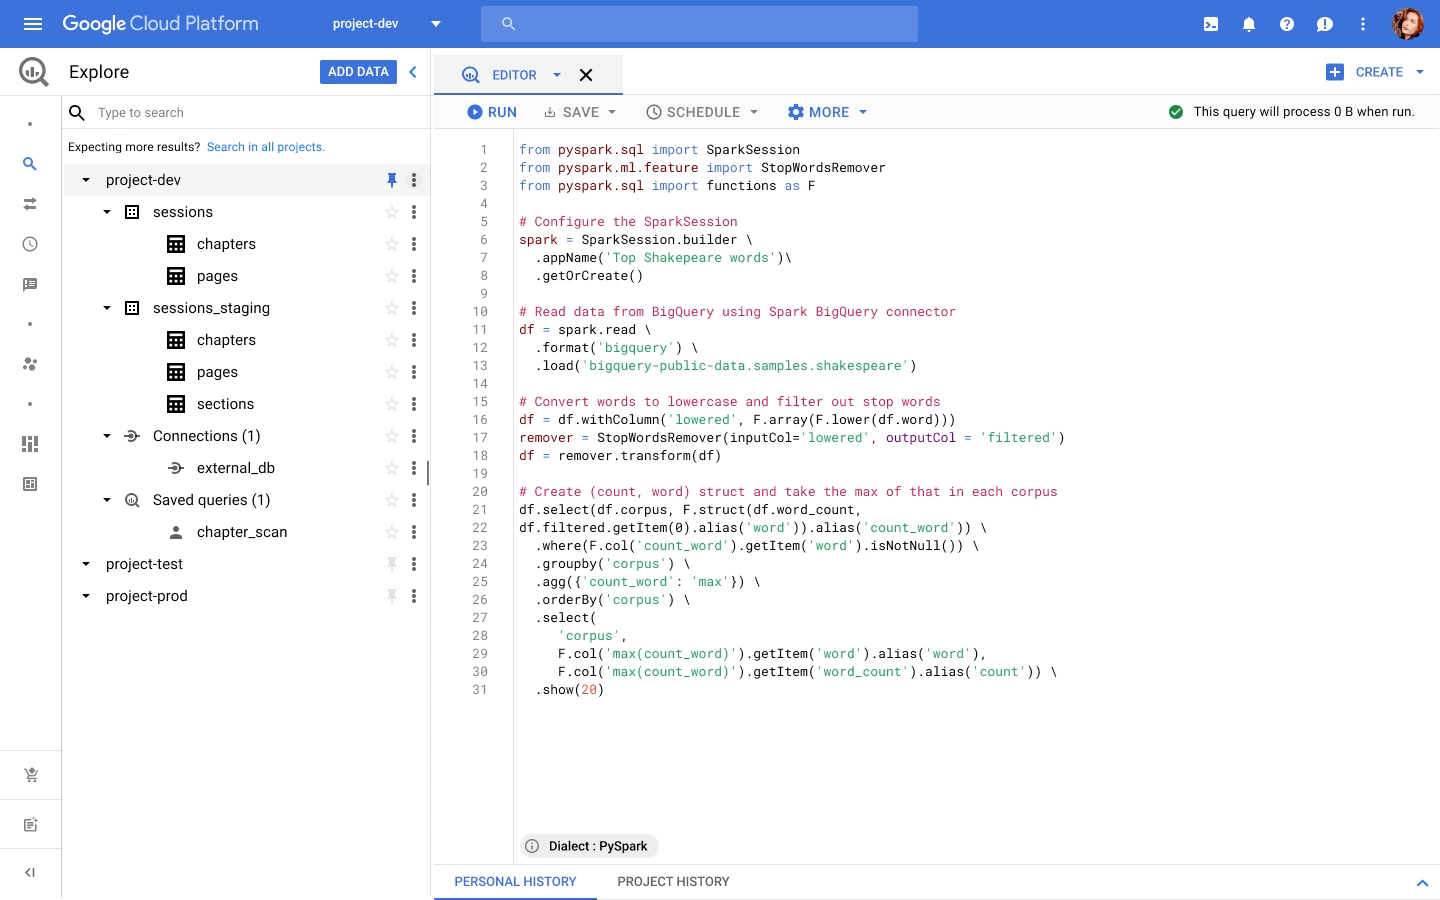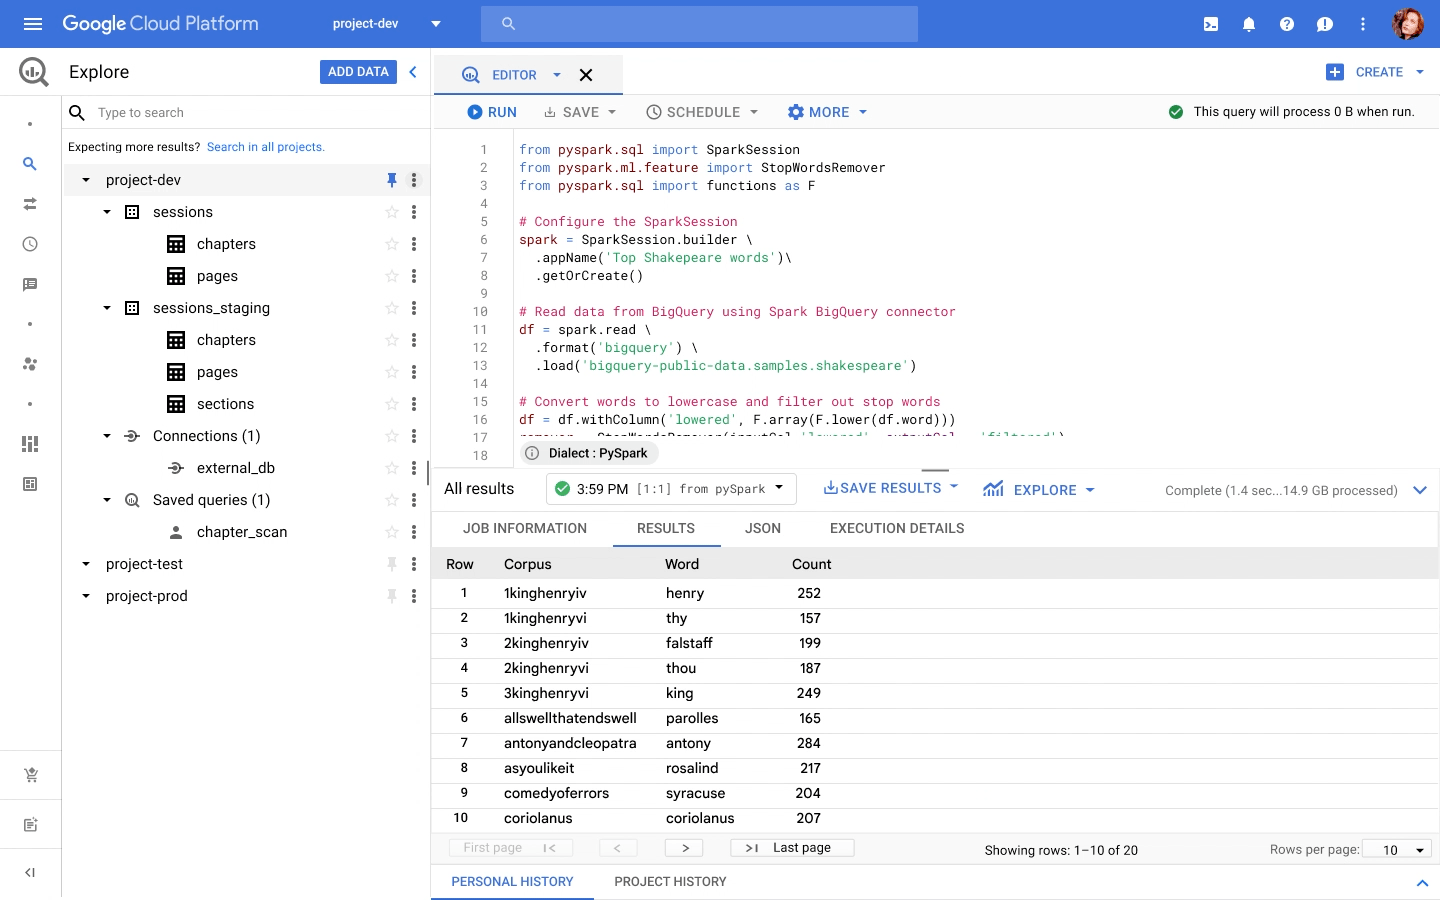
NEXT에서 BigQuery가 SQL이나 PySpark를 작성하기 위한 데이터 분석가용 통합 인터페이스를 추가한다고 발표했습니다. 현재 미리보기가 제공되어 등록 양식을 통해 액세스를 요청할 수 있습니다.
BigQuery 편집자에 PySpark 코드를 작성하면, 인프라를 프로비저닝하지 않아도 서버리스 Spark를 사용하여 원활하게 코드가 실행됩니다. BigQuery는 서버리스 데이터 웨어하우징의 선구자 역할을 해왔으며 현재는 Spark 기반 분석을 위한 서버리스 Spark를 지원합니다.
다음 단계
사용자가 다양하게 사용할 수 있는 인터페이스를 갖춘 서버리스 Spark를 통합하여 인프라를 먼저 프로비저닝하지 않고 Spark를 사용할 수 있도록 작업 중입니다. Vertex AI 워크벤치를 통해 데이터 과학자용 서버리스 Spark와 Dataplex를 통해 데이터 분석가용 서버리스 Spark의 공식 출시 소식을 기다리세요. 동일한 등록 양식을 사용할 수도 있습니다.
지금 서버리스 Spark와 BigQuery를 통한 Spark를 시작하세요
이 튜토리얼이나 공통 ETL 작업용 템플릿 중 하나를 사용하여 서버리스 Spark를 사용할 수 있습니다. BigQuery를 통한 Spark 미리보기에 등록하려면 이 양식을 사용하세요.