대규모 관리형 Apache Iceberg: Spanner가 Lakehouse 런타임 카탈로그를 지원하는 방법
Vinod Ramachandran
Product Manager
Mina Mikhail
Software Engineering Manager
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
고객이 레이크하우스 아키텍처로 현대화함에 따라 호환되는 엔진 전반에서 공유 데이터 자산을 생성하기 위해 Apache Iceberg와 같은 개방형 형식을 표준으로 채택하고 있습니다. 이를 통해 데이터를 시맨틱 지식으로 전환하고, 선제적인 조치를 취하고, 에이전트 규모로 운영되는 AI 네이티브 레이크하우스를 빌드할 수 있습니다.
레이크하우스의 핵심 구성요소 중 하나는 카탈로그이며, Apache Iceberg 환경에서는 일반적으로 Iceberg REST 카탈로그를 의미합니다. Apache Iceberg 카탈로그는 테이블 포인터를 관리하고, 원자적 커밋을 처리하며, 테이블 위치에 대한 단일 정보 소스 역할을 합니다. 하지만 대규모 엔터프라이즈 조직이 레이크하우스로 전환하며 현대화를 추진함에 따라, 레이크하우스 아키텍처의 핵심 요소로서 확장성과 가용성이 뛰어난 관리형 카탈로그가 필요하다는 사실을 깨닫기 시작했습니다. 이는 에이전트를 통해 쿼리 규모가 확장될수록 더욱 중요해집니다. 에이전트의 수많은 반복적인 소규모 쿼리를 지원하려면 원자성, 일관성, 가용성, 동시 실행을 대규모로 제공하는 관리형 카탈로그를 기반으로 시스템을 구축해야 합니다.
이 블로그에서는 에이전트 규모의 최신 클라우드 환경에서 관리형 카탈로그가 직면하는 과제를 살펴보고 Google Cloud의 서버리스 Lakehouse 런타임 카탈로그가 이러한 과제를 해결하는 데 어떻게 도움이 되는지 보여줍니다. 사실상 무제한으로 확장되는 Google Cloud의 상시 가동 데이터베이스인 Spanner를 기반으로 하며, 개방형 Apache Iceberg REST 카탈로그 사양에 맞춰 빌드된 Lakehouse 런타임 카탈로그는 에이전트 시대에 필요한 확장성과 가용성이 뛰어난 기반을 제공합니다.
레이크하우스에서 관리형 카탈로그가 해결해야 하는 과제
레이크하우스에서 대규모 프로덕션 분석을 운영하는 데이터 엔지니어 및 인프라 리드와 이야기를 나누다 보면 다음과 같은 핵심 고충 사항이 공통적으로 나타납니다. 이러한 문제는 관리형 카탈로그를 통해 반드시 해결해야 할 과제입니다.
원자적 커밋 및 동시 실행 제어: Iceberg는 낙관적 동시 실행 제어(OCC)를 통해 ACID 트랜잭션을 보장합니다. 관리형 카탈로그는 현재 메타데이터 포인터를 교체하기 위해 어떠한 오류도 허용하지 않는 완벽한 원자적 비교 및 바꾸기(CAS) 작업을 구현해야 합니다.
고가용성 및 운영 유지보수: 카탈로그가 다운되면 쿼리가 즉시 실패하므로 관리형 카탈로그는 중요한 Tier-1 서비스가 됩니다.
카탈로그를 지원하는 데이터베이스 확장: 카탈로그 설계자는 일반적으로 테이블 메타데이터와 상태를 위한 지원 데이터베이스를 선택할 때 어려운 절충점에 직면합니다. 기존의 수직 확장 관계형 데이터베이스는 SQL 및 ACID 트랜잭션을 제공하지만, 동시 읽기/쓰기 부하가 심해지면 CPU, 메모리, 스토리지, 연결 등 물리적 한계에 부딪히게 됩니다. 이를 해결하기 위해 수동으로 샤딩하면 막대한 운영 오버헤드가 발생합니다. 반면, 수평 확장 데이터베이스 시스템은 eventual consistency를 갖거나, 관리가 어렵거나, 엔터프라이즈 환경에 적합하지 않는 등의 여러 문제를 안고 있는 경우가 많습니다.
테이블 유지보수 조정: 카탈로그만으로는 데이터를 최적화할 수 없습니다. 압축, 스냅샷 만료, 매니페스트 재작성, 분리된 파일 정리를 위한 보조 파이프라인을 빌드하고 운영해야 합니다.
거버넌스 및 보안: 카탈로그는 보안 게이트키퍼 역할을 합니다. 카탈로그는 다음 사항을 구현하고 관리해야 합니다.
-
인증 프로토콜(예: OAuth2 토큰 교환, IAM 제휴)
-
네임스페이스 및 테이블 수준까지 액세스 제어
-
판매된 스토리지 사용자 인증 정보(예: 쿼리 엔진에 광범위하고 직접적인 스토리지 사용자 인증 정보가 필요하지 않도록 단기 토큰 생성)
Lakehouse 런타임 카탈로그
이러한 과제를 해결하기 위해 Google Cloud는 Iceberg REST 카탈로그를 지원하는 Lakehouse 런타임 카탈로그(정식 버전)를 빌드했습니다. Lakehouse 런타임 카탈로그는 Apache Iceberg와 같은 최신 개방형 테이블 형식을 지원하도록 처음부터 설계된 완전한 서버리스 기반의 고가용성 통합 메타데이터 레지스트리입니다. Lakehouse 런타임 카탈로그는 Apache Iceberg REST 카탈로그 사양을 기본적으로 구현하여 메타데이터 검색을 컴퓨팅 엔진에서 분리함으로써 여러 Iceberg 호환 엔진이 공유 데이터 자산에 액세스할 수 있도록 보장하고 워크로드를 더 빠르게 프로덕션으로 전환할 수 있도록 지원합니다. Google Cloud는 많은 고객이 관리형 카탈로그를 원활하게 마이그레이션할 수 있도록 지원해 왔습니다. 예를 들어 Etsy는 자사 카탈로그를 Lakehouse 런타임 카탈로그로 마이그레이션하여, 데이터를 이동 없이 조인함으로써 파이프라인 쿼리 속도를 60% 향상했습니다.
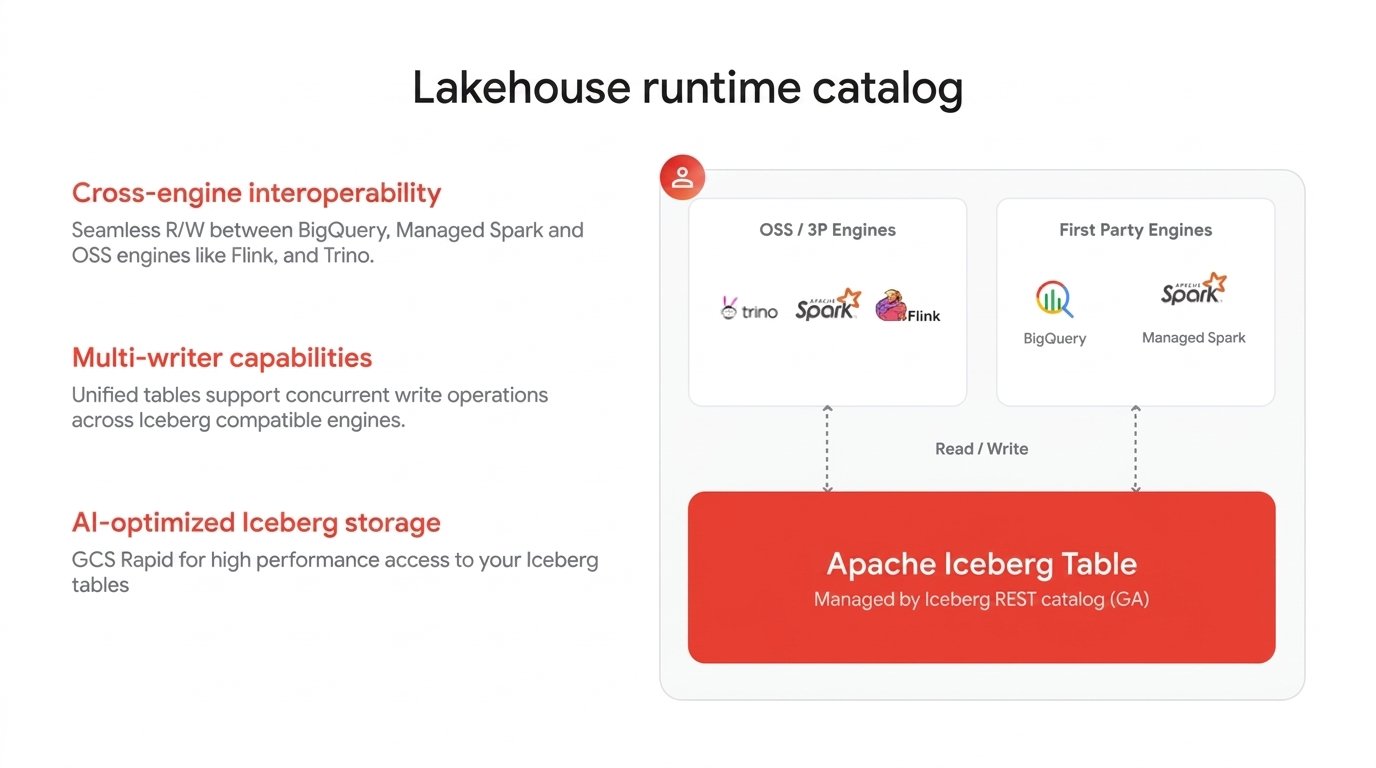
이 방법은 다음과 같은 여러 가지 아키텍처 이점을 제공합니다.
-
개방형 API: Iceberg REST 카탈로그를 지원하므로 여러 팀이 단일 통합 데이터 세트에서 각자 선호하는 분석 도구를 사용할 수 있습니다.
-
멀티 엔진 상호 운용성: 등록된 테이블은 표준 REST 인터페이스를 통해 Google Cloud Managed Service for Apache Spark, BigQuery, 오픈소스 엔진 전반에서 즉시 검색하고 쿼리할 수 있습니다.
-
Iceberg 테이블의 읽기/쓰기 상호 운용성: BigQuery, Managed Spark와 같은 Iceberg 호환 엔진을 활용하여 Lakehouse 런타임 카탈로그에 등록된 Iceberg 테이블에 데이터를 기록할 수 있습니다. 고객은 Managed Spark를 사용하여 외부 카탈로그에 있는 Iceberg 테이블에 데이터를 기록할 수도 있습니다.
-
엔터프라이즈급 기능을 갖춘 완전 관리형 Iceberg 스토리지: Google의 차별화된 인프라를 사용하여 Iceberg 테이블에서 성능을 갖춘 분석을 실행합니다. 이를 통해 오픈소스의 유연성뿐만 아니라 성능, 확장성, 거버넌스, 멀티모달 처리의 이점을 누릴 수 있습니다.
-
데이터 복사 없음: 테이블 정의가 기본 객체 스토어의 기존 데이터를 직접 가리킵니다. 기본 데이터를 이동하거나 재작성하거나 복제할 필요가 없습니다.
-
클라우드 전반의 양방향 카탈로그 제휴:벤딩된 사용자 인증 정보 및 OIDC 토큰 교환을 지원하여 Databricks Unity, Snowflake Horizon, AWS Glue의 데이터에 액세스합니다. 이를 통해 Google AI를 AWS 및 Azure 데이터에 직접 적용할 수 있습니다.
-
사용자 인증 정보 벤더 제공을 사용한 보안 액세스: 카탈로그는 여러 승인 메커니즘을 지원하므로 사용자 인증 정보 벤더 제공과 최종 사용자 인증 정보 중에서 선택할 수 있습니다. 즉, 기본 객체 스토어(Cloud Storage, AWS S3, Azure Blob Storage)의 파일에 직접 액세스할 필요 없이 사용자 인증 정보 벤더 제공 같은 최신 메커니즘을 사용하여 테이블에 액세스할 수 있습니다.
-
AI 기반 컨텍스트 및 거버넌스: Lakehouse 런타임 카탈로그는 Knowledge Catalog 및 Cloud IAM과 직접 통합되므로 에이전트에 대한 신뢰할 수 있는 컨텍스트를 정의하고 모든 컴퓨팅 엔진에 테이블 수준 보안을 일관되게 적용할 수 있습니다. 카탈로그에서 Iceberg 테이블에 대한 즉시 사용 가능한 검색, 계보, 인사이트를 얻을 수 있습니다.
-
원자적 커밋 및 동시 실행 제어, 고가용성 및 확장성: Google의 전 세계 규모 인프라와 Spanner를 기반으로 데이터와 함께 메타데이터를 확장하는 데 필요한 고가용성, 동시 실행, 확장성을 확보할 수 있습니다. Cloud Storage 이중 리전 및 멀티 리전 버킷을 지원하여 장애 조치 사용 사례를 지원합니다. 또한 서버리스와 노옵스(no-ops) 환경을 통해 TCO가 절감되고 모든 워크로드 규모에 맞게 확장할 수 있습니다.
Lakehouse 런타임 카탈로그의 원동력
Lakehouse 런타임 카탈로그는 Spanner를 기반으로 빌드되어 strong consistency가 보장되는 가용성이 높고 동시 실행 및 확장성이 뛰어난 카탈로그입니다. 수직적 단일 노드 한계에 부딪히는 기존의 수직 확장형 관계형 데이터베이스와 달리, Spanner는 완전한 관계형 SQL 시맨틱 및 멀티 테이블 ACID 트랜잭션을 NoSQL 시스템의 장점인 읽기와 쓰기 모두에 대한 수평 확장 탄력성과 결합했습니다.
Spanner는 최대 99.99%의 가용성을 제공하는 Spanner의 리전 구성을 통해 Lakehouse 런타임 카탈로그의 가용성을 높입니다. 또한 Spanner는 Lakehouse 런타임 카탈로그에 즉시 사용 가능한 확장성을 제공합니다. 수평 확장 가능한 데이터베이스인 Spanner는 수동 샤딩이 필요하지 않으며 컴퓨팅과 스토리지를 독립적이고 투명하게 확장합니다. Spanner는 데이터 볼륨과 쿼리 부하를 동적으로 모니터링하여 데이터 범위를 분할하고 노드 간에 재배포합니다. 컴퓨팅 노드는 CPU 사용률과 스토리지 기준점에 따라 동적으로 확장됩니다. Spanner는 분할 수준의 과부하를 자동으로 감지하여, 부하가 집중된 노드에서 사용량이 많은 분할을 다른 곳으로 알아서 이동해 줍니다. 또한 Spanner를 사용하면 Lakehouse 런타임 카탈로그 사용자가 관계형 일관성과 분산 확장성 간의 기존 절충점을 극복하고, Lakehouse 런타임 카탈로그의 업계 선도적인 일관성 보장 기능을 활용할 수 있습니다. Lakehouse 트랜잭션은 직렬화가 가능합니다. 데이터베이스 내 트랜잭션 순서는 클라이언트가 커밋된 트랜잭션을 관찰하는 순서와 동일합니다. 이러한 기반을 통해 Lakehouse 사용자는 에이전트 규모로 운영할 수 있습니다.
또한 에이전트 사용 사례를 더욱 강화하기 위해 Lakehouse 런타임 카탈로그는 Knowledge Catalog와 직접 통합되어 레이크하우스 Iceberg 테이블을 쉽게 검색하고 에이전트에 신뢰할 수 있는 컨텍스트를 제공합니다. Knowledge Catalog는 Spanner에서 제공하는 전체 텍스트 검색과 기본 벡터 검색의 효율적인 조합을 활용합니다. 이러한 접근 방식을 사용하면 단일 쿼리에서 어휘 키워드 검색과 시맨틱 임베딩을 페어링하여 검색 재현율을 높일 수 있습니다. 두 색인 유형 모두 동일한 기본 데이터 세트를 기반으로 빌드되므로, 기본 테이블 DML 작업과 동시에 엄격한 트랜잭션 ACID 일관성을 유지하며 업데이트됩니다. 이를 통해 동기화 파이프라인, 외부 벡터, 전체 텍스트 검색 시스템 관리와 같은 운영 오버헤드를 줄일 수 있습니다. 요약하자면, Lakehouse 런타임 카탈로그를 통해 에이전트형 사용 사례의 출시 기간(TTM)을 단축할 수 있습니다.
분석 워크로드와 운영 워크로드 결합
Apache Iceberg를 기반으로 하는 Google Cloud의 경계 없는 레이크하우스를 사용하면 분석 데이터를 운영 워크로드와 결합할 수 있습니다. 사용 사례로는 레이크하우스의 데이터 애셋을 OLTP 데이터(Spanner)와 결합하여 분석하는 것부터, Spanner와 같은 운영 데이터베이스에서 레이크하우스 애셋에 액세스할 수 있는 지연 시간이 짧은 서빙 애플리케이션, 퍼스트 파티 및 서드 파티 에이전트의 대화형 분석에 이르기까지 다양합니다.
아래 예시를 통해 Spanner와 결합된 Lakehouse 런타임 카탈로그가 실제로 어떻게 작동하는지 확인할 수 있습니다. 여기서는 Apache Iceberg를 기반으로 하는 맨해튼 택시 운행 분석 데이터와 Spanner에 저장된 택시 구역 운영 데이터를 결합하여 가장 혼잡한 교통 경로를 찾아봅니다. 또한 이 예시에서는 대화형 분석 에이전트를 사용하여 동일한 데이터에 액세스하고 2차 인사이트를 얻을 수 있음을 보여줍니다.
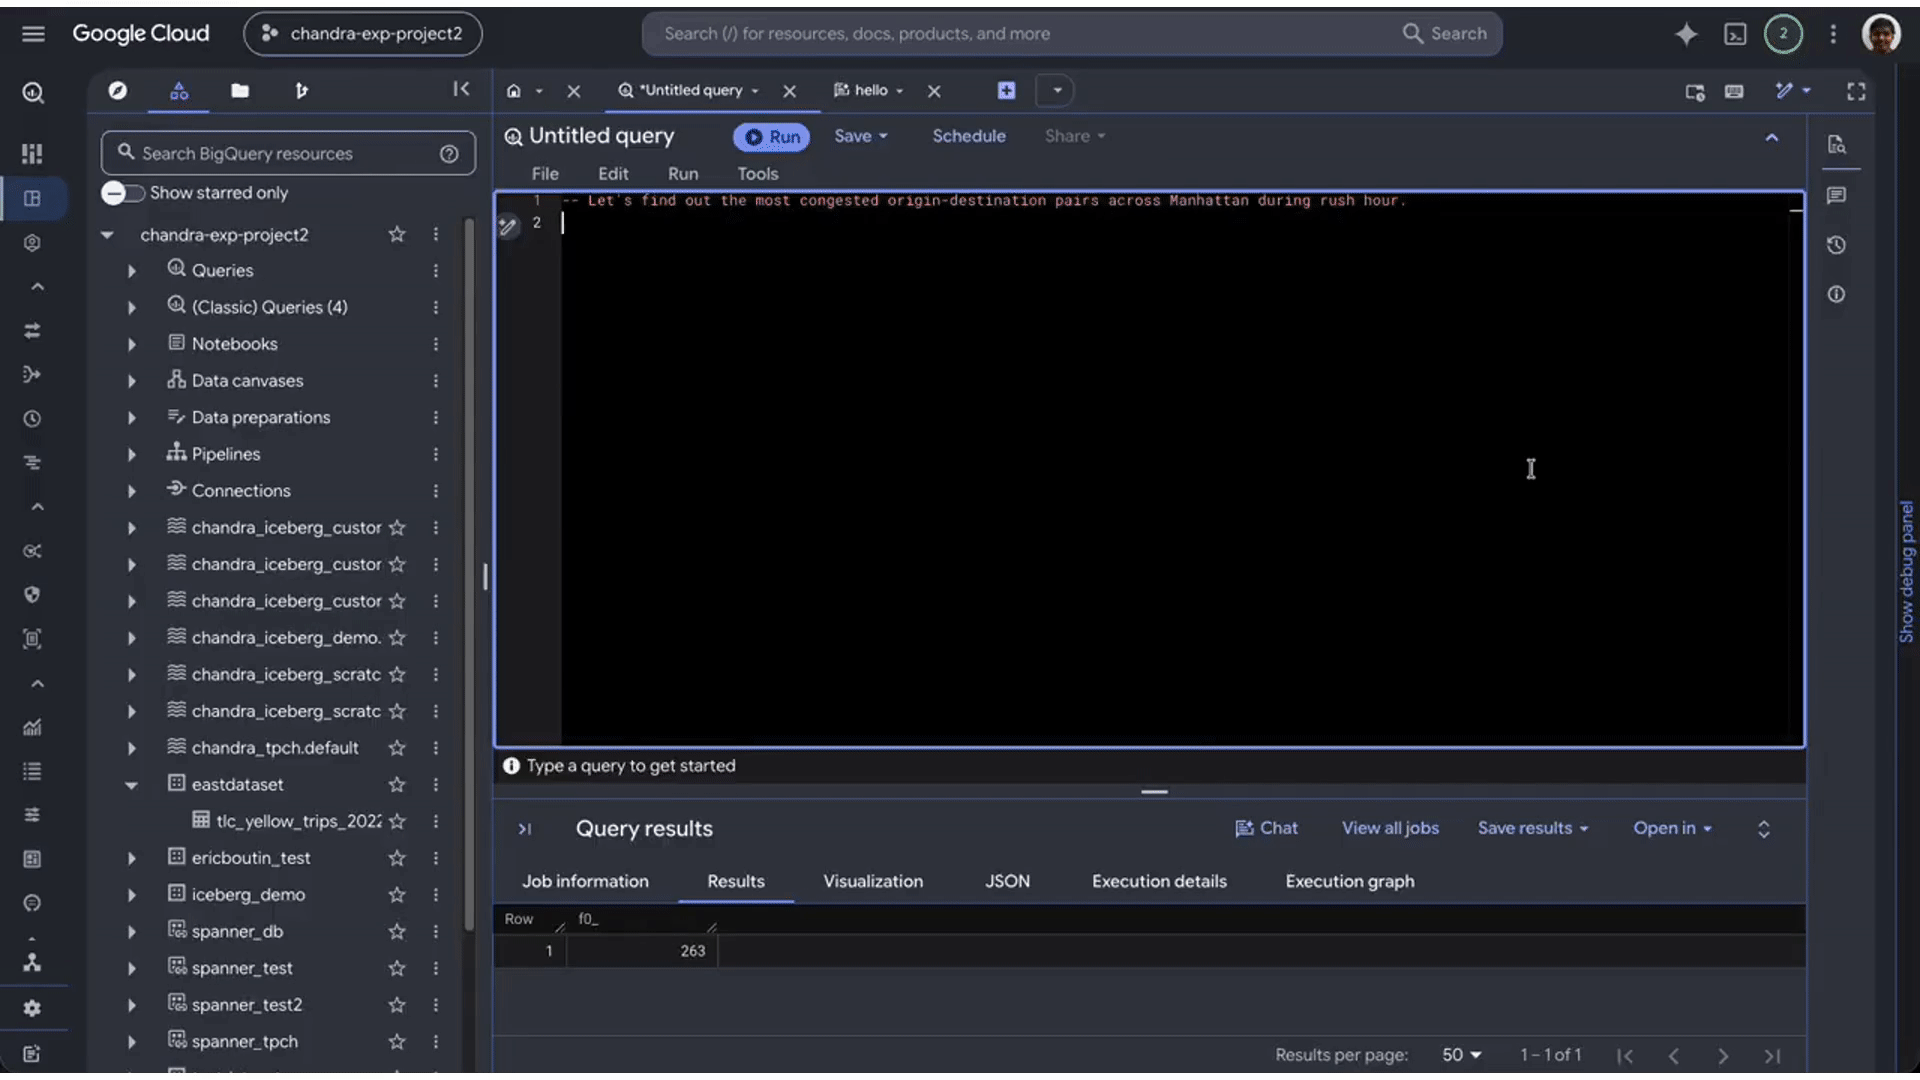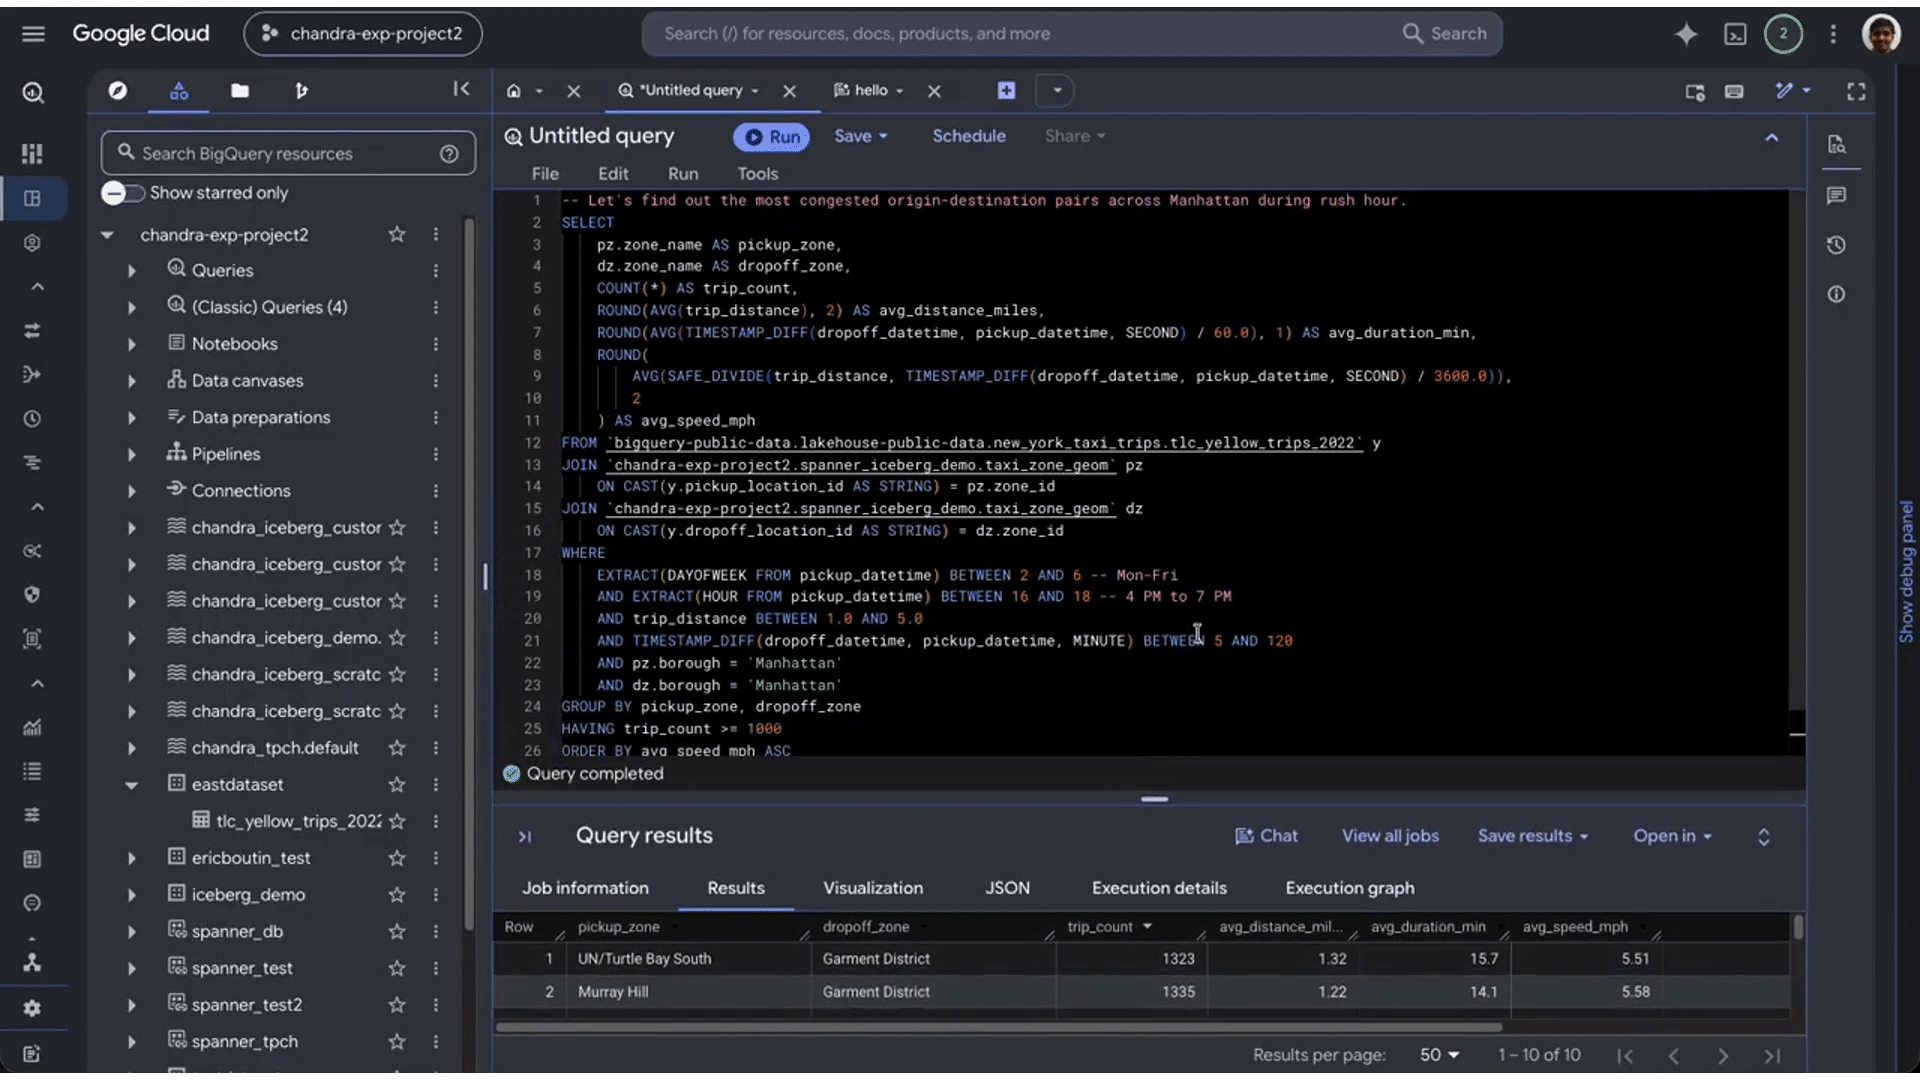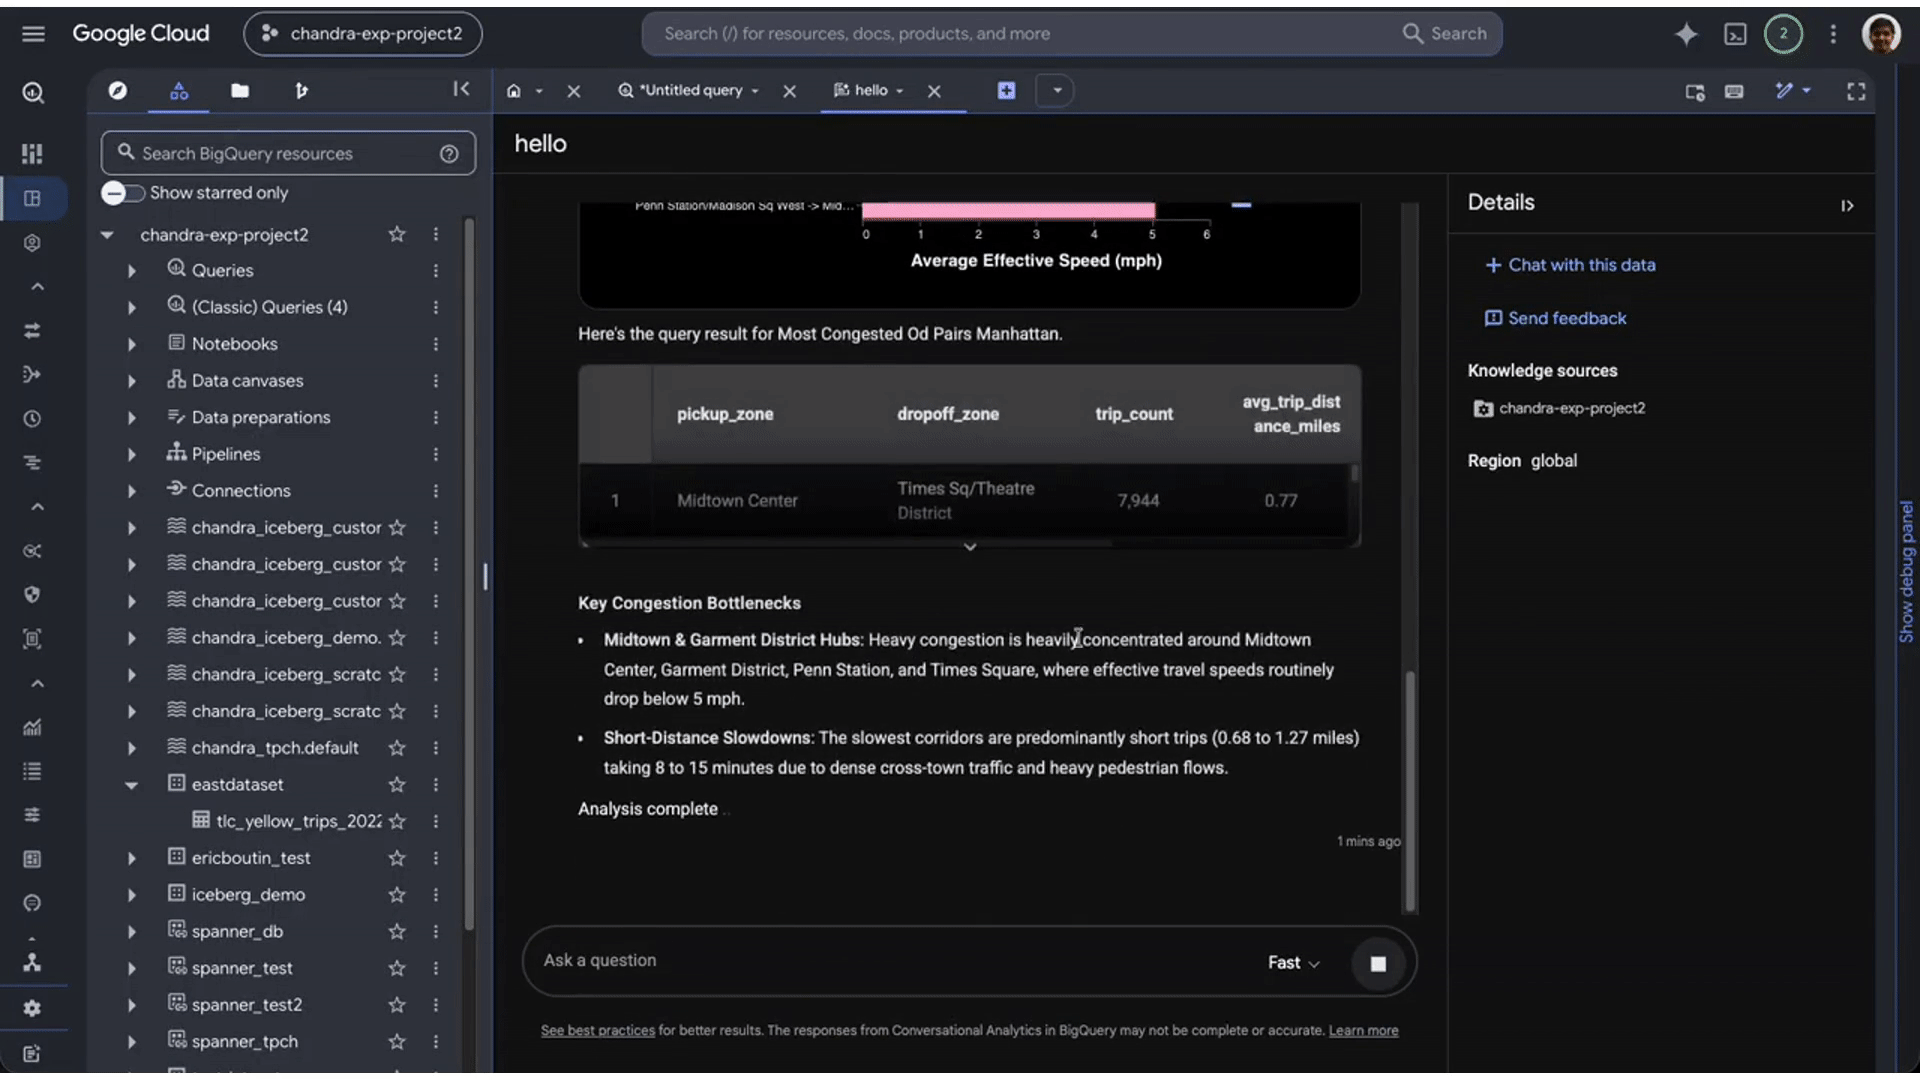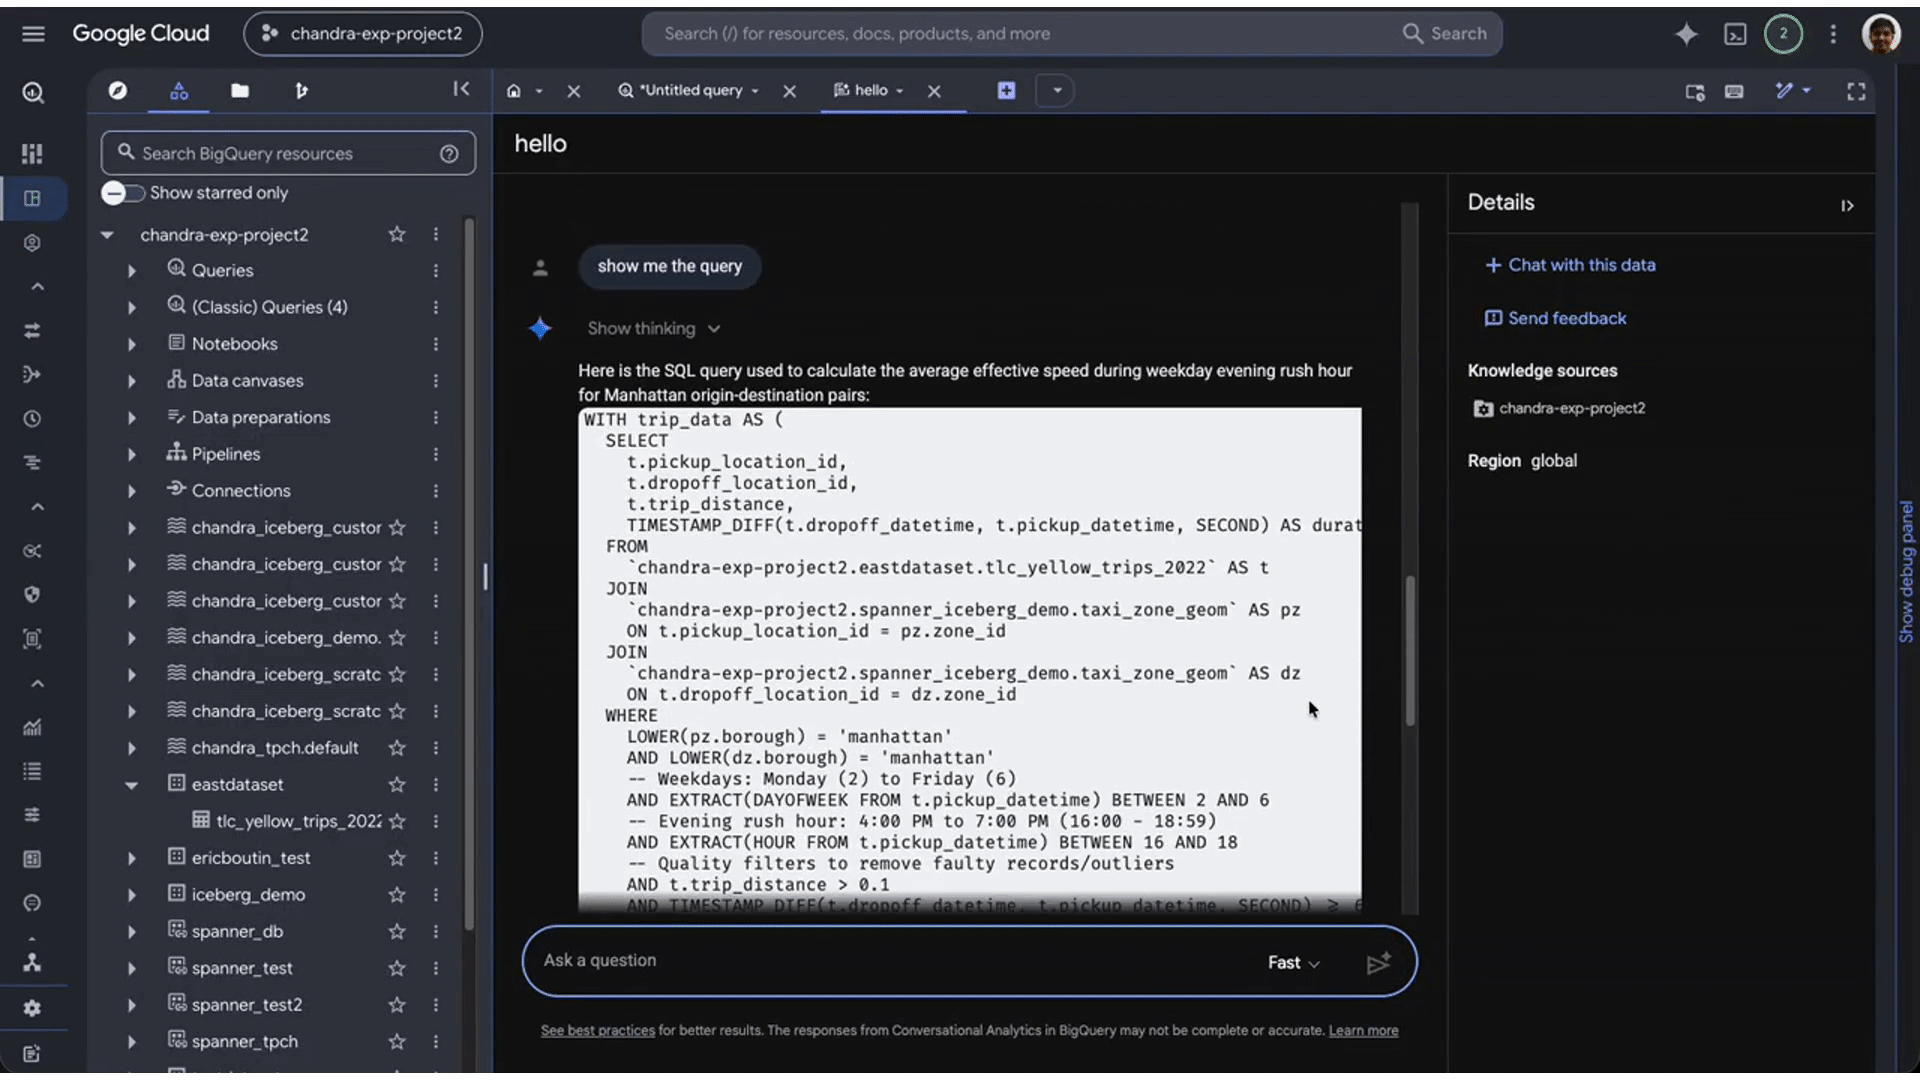
맨해튼에서 가장 정체가 심한 교통 경로 확인하기