Gemini를 위한 혁신적인 기능으로 에이전트 시대에 맞는 경계 없는 Lakehouse 도입
Gaurav Saxena
Director, Product Management
Ahmet Altay
Director, Engineering
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
기업이 AI 사용을 실험적인 챗봇에서 자율형 에이전트로 전환함에 따라, 기업의 각 팀은 여러 클라우드, SaaS 플랫폼, 온프레미스 시스템에 분산된 데이터에 액세스하고 이를 바탕으로 추론하는 과정에서 심각한 병목 현상을 겪고 있습니다. AI 에이전트를 진정한 작업 시스템으로 전환하려면 조직은 데이터 이동으로 인한 보안 위험 없이 페타바이트 규모의 추론을 처리할 수 있는 기반이 필요합니다. 지난주에 열린 Gemini at Work 이벤트에서 Google은 Gemini가 비즈니스 워크플로를 완전히 바꾸는 데 어떤 도움이 되는지 발표하는 시간을 가졌습니다. 기업에서 보유한 데이터를 활용해 에이전트의 역량을 강화할 수 있도록, Gemini와 경계 없는 Lakehouse의 통합이라는 새로운 기능을 자세히 알아보겠습니다. 이러한 통합을 통해 데이터 환경 전반에서 가동되는 에이전트를 빌드하고, 보호하고, 확장할 수 있습니다.
Gemini를 통해 Google Cloud 외부에 있는 데이터에 액세스하기
경계 없는 Lakehouse의 진정한 가치는 조직의 업무 방식을 완전히 바꿀 에이전트를 빌드하여 실현되며, 이 과정에서 Gemini가 진입점 역할을 합니다. Gemini 통합 기능이 새롭게 지원되므로, 사전 구성되거나 경계 없는 Lakehouse에 저장된 데이터가 이제 Gemini에 직접 통합됩니다. 현재 프리뷰 버전으로 제공되는 이 기능을 사용하면 Gemini에서 바로 Lakehouse 카탈로그 제휴를 통해 Databricks Unity Catalog 또는 Snowflake Horizon과 같은 새로운 데이터 소스에 대한 액세스 권한을 설정할 수 있습니다.
이제 비즈니스 사용자는 자연어를 사용해 여러 클라우드에 있는 레코드를 쿼리할 수 있으며, AI 에이전트는 동일한 데이터를 기반으로 추론하고 코드를 작성할 수 있습니다. 그리고 이 모든 작업이 데이터를 이동하지 않고도 이루어집니다. 경계 없는 Lakehouse 전반에서 AI 에이전트를 직접 컨텍스트화하면 조직의 AI 도입을 가속화하는 동시에 중요한 정보에 대한 액세스 절차를 간소화할 수 있습니다.
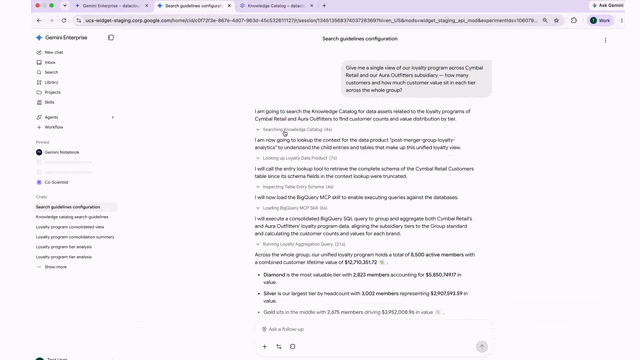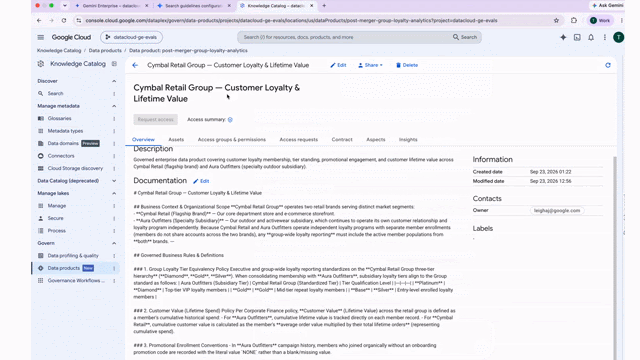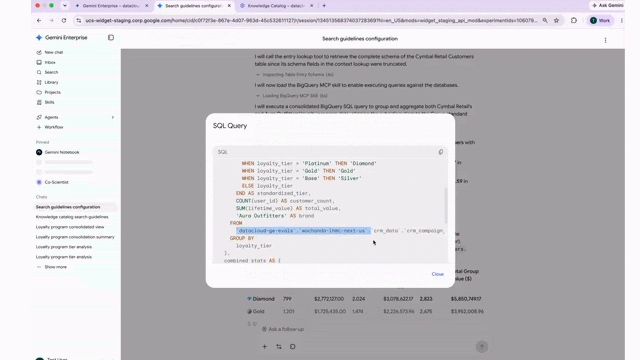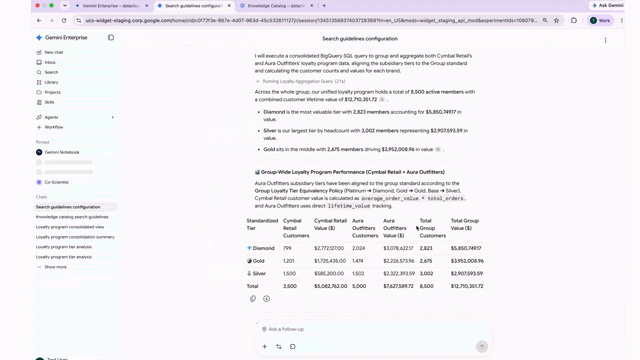
비즈니스 사용자가 호출한 Gemini 에이전트는 BigQuery 및 Databricks Unity Catalog에 있는 데이터에 액세스하여 포괄적인 보고를 제공하고 자연어를 사용해 유용한 정보를 얻을 수 있습니다.
경계 없는 Lakehouse의 고급 기능
이번에 선보이는 새로운 기능인 Gemini와의 기본 통합 외에도, 올해 초에 도입된 다음과 같은 여러 기능이 이제 정식 버전으로 제공된다는 소식을 전해드립니다. 이를 통해 경계 없는 Lakehouse로 데이터 기반을 강화할 수 있습니다.
-
AWS 및 Azure용 Cross-Cloud Interconnect 및 크로스 클라우드 캐싱 지원
-
Apache Iceberg V3 사양에 대한 BigQuery 지원
-
BigQuery 및 Managed Service for Apache Spark 모두에 지원되는 Apache Iceberg 테이블의 읽기-쓰기 상호 운용성
-
Lakehouse 런타임 제휴를 사용한 AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog와의 양방향 캐싱
-
Knowledge Catalog와의 통합
-
Salesforce, SAP, Workday, 그리고 이제 Confluent Tableflow와의 제로 카피 데이터 통합
-
Dataflow를 사용하여 Lakehouse 콘솔을 통해 Databricks Delta Lake 자산 동기화
지금부터 자세히 살펴보겠습니다.
페타바이트 규모의 성능과 추론
에이전트 컨텍스트 윈도우는 일반적으로 한 번에 수백 킬로바이트를 수집하는 것으로 제한되지만, 엔터프라이즈 워크플로는 간혹 클라우드 전반에서 페타바이트 규모의 데이터를 조인하는 경우가 있습니다. 제품 및 고객 데이터와 같은 여러 소스의 데이터를 CRM 클라우드 및 웨어하우스 원격 분석에 결합해야 하는 에이전트 네이티브 데이터 플랫폼은 대규모 데이터를 처리할 수 있어야 합니다. MCP를 통해 이 작업을 수행하면 컨텍스트 윈도우와 페이로드 크기로 인해 메가바이트 규모로 제한됩니다. 데이터 및 AI 스택의 모든 레이어에서 통합되는 경계 없는 Lakehouse는 엔터프라이즈급 확장성을 제공하여, 에이전트가 페타바이트 규모의 데이터를 로컬에 저장된 것과 유사한 성능으로 추론할 수 있도록 합니다.
네트워킹 계층에서 Cross-Cloud Interconnect와 크로스 클라우드 캐싱은 AWS 및 Azure로 연결되는 처리량이 높고 지연 시간이 짧은 경로를 제공하여 가변적인 이그레스 비용을 없앱니다. 에이전트가 Amazon Azure Data Lake Storage의 Iceberg 테이블을 BigQuery의 데이터와 조인할 경우, 캐시되지 않은 모든 바이트를 스캔할 때마다 클라우드 경계를 넘나들기 때문에 결국 네트워크가 작업 처리 속도를 좌우하게 됩니다. Cross-Cloud Interconnect는 Google Cloud와 AWS 또는 Azure 간의 전용 비공개 연결을 Lakehouse에 제공하며, 연결당 10Gbps 또는 100Gbps의 속도를 지원합니다. Lakehouse 쿼리는 공개 인터넷이 아닌 이 연결을 통해 이동하므로 지연 시간이 짧고 예측 가능합니다. 크로스 클라우드 캐싱은 Google Cloud 내부에서 반복 읽기를 지원하므로 에이전트는 다른 클라우드의 데이터를 마이그레이션하지 않고도 쿼리할 수 있습니다.
경계 없는 Lakehouse에는 Iceberg 메타데이터를 쿼리 엔진 내에 통합하기 위한 몇 가지 주요 최적화 기능이 포함되어 있습니다. 이제 BigQuery에서 바이너리 삭제 벡터 및 정렬 순서를 비롯한 Apache Iceberg V3 사양을 지원합니다. 이러한 기능을 통해 엔진은 전체 데이터 파일을 다시 작성할 필요 없이 행 수준 업데이트와 삭제를 더 효율적으로 처리할 수 있습니다. 또한 새로운 FlatBuffers 기반 Parquet 리더와 병렬화된 I/O로 BigQuery의 실행 엔진을 업그레이드하여 CPU 오버헤드와 직렬화 병목 현상을 줄이고, 개방형 형식과 기본 스토리지 간의 성능 격차를 좁혔습니다.
이러한 기능은 에이전트 워크로드를 지원하도록 설계된 쿼리 엔진의 최근 성능 혁신을 기반으로 합니다. 에이전트 워크로드는 종종 대량으로 발생하며 작은 쿼리를 빠르고 비용 효율적으로 처리해야 합니다. BigQuery의 유연한 확장 및 기록 기반 최적화를 사용하면 Apache Iceberg와의 개방성을 유지하면서 확장 가능하고 효율적인 에이전트 워크로드를 실행할 수 있습니다.
한편, BigQuery와 Managed Service for Apache Spark 양쪽 모두에서 Apache Iceberg 테이블에 대한 읽기-쓰기 상호 운용성을 지원하므로 모든 데이터팀이 Google Cloud Storage에서 동일한 Iceberg 테이블을 쉽게 사용할 수 있습니다. 이렇게 수직적으로 최적화된 스택은 BigQuery와 Lightning Engine의 강력한 기능을 활용하여 데이터를 이동하지 않고도 데이터를 활성화하므로 에이전트를 더 빠르고 비용 효율적으로 사용할 수 있습니다. Lakehouse에서 더 심층적으로 분석하고자 할 경우 BigQuery의 Iceberg에 대한 그래프 지원을 활용하면 관계 네트워크(예: 공급망)를 개방형 테이블 데이터 세트에서 직접 분석할 수 있습니다.
에이전트를 위한 포괄적인 컨텍스트와 데이터 액세스
액세스할 수 있는 컨텍스트가 있어야 AI 에이전트도 스마트한 기능을 발휘할 수 있습니다. 경계 없는 Lakehouse는 할루시네이션을 방지하고 메타데이터 레이어의 정확성을 개선하기 위해 Lakehouse 런타임 카탈로그를 사용하여 엔터프라이즈 데이터를 통합합니다. Apache Iceberg REST 카탈로그를 기반으로 AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog와 양방향 카탈로그 제휴를 제공합니다. Lakehouse 런타임 카탈로그에는 새로운 표준 Hive Metastore 호환 엔드포인트도 포함되어 있으므로 Apache Spark, Trino, Presto와 같은 엔진이 아키텍처 변경 없이 메타데이터를 검색할 수 있습니다.
경계 없는 Lakehouse는 분산된 데이터 자산의 색인을 자동으로 생성하는 Knowledge Catalog와도 직접 통합됩니다. 따라서 에이전트가 Cloud Storage의 비정형 데이터를 비롯한 전체 엔터프라이즈 코퍼스를 추론하는 데 필요한 정확한 비즈니스 메타데이터와 시맨틱 정의를 제공합니다. 이를 통해 에이전트는 토큰 비용을 제어하면서 정확성을 유지하는 데 필요한 만큼의 컨텍스트를 확보할 수 있으므로 작업자가 지능적이고 지속 가능한 에이전트 전략을 개발하는 데 도움이 됩니다.
경계 없는 Lakehouse는 Salesforce, SAP, Workday와 같은 SaaS 애플리케이션과 제로 카피 데이터 통합을 제공하고 대형 파트너 생태계와 통합하여 Knowledge Catalog에서 엔터프라이즈 데이터를 캡처하고 에이전트를 위한 단일 컨텍스트 엔진 역할을 합니다. 현재 Google Cloud는 이제 정식 버전으로 제공되는 Confluent Tableflow의 새로운 통합을 통해 파트너 생태계를 확장하고 있습니다. 이 통합은 Lakehouse 런타임 카탈로그와 동기화되므로 생성되는 Iceberg 테이블이 복사나 추가 ETL 없이 BigQuery에 직접 표시됩니다.
마지막으로, Databricks 중심 저장소를 사용하는 조직은 이제 Dataflow를 사용하여 Lakehouse 콘솔을 통해 Delta Lake 자산을 Lakehouse로 쉽게 가져오고, 변환하고, 동기화할 수 있습니다.
손쉬운 현대화
2025년 초부터 Apache Iceberg를 사용하는 고객이 3배 이상 증가했으며, Google Cloud의 경계 없는 Lakehouse를 활용하여 데이터 사용 환경을 빌드하는 기업은 다음과 같은 상당한 효과를 보고 있습니다.
-
Etsy는 경계 없는 Lakehouse로 3페타바이트를 통합하여 데이터를 이동 없이 조인함으로써 파이프라인 쿼리 속도를 60% 향상했습니다.
-
Commerzbank는 분산된 원시 데이터 환경을 거버넌스가 적용되고 에이전트가 바로 활용 가능한 데이터 액세스 환경으로 전환했습니다.
-
Hightouch는 경계 없는 Lakehouse와 직접 통합하여 각 팀이 개방형 Iceberg Lakehouse에서 바로 마케팅 업무 역량을 강화하고 Google Cloud 생태계 전반에서 이러한 데이터를 활성화할 수 있게 되었습니다.
-
Roundel은 경계 없는 Lakehouse를 통해 Target Product Ads 기술 스택을 처음부터 끝까지 철저히 현대화하여 데이터 수집, 처리, 측정 파이프라인을 완전히 재구축했습니다.
Borderless Lakehouse로 전환할 준비가 된 조직이라면 어렵지 않게 시작할 수 있습니다. 현재 기존 Dataproc Metastore를 사용 중인 조직을 위해, 이제 서버리스 Lakehouse 런타임 카탈로그로 자동 마이그레이션하는 경로를 제공하며 다운타임이 발생하지 않습니다. 이렇게 하면 기존 스키마와 계보를 보존하면서 경계 없는 Lakehouse의 AI 지원 기능을 활용할 수 있으므로 인프라 관리를 멈추고 에이전트를 활성화할 수 있습니다.
지금 바로 Borderless Lakehouse 빌드 Codelab을 시작하거나 Google 웹사이트를 방문하여 자세히 알아보세요.