O que é a arquitetura medallion?
A arquitetura medallion é um padrão de design de dados usado para organizar dados em um data lake ou lakehouse. O principal trabalho dela é melhorar a qualidade e a estrutura dos dados à medida que eles passam por diferentes estágios. Em vez de ter uma pilha gigante de dados, esse framework os divide em camadas. Cada camada agrega mais valor, tornando os dados mais confiáveis e fáceis de usar para decisões de negócios.
É um modelo lógico, e não um software específico. Ele foi projetado para ajudar as equipes a gerenciar pipelines de dados, garantindo transações ACID (atomicidade, consistência, isolamento e durabilidade). Ao mover os dados por essas camadas de validação, as empresas podem confiar que as informações são precisas e seguras, mesmo ao lidar com grandes quantidades de informações brutas.
Arquitetura Medallion versus armazenamento em data warehouse tradicional
No passado, os data warehouses tradicionais usavam uma abordagem de "esquema na gravação". Isso significa que você tinha que definir perfeitamente a estrutura dos dados antes de salvá-los. Embora isso mantivesse as coisas organizadas, o processo era lento e rígido. Se o formato dos dados mudasse um pouco, todo o sistema poderia parar de funcionar até que um engenheiro o corrigisse manualmente.
A arquitetura medallion segue o paradigma moderno de lakehouse, que adota o "esquema na leitura" na camada de dados brutos. Isso permite que os dados cheguem imediatamente em sua forma bruta. Você só se preocupa com a estrutura quando o valor comercial dos dados fica claro. É uma forma mais flexível de trabalhar que permite às empresas coletar dados agora e decidir exatamente como usá-los mais tarde.
As três camadas da arquitetura medallion
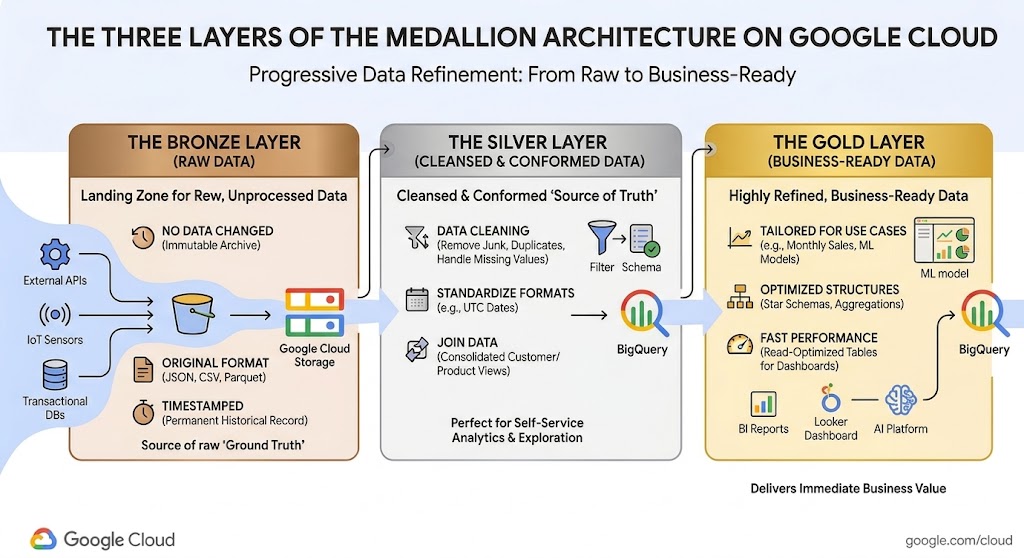
Em uma arquitetura medallion, os dados fluem como um rio por três etapas principais: bronze, prata e ouro. À medida que os dados passam de uma fase para outra, eles ficam mais limpos e organizados. Com essa configuração, os engenheiros podem corrigir erros no início do processo, e diferentes usuários têm acesso à versão correta dos dados para suas tarefas específicas.
Camada bronze (dados brutos)
A camada bronze é a zona de destino para todos os dados recebidos. É aqui que você armazena informações brutas e não processadas de fontes como APIs da web, sensores de IoT ou bancos de dados transacionais. Aqui, você não muda os dados, mas os mantém no formato original, como JSON, CSV ou Parquet.
Os engenheiros costumam adicionar um carimbo de data/hora a esses arquivos para mostrar quando eles chegaram. A camada bronze atua como um arquivo histórico permanente. Se você cometer um erro nos cálculos mais tarde, sempre poderá voltar a esses dados brutos e começar de novo. Isso garante que você nunca perca a "verdade fundamental" das suas operações comerciais.
A camada prata (dados limpos e conformes)
Pense na camada prata como sua "fonte da verdade". Nesta etapa, os dados da camada bronze passam por uma limpeza completa. Os engenheiros usam ferramentas para filtrar lixo, remover registros duplicados e corrigir valores ausentes. Eles também padronizam formatos, como garantir que todas as datas sigam o mesmo padrão.
A camada prata une diferentes conjuntos de dados para criar uma visão clara dos principais itens de negócios, como "clientes" ou "produtos". Essa camada é perfeita para análises de autoatendimento. Ela é simples o suficiente para a maioria das pessoas usar, mas ainda é detalhada o suficiente para responder a uma ampla variedade de perguntas sem se limitar a apenas um relatório específico.
A camada ouro (dados prontos para negócios)
A camada ouro contém os dados mais refinados. Essas informações são adaptadas para necessidades comerciais específicas, como um relatório mensal de vendas ou um modelo de aprendizado de máquina que prevê a desistência de clientes. Em vez de listas brutas, a camada ouro costuma usar "esquemas em estrela" ou tabelas otimizadas para leitura rápida.
Como esses dados já estão agregados e calculados, eles são carregados muito rapidamente nos painéis. Um cientista de dados pode usar uma tabela ouro para ver os "Usuários ativos por dia por região" sem precisar unir milhões de linhas brutas. É o produto final projetado para fornecer valor imediato à empresa.
Principais benefícios da arquitetura de medalhas
Usar uma abordagem em camadas ajuda as equipes a avançar mais rapidamente e reduz o risco de cometer erros caros. Ela oferece um roteiro claro de como os dados devem ser tratados, tornando todo o sistema mais fácil de gerenciar conforme a empresa cresce.
Qualidade de dados incremental
Qualidade de dados incremental
Dividir os pipelines de dados em etapas distintas simplifica muito a depuração. Se um painel mostrar um número errado, um engenheiro pode verificar primeiro a camada prata. Se os dados de prata estiverem corretos, eles saberão que o erro está na lógica de transformação de ouro. Esse isolamento ajuda as equipes a encontrar e corrigir bugs em minutos, em vez de horas, mantendo o fluxo de dados constante e confiável.
Viagem no tempo e reprodutibilidade
Viagem no tempo e reprodutibilidade
Ao manter um histórico completo na camada bronze, as organizações podem executar novamente todo o processo de dados quando quiserem. Isso é útil se as regras de negócios mudarem. Por exemplo, se a equipe de finanças mudar a forma de calcular o "lucro", você poderá reprocessar todos os seus dados antigos para corresponder à nova regra. Essa "viagem no tempo" também ajuda nas auditorias, porque você pode provar exatamente como os dados eram em qualquer momento do passado.
Acesso democratizado aos dados
Acesso democratizado aos dados
Pessoas diferentes em uma empresa precisam de tipos diferentes de dados. Os cientistas de dados costumam querer os dados brutos da camada bronze para treinar modelos de IA complexos. Enquanto isso, os analistas de negócios só querem os números limpos e finalizados da camada ouro para os gráficos. A arquitetura de medalhão permite que todos acessem a camada específica de que precisam sem atrapalhar o trabalho dos outros.
Como implementar uma arquitetura medallion
A criação dessa arquitetura exige um plano claro para mover dados entre ferramentas de armazenamento e computação. Você pode seguir estas quatro etapas para configurar um pipeline confiável.
Etapa 1: ingestão para bronze
Primeiro, configure pipelines automatizados para mover dados das suas fontes para uma área de armazenamento escalonável. Você pode usar ferramentas como o Dataflow para dados em tempo real ou cargas em lote para atualizações diárias. O objetivo aqui é despejar os dados em "buckets" sem alterá-los. Isso garante que nenhuma informação seja perdida ou alterada acidentalmente durante a transferência. |
Primeiro, configure pipelines automatizados para mover dados das suas fontes para uma área de armazenamento escalonável. Você pode usar ferramentas como o Dataflow para dados em tempo real ou cargas em lote para atualizações diárias. O objetivo aqui é despejar os dados em "buckets" sem alterá-los. Isso garante que nenhuma informação seja perdida ou alterada acidentalmente durante a transferência.
Etapa 2: transformação em prata
Em seguida, use um mecanismo de processamento como o Apache Spark ou SQL para limpar os dados brutos da camada bronze. Nesta etapa, você aplica regras de qualidade de dados. Você pode converter todos os carimbos de data/hora para um fuso horário padrão, como UTC, ou remover contas de teste das suas listas de usuários. Muitas equipes gravam esses resultados em formatos de tabela aberta, como Delta Lake ou Apache Iceberg, que ajudam a manter os dados organizados e pesquisáveis. |
Em seguida, use um mecanismo de processamento como o Apache Spark ou SQL para limpar os dados brutos da camada bronze. Nesta etapa, você aplica regras de qualidade de dados. Você pode converter todos os carimbos de data/hora para um fuso horário padrão, como UTC, ou remover contas de teste das suas listas de usuários. Muitas equipes gravam esses resultados em formatos de tabela aberta, como Delta Lake ou Apache Iceberg, que ajudam a manter os dados organizados e pesquisáveis.
Etapa 3: agregação para ouro
Depois que os dados estiverem limpos na camada silver, você poderá criar consultas SQL especializadas para criar suas tabelas ouro. Essas consultas combinam diferentes tabelas para criar métricas específicas, como "Receita por categoria". Elas costumam ser armazenadas em visualizações de alto desempenho que podem ser conectadas diretamente a uma ferramenta de visualização como o Looker. |
Depois que os dados estiverem limpos na camada silver, você poderá criar consultas SQL especializadas para criar suas tabelas ouro. Essas consultas combinam diferentes tabelas para criar métricas específicas, como "Receita por categoria". Elas costumam ser armazenadas em visualizações de alto desempenho que podem ser conectadas diretamente a uma ferramenta de visualização como o Looker.
Etapa 4: orquestração e governança
Por fim, você precisa de uma maneira de programar essas etapas para que elas aconteçam automaticamente. Ferramentas como o Serviço Gerenciado para Apache Airflow do Google Cloud podem gerenciar o tempo dos seus jobs. Você também precisa aplicar políticas de segurança rigorosas. Por exemplo, você pode permitir que todos leiam a camada ouro, mas apenas algumas contas de serviço autorizadas podem gravar ou alterar dados nas camadas prata e ouro. |
Por fim, você precisa de uma maneira de programar essas etapas para que elas aconteçam automaticamente. Ferramentas como o Serviço Gerenciado para Apache Airflow do Google Cloud podem gerenciar o tempo dos seus jobs. Você também precisa aplicar políticas de segurança rigorosas. Por exemplo, você pode permitir que todos leiam a camada ouro, mas apenas algumas contas de serviço autorizadas podem gravar ou alterar dados nas camadas prata e ouro.
Como criar uma arquitetura medallion no Google Cloud
O Google Cloud oferece um conjunto avançado de ferramentas que facilitam a implementação de uma arquitetura de medalhas. Esses serviços cuidam do trabalho pesado de escalonamento e segurança, para que sua equipe possa se concentrar em obter insights dos seus dados.
 Cloud StorageEsse serviço atua como sua zona de destino bronze, oferecendo armazenamento durável e de baixo custo para dados brutos em qualquer formato.
 BigQueryEsse data warehouse sem servidor serve como mecanismo para as camadas prata e ouro, executando consultas SQL rápidas para limpar e agregar dados.
 Lakehouse do Google CloudEle permite gerenciar formatos de tabelas abertas, como o Apache Iceberg, no data lake e no data warehouse com governança unificada.
- Serviço Gerenciado para Apache SparkServiço totalmente gerenciado que usa o Apache Spark de código aberto para processar, limpar e transformar dados à medida que eles se movem pelas camadas de medalhão.
- DataflowEle processa dados de streaming em tempo real, garantindo que as informações sejam transferidas para as camadas arquitetônicas assim que forem criadas.
- DataformEssa ferramenta ajuda os analistas a usar SQL para criar e programar as transformações de dados complexas que transformam dados prata em dados ouro.
Tudo pronto para transformar seus dados em um recurso comercial confiável?
Comece a criar sua arquitetura em camadas com o BigQuery hoje mesmo.
Precisa de ajuda para começar?
Entre em contato com a equipe de vendasTrabalhe com um parceiro confiável
Encontre um parceiroContinue navegando
Ver todos os produtos