¿Qué es la arquitectura de medallón?
La arquitectura de medallón es un patrón de diseño de datos que se usa para organizar datos en un data lake o lakehouse. Su trabajo principal es mejorar la calidad y la estructura de los datos a medida que avanzan por las diferentes etapas. En lugar de tener una pila gigante de datos, este framework los divide en capas. Cada capa agrega más valor, lo que hace que los datos sean más confiables y fáciles de usar para las decisiones empresariales.
Este es un framework lógico, no una pieza de software específica. Está diseñado para ayudar a los equipos a administrar canalizaciones de datos y, al mismo tiempo, garantizar transacciones ACID (atomicidad, coherencia, aislamiento y durabilidad). Cuando los datos se mueven a través de estos niveles de validación, las empresas pueden confiar en que su información es precisa y segura, incluso cuando se trata de grandes cantidades de información sin procesar.
Arquitectura de medallón en comparación con el almacenamiento de datos tradicional
En el pasado, los almacenes de datos tradicionales usaban un enfoque de "esquema en escritura". Esto significaba que tenías que definir perfectamente la estructura de tus datos antes de poder guardarlos. Si bien esto mantenía todo organizado, a menudo era lento y rígido. Si el formato de tus datos cambiaba ligeramente, todo el sistema podría dejar de funcionar hasta que un ingeniero lo arreglara manualmente.
La arquitectura de medallón sigue el paradigma moderno de lakehouse, que adopta el "esquema en lectura" en la capa de datos sin procesar. Esto permite que los datos lleguen de inmediato en su forma sin procesar. Solo te preocupas por la estructura cuando el valor empresarial de los datos se vuelve claro. Es una forma de trabajar más flexible que permite a las empresas recopilar datos ahora y decidir exactamente cómo los usarán más adelante.
Las tres capas de la arquitectura de medallón
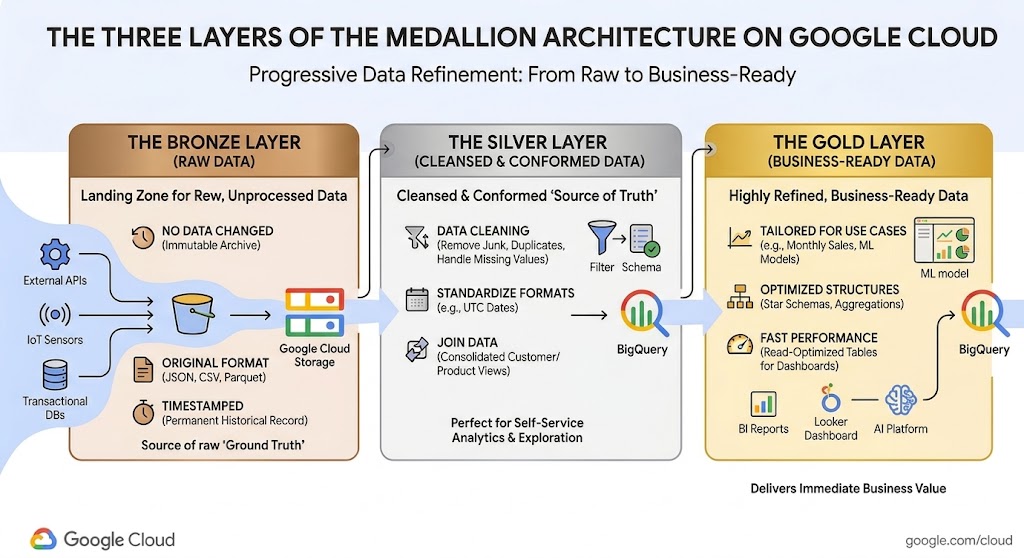
En una arquitectura de medallón, los datos fluyen como un río a través de tres etapas principales: bronce, plata y oro. A medida que pasan de una etapa a otra, los datos se vuelven más limpios y organizados. Esta configuración permite a los ingenieros corregir errores de forma temprana y les proporciona a los diferentes usuarios la versión correcta de los datos para sus tareas específicas.
La capa bronce (datos sin procesar)
La capa bronce es la zona de destino para todos los datos entrantes. Aquí es donde almacenas información sin procesar de fuentes como APIs web, sensores de IoT o bases de datos transaccionales. Aquí no cambias los datos, sino que los mantienes en su formato original, como JSON, CSV o Parquet.
Los ingenieros suelen agregar una marca de tiempo a estos archivos para mostrar cuándo llegaron. La capa bronce actúa como un archivo histórico permanente. Si más adelante cometes un error en tus cálculos, siempre puedes volver a estos datos sin procesar y empezar de nuevo. Garantiza que nunca pierdas la "verdad fundamental" de tus operaciones comerciales.
La capa plata (datos limpios y ajustados)
Piensa en la capa plata como tu "fuente de información". En esta etapa, los datos de la capa bronce se limpian a fondo. Los ingenieros usan herramientas para filtrar la basura, quitar registros duplicados y corregir valores faltantes. También estandarizan formatos; por ejemplo asegurarse de que todas las fechas sigan el mismo patrón.
La capa plata une diferentes conjuntos de datos para crear una vista clara de los elementos comerciales principales, como "clientes" o "productos". Esta capa es perfecta para el análisis de autoservicio. Es lo suficientemente limpia para que la mayoría de las personas la usen, pero también lo suficientemente detallada para responder una amplia variedad de preguntas sin limitarse a un solo informe específico.
La capa oro (datos listos para la empresa)
La capa oro contiene los datos más refinados. Esta información se adapta a necesidades empresariales específicas, como un informe de ventas mensual o un modelo de aprendizaje automático que predice la deserción de clientes. En lugar de listas sin procesar, la capa oro suele usar "esquemas de estrella" o tablas optimizadas para una lectura rápida.
Como estos datos ya están agregados y calculados, se cargan muy rápido en los paneles. Un científico de datos podría usar una tabla oro para ver los "usuarios activos por día por región" sin tener que unir millones de filas sin procesar por sí mismo. Es el producto final diseñado para proporcionar valor inmediato a la empresa.
Beneficios clave de la arquitectura de medallón
Usar un enfoque en capas ayuda a los equipos a avanzar más rápido y reduce el riesgo de cometer errores costosos. Proporciona una hoja de ruta clara sobre cómo se deben manejar los datos, lo que facilita la administración de todo el sistema a medida que crece la empresa.
Calidad de los datos incremental
Calidad de los datos incremental
Dividir las canalizaciones de datos en pasos distintos hace que la depuración sea mucho más sencilla. Si un panel muestra un número incorrecto, un ingeniero puede verificar primero la capa plata. Si los datos de la capa plata son correctos, sabe que el error está en la lógica de transformación de la capa oro. Este aislamiento ayuda a los equipos a encontrar y corregir errores en minutos en lugar de horas, lo que mantiene el flujo de datos constante y confiable.
Viaje en el tiempo y reproducibilidad
Viaje en el tiempo y reproducibilidad
Al mantener un historial completo en la capa bronce, las organizaciones pueden volver a ejecutar todo su proceso de datos cuando lo deseen. Esto es útil si cambian las reglas de negocio. Por ejemplo, si el equipo de finanzas cambia la forma en que calcula las "ganancias", puedes volver a procesar todos tus datos antiguos para que coincidan con la nueva regla. Este "viaje en el tiempo" también ayuda con las auditorías, ya que puedes demostrar exactamente cómo se veían los datos en cualquier momento del pasado.
Acceso democratizado a los datos
Acceso democratizado a los datos
Las diferentes personas de una empresa necesitan distintos tipos de datos. Los científicos de datos suelen querer los datos sin procesar de la capa bronce para entrenar modelos de IA complejos. Mientras tanto, los analistas de negocios solo quieren las cifras limpias y finalizadas de la capa oro para sus gráficos. La arquitectura de medallón permite que todos accedan a la capa específica que necesitan sin interferir entre sí.
Cómo implementar una arquitectura de medallón
Para crear esta arquitectura, se requiere un plan claro para mover datos entre herramientas de almacenamiento y procesamiento. Puedes seguir estos cuatro pasos para configurar una canalización confiable.
Paso 1: Transferencia a la capa bronce
Primero, configura canalizaciones automatizadas para trasladar datos de tus fuentes a un área de almacenamiento escalable. Puedes usar herramientas como Dataflow para datos en tiempo real o cargas por lotes para actualizaciones diarias. El objetivo aquí es volcar los datos en "buckets" sin cambiarlos. Esto garantiza que no se pierda información ni se altere accidentalmente durante la migración. |
Primero, configura canalizaciones automatizadas para trasladar datos de tus fuentes a un área de almacenamiento escalable. Puedes usar herramientas como Dataflow para datos en tiempo real o cargas por lotes para actualizaciones diarias. El objetivo aquí es volcar los datos en "buckets" sin cambiarlos. Esto garantiza que no se pierda información ni se altere accidentalmente durante la migración.
Paso 2: Transformación a plata
Luego, usa un motor de procesamiento como Apache Spark o SQL para limpiar los datos sin procesar de la capa bronce. Durante este paso, aplicarás reglas de calidad de los datos. Podrías convertir todas las marcas de tiempo a una zona horaria estándar, como UTC, o quitar las cuentas de prueba de tus listas de usuarios. Muchos equipos escriben estos resultados en formatos de tabla abiertos como Delta Lake o Apache Iceberg, que ayudan a mantener los datos organizados y con capacidad de búsqueda. |
Luego, usa un motor de procesamiento como Apache Spark o SQL para limpiar los datos sin procesar de la capa bronce. Durante este paso, aplicarás reglas de calidad de los datos. Podrías convertir todas las marcas de tiempo a una zona horaria estándar, como UTC, o quitar las cuentas de prueba de tus listas de usuarios. Muchos equipos escriben estos resultados en formatos de tabla abiertos como Delta Lake o Apache Iceberg, que ayudan a mantener los datos organizados y con capacidad de búsqueda.
Paso 3: Agregación a oro
Una vez que los datos estén limpios en la capa plata, puedes crear consultas en SQL especializadas para crear tus tablas de la capa oro. Estas consultas unen diferentes tablas para crear métricas específicas, como "Ingresos por categoría". Estas suelen almacenarse en vistas de alto rendimiento que pueden conectarse directamente a una herramienta de visualización como Looker. |
Una vez que los datos estén limpios en la capa plata, puedes crear consultas en SQL especializadas para crear tus tablas de la capa oro. Estas consultas unen diferentes tablas para crear métricas específicas, como "Ingresos por categoría". Estas suelen almacenarse en vistas de alto rendimiento que pueden conectarse directamente a una herramienta de visualización como Looker.
Paso 4: Organización y administración
Por último, necesitas una forma de programar estos pasos para que se realicen automáticamente. Herramientas como Managed Service para Apache Airflow de Google Cloud pueden administrar la programación de tus trabajos. También debes aplicar políticas de seguridad estrictas. Por ejemplo, podrías permitir que todos lean la capa oro, pero solo unas pocas cuentas de servicio autorizadas deberían poder escribir o cambiar datos en los niveles plata y oro. |
Por último, necesitas una forma de programar estos pasos para que se realicen automáticamente. Herramientas como Managed Service para Apache Airflow de Google Cloud pueden administrar la programación de tus trabajos. También debes aplicar políticas de seguridad estrictas. Por ejemplo, podrías permitir que todos lean la capa oro, pero solo unas pocas cuentas de servicio autorizadas deberían poder escribir o cambiar datos en los niveles plata y oro.
Crea una arquitectura de medallón en Google Cloud
Google Cloud ofrece un conjunto de herramientas potente que facilita la implementación de una arquitectura de medallón. Estos servicios se encargan del trabajo pesado de escalamiento y seguridad, por lo que tu equipo puede enfocarse en obtener estadísticas de tus datos.
 Cloud StorageEste servicio actúa como tu zona de destino de bronce, ya que proporciona almacenamiento duradero y de bajo costo para datos sin procesar en cualquier formato.
 BigQueryEste almacén sin servidores funciona como el motor de tus capas plata y oro, y ejecuta consultas en SQL rápidas para limpiar y agregar datos.
 Lakehouse de Google CloudTe permite administrar formatos de tablas abiertas como Apache Iceberg en tu data lake y almacén de datos con una administración unificada.
- Managed Service para Apache SparkServicio completamente administrado que usa Apache Spark de código abierto para procesar, limpiar y transformar datos a medida que se mueven por las capas de medallón.
- DataflowProcesa datos de transmisión en tiempo real, lo que garantiza que la información se mueva a tus capas arquitectónicas tan pronto como se crea.
- DataformEsta herramienta ayuda a los analistas a usar SQL para crear y programar las transformaciones de datos complejas que convierten los datos de la capa plata en datos de la capa oro.
¿Todo listo para transformar tus datos en un recurso empresarial confiable?
Comienza a crear tu arquitectura en capas con BigQuery hoy mismo.
¿Necesitas ayuda para comenzar?
Comunicarse con VentasTrabaja con un socio confiable
Buscar un socioSigue explorando
Ver todos los productos