Data Agent Kit 정식 버전 출시: 모든 코딩 에이전트에 Google 데이터 클라우드 제공

Arun Nair
Product Manager, Google
Jeff Nelson
Developer Relations Engineer, Google
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
오늘 Google Cloud Data Agent Kit가 정식 버전으로 출시되었습니다. Data Agent Kit는 무료로 제공되는 모델 컨텍스트 프로토콜(MCP) 도구 및 에이전트 스킬 세트로, Antigravity, Claude Code, Codex 또는 기타 인기 도구를 사용하는지 여부와 관계없이 이미 사용 중인 코딩 에이전트를 Google Cloud 데이터 제품과 직접 연동할 수 있도록 지원합니다.
정식 버전에서는 개방형 레이크하우스에 대한 BigQuery Graph, Bigtable, Managed Service for Apache Spark 액세스 지원이 추가되고, 일상 업무를 더 빠르고 원활하게 만들어 주는 수십 가지 편의 기능이 개선되었습니다.
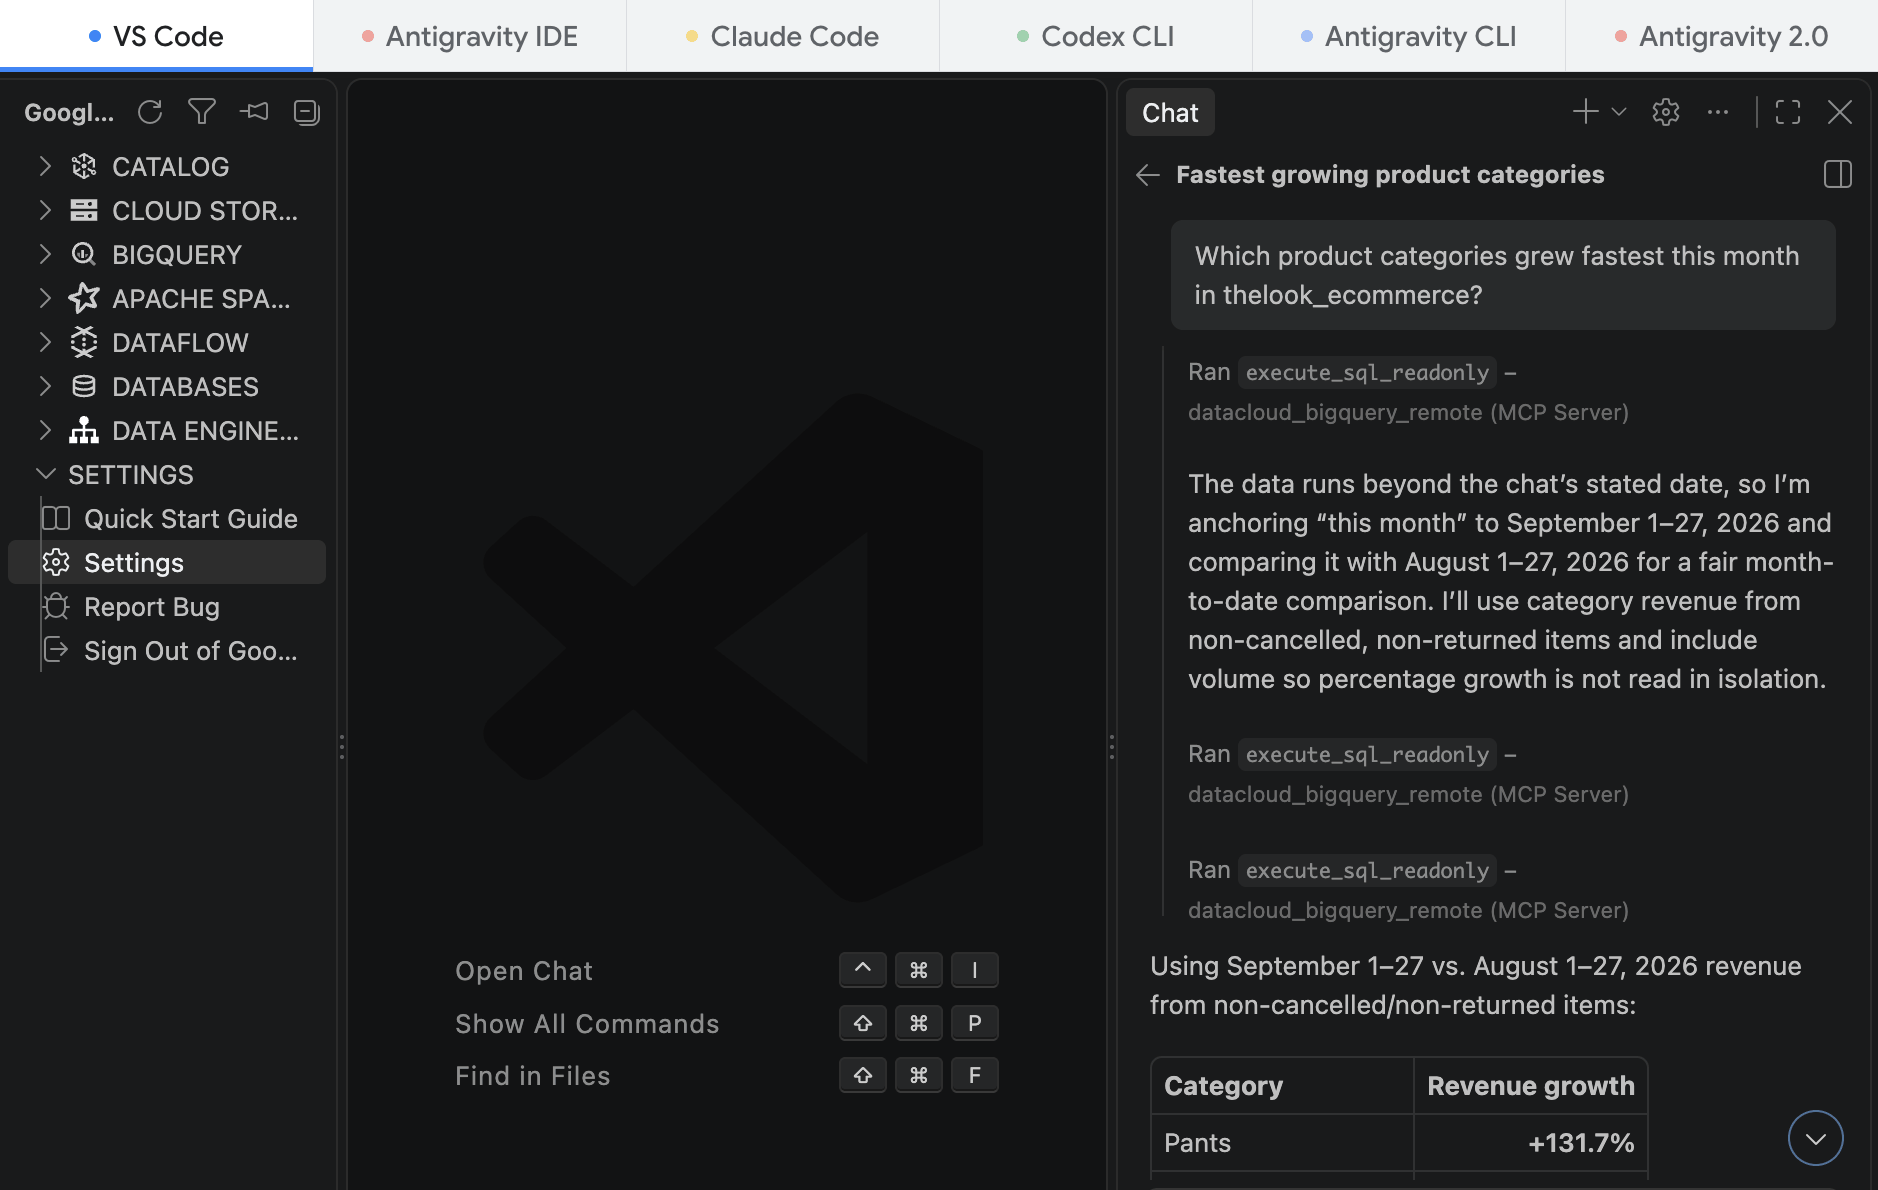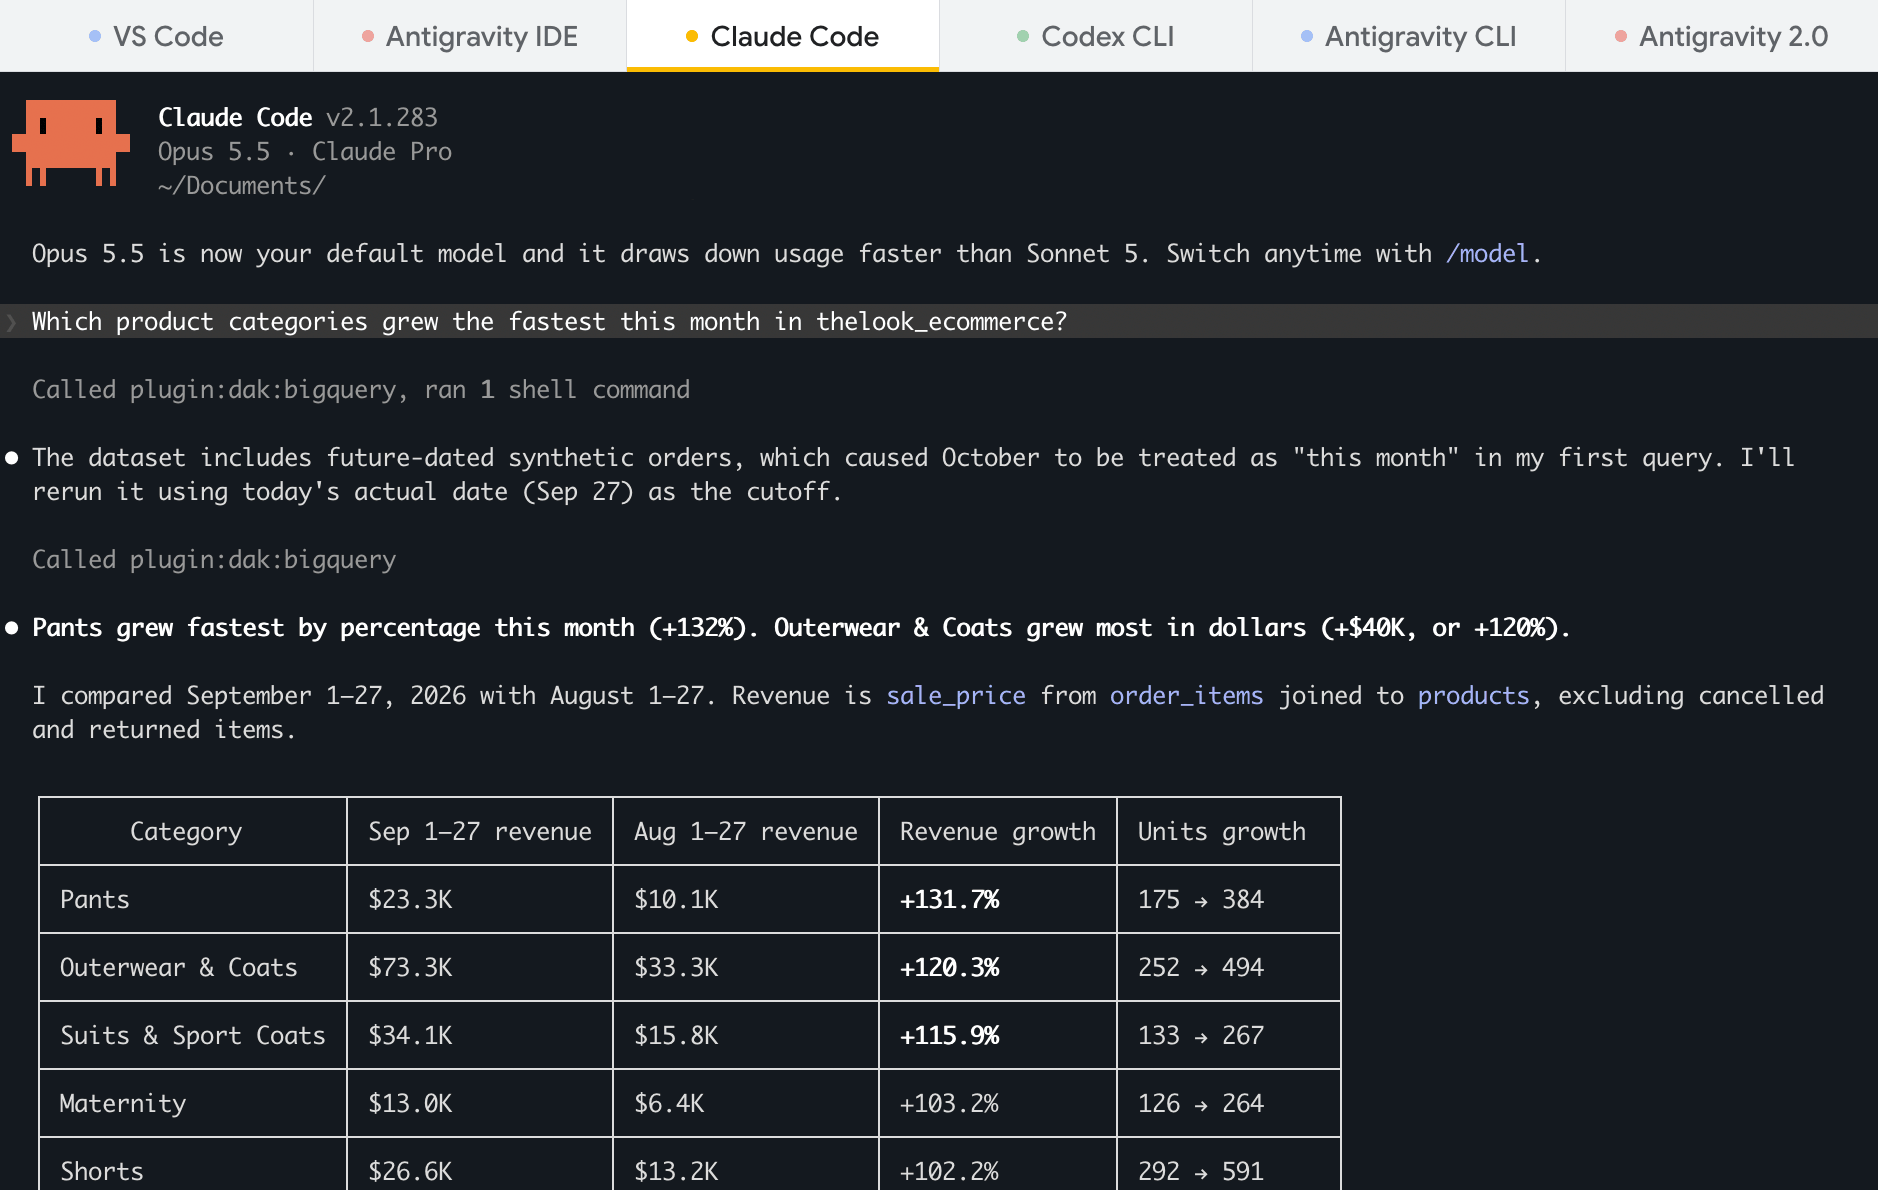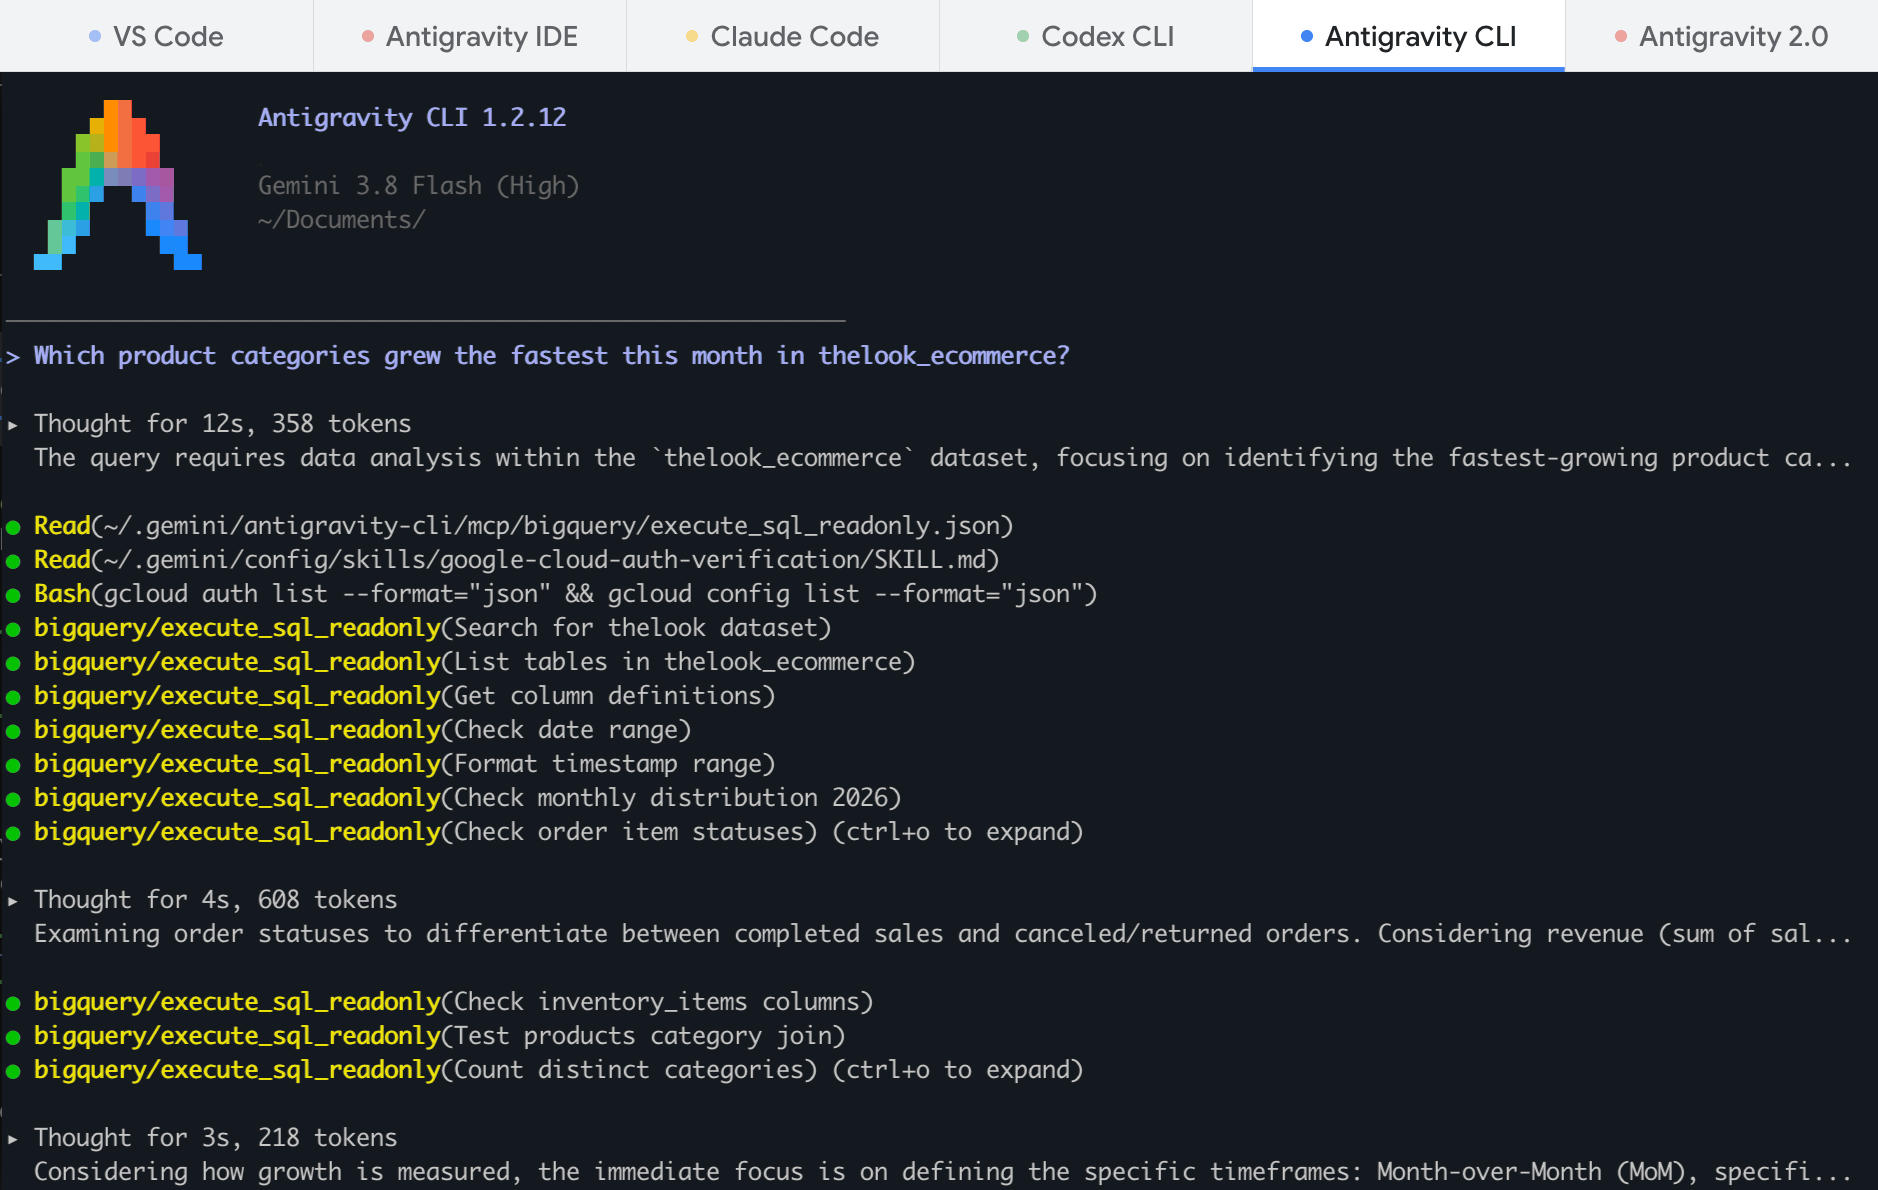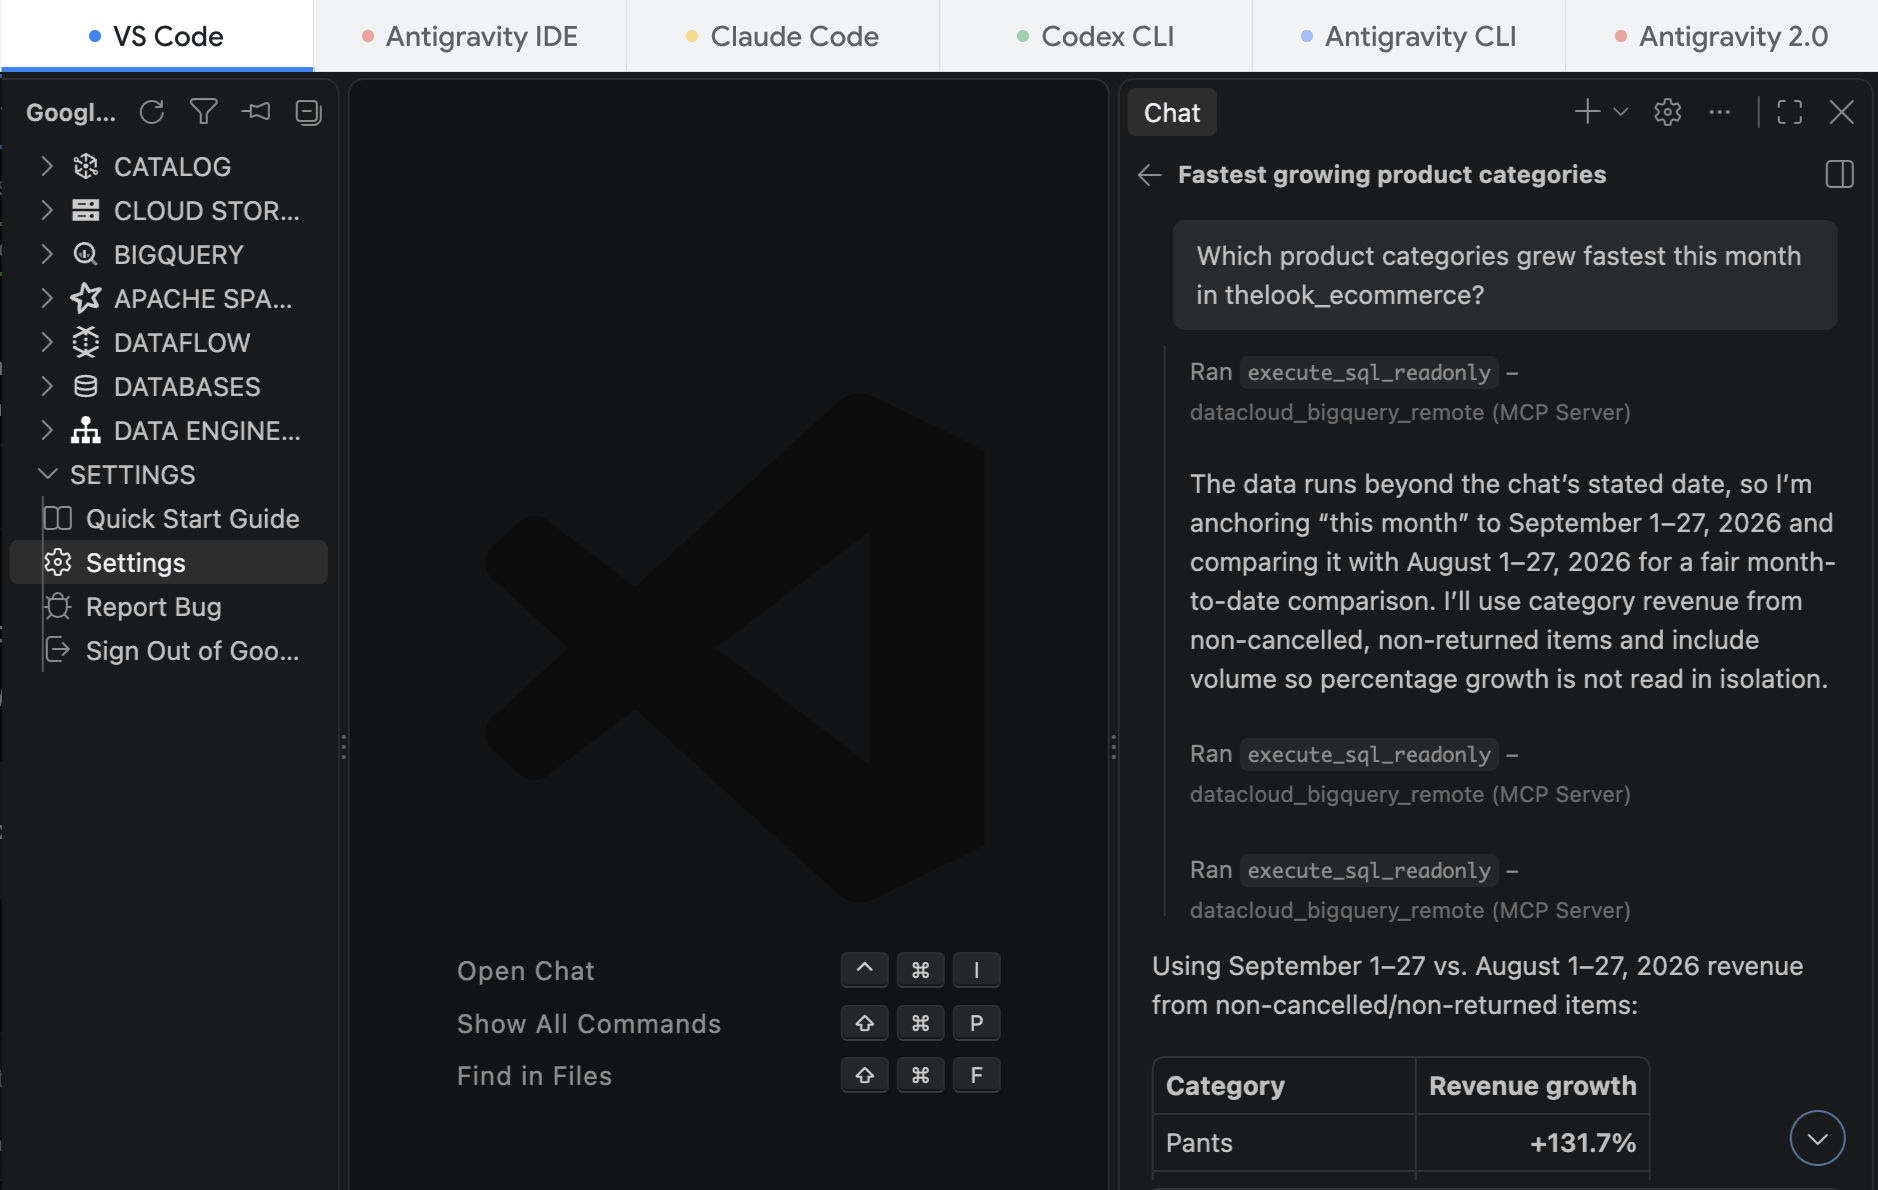
Data Agent Kit란 무엇인가요?
코딩 에이전트가 SQL, PySpark, 파이프라인 코드를 작성하는 데 매우 능숙해졌습니다. 어떤 테이블이 존재하는지, 어떻게 파티셔닝되어 있는지, 팀에서 어떤 테이블을 신뢰하는지, 어젯밤 작업이 실패한 이유는 무엇인지 등, 환경에 대한 컨텍스트는 코딩 에이전트에 기본 제공되지 않습니다. 이러한 컨텍스트가 없으면 강력한 에이전트라도 가정을 바탕으로 작업해야 하므로, 결국 사용자가 스키마와 오류 로그를 채팅에 붙여넣어 부족한 부분을 채워야 합니다.
Data Agent Kit는 두 가지 방식으로 이 격차를 메웁니다.
-
MCP 도구: 15개 이상의 Google 데이터 클라우드 서비스에 연결하여 에이전트가 라이브 환경에서 스키마를 검사하고, 쿼리를 실행하고, 작업 로그를 읽고, 리소스를 관리할 수 있습니다.
-
Google이 만든 스킬: BigQuery SQL 최적화, Bigtable row key 설계, dbt(데이터 빌드 도구) 파이프라인 빌드와 같은 데이터 권장사항을 에이전트에 가르치는 Google Cloud 엔지니어의 오픈소스 지침입니다.
Data Agent Kit는 VS Code, Antigravity IDE, Cursor, 기타 VS Code 호환 편집기용 IDE 확장 프로그램, Antigravity 2.0, Antigravity CLI, Claude Code, Codex용 플러그인, 또는 사전 설치되어 제공되는 Cloud Shell 및 Cloud Workstations 등 이미 사용 중인 환경에서 바로 사용할 수 있습니다. 또한 IDE 확장 프로그램은 Google Cloud 콘솔의 경량 버전을 편집기에 제공하므로 창을 전환하지 않고도 데이터를 탐색하고, 쿼리를 실행하고, 에이전트의 작업을 검토할 수 있습니다.
작동 방식
에이전트에게 "다음 달에 가장 많이 팔릴 제품의 수요를 예측하고 이를 충족할 만큼 재고가 충분한지 확인해 줘"라고 요청한다고 가정해 보겠습니다. Data Agent Kit는 관련 스킬을 로드하므로 에이전트는 작업에 대한 Google의 권장사항을 따릅니다. 이는 Knowledge Catalog를 검색하여 팀에서 신뢰하는 판매 및 인벤토리 테이블을 찾습니다. 그런 다음 MCP 도구를 사용하여 BigQuery에서 예측을 실행하고, PostgreSQL용 AlloyDB에서 현재 재고 수준을 확인하고, 결합된 답변을 편집기나 터미널로 다시 가져옵니다. 모든 단계는 자체 IAM 권한으로 실행됩니다.
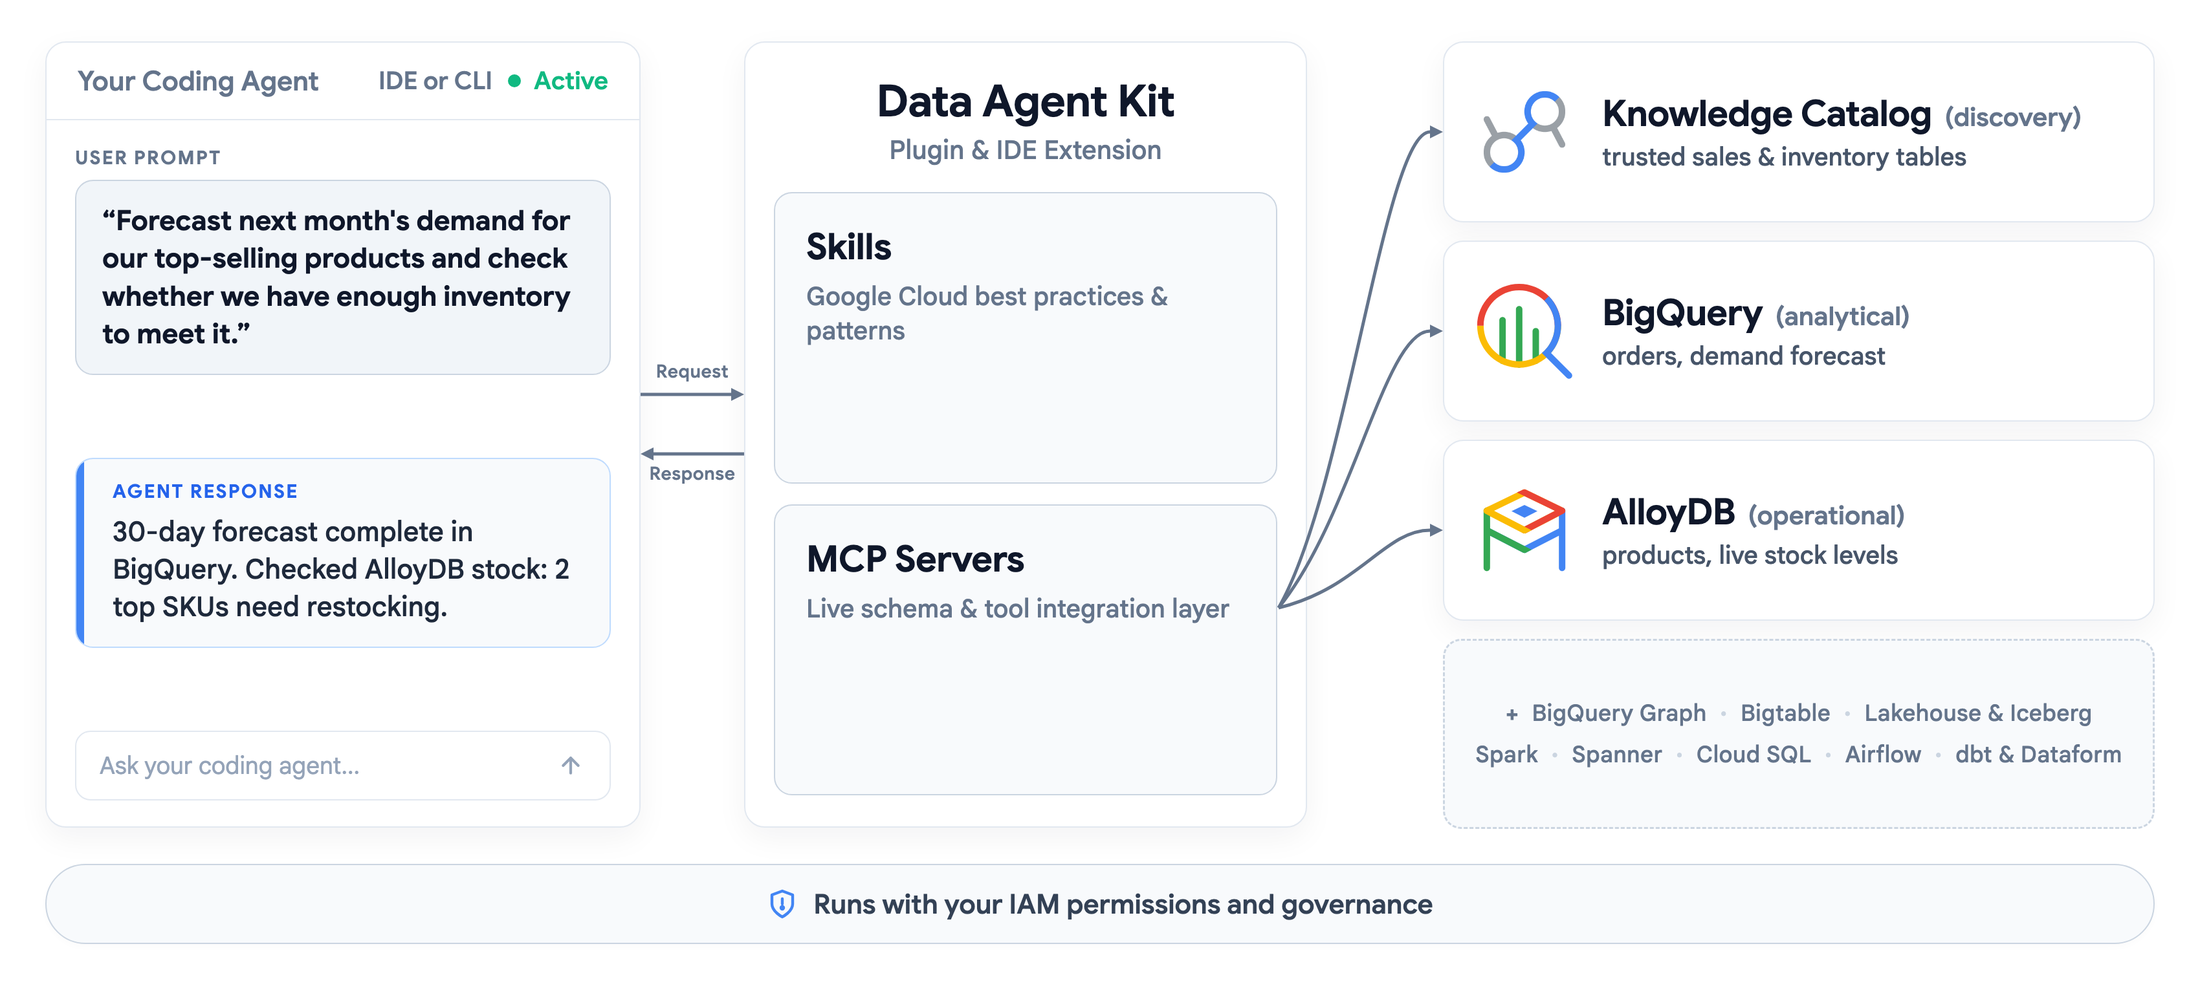
Data Agent Kit가 데이터에 연결하는 방법
빌드할 수 있는 항목
Data Agent Kit는 분석, 운영 데이터베이스, 레이크하우스, 파이프라인을 지원합니다. 정식 버전의 새로운 기능부터 시작하여 실제로 어떤 모습인지 살펴보겠습니다.
분석 및 그래프: BigQuery 및 BigQuery Graph(정식 버전의 새로운 기능)
그래프는 사람들이 함께 구매하는 제품이나 공급업체가 인벤토리에 연결되는 방식과 같은 관계를 탐색하는 자연스러운 방법입니다. 그래프를 빌드하려면 일반적으로 CREATE PROPERTY GRAPH DDL을 직접 작성하고, GQL을 학습하고, 어떤 키가 실제로 에지를 형성하는지 파악해야 합니다.
그 대신 원하는 그래프를 설명하면 에이전트가 그래프를 빌드합니다. bigquery-graph-author 스킬은 테이블을 노드와 에지에 매핑하고, 제안된 각 관계를 실제 데이터와 대조하여 확인하고, 그래프를 만들기 전에 승인이 필요한 계획을 보여줍니다. 기존에 보유한 ER 다이어그램이나 데이터 모델에서 시작할 수도 있습니다. 그러면 bigquery-graph-query 스킬이 GQL을 작성하고, IDE의 그래프 시각화 도구를 통해 결과를 클릭하여 확인할 수 있습니다.
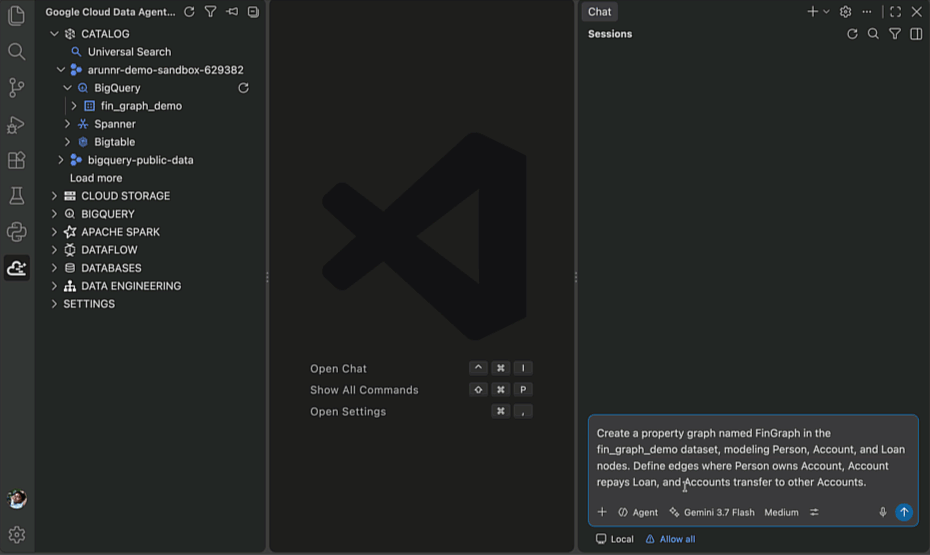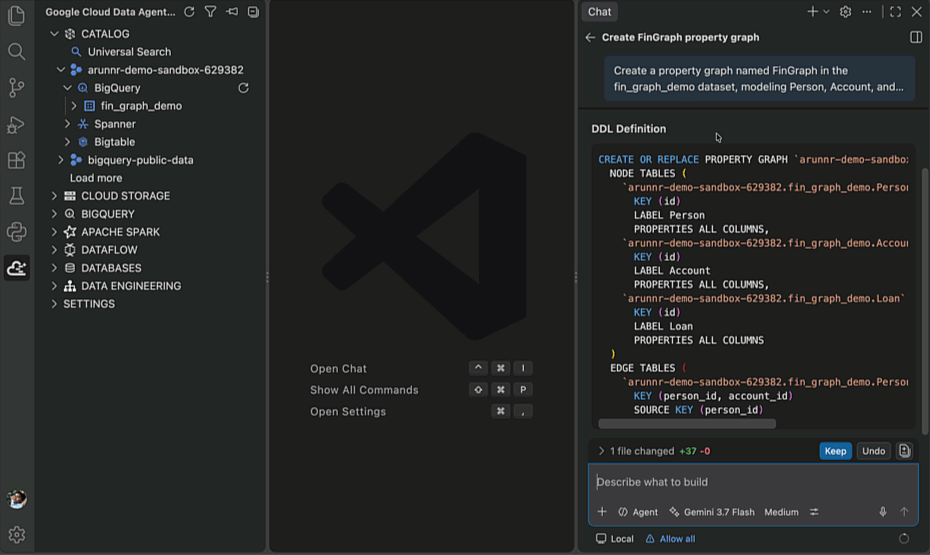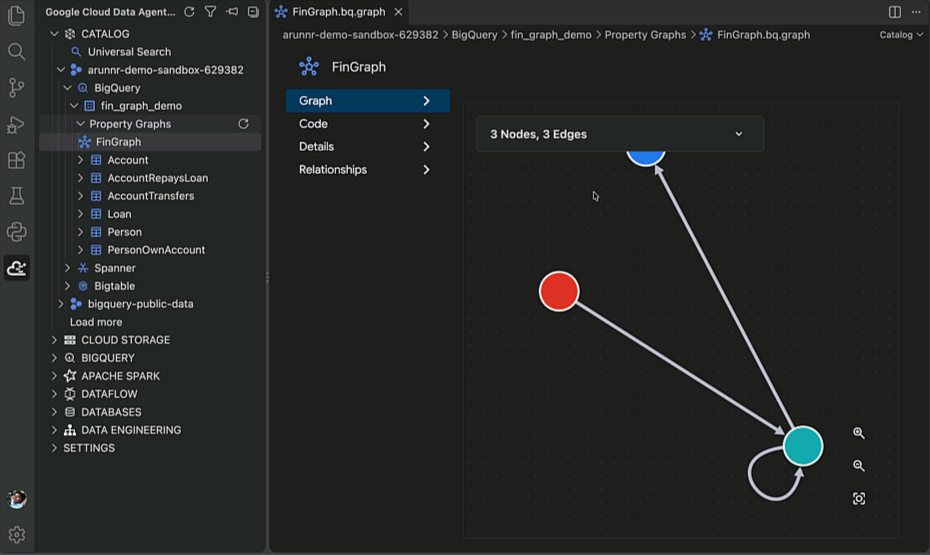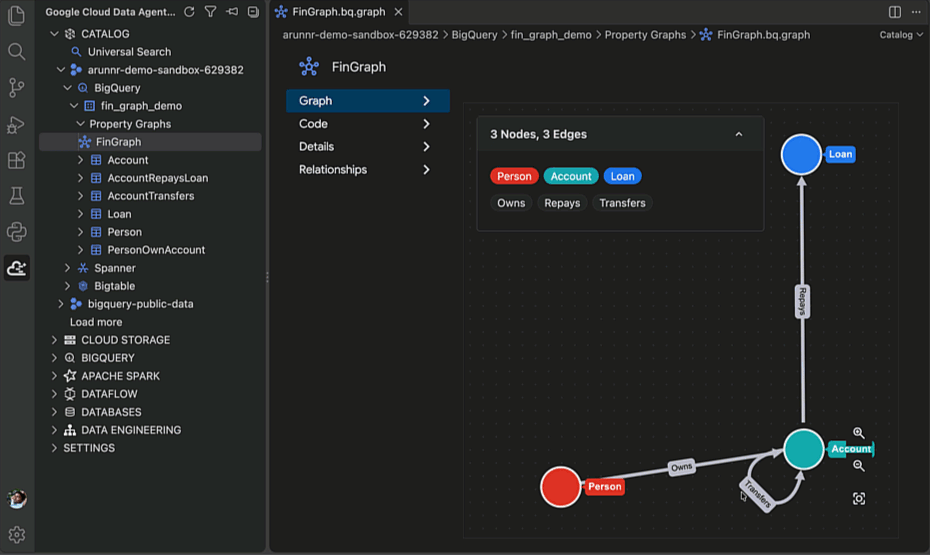
BigQuery 속성 그래프 빌드 및 시각화
운영 및 실시간 데이터베이스: Spanner, AlloyDB, Cloud SQL, Bigtable(정식 버전의 새로운 기능)
맞춤 피드, 실시간 카운터, 스토어의 '최근 본 항목' 레일과 같은 일부 기능은 즉시 로드되어야 합니다. Bigtable은 바로 이러한 용도로 설계되었으며, 잘 설계된 row key를 사용하면 그 효과를 톡톡히 볼 수 있습니다.
정식 버전 출시와 함께 Bigtable은 Spanner, AlloyDB, Cloud SQL과 함께 Data Agent Kit에서 완전히 지원되는 데이터베이스가 되었습니다. 새로운 bigtable-basics 스킬은 데이터를 읽는 방식을 중심으로 스키마를 설계하고, 무엇이든 생성하기 전에 핫스팟과 전체 테이블 스캔을 플래그합니다. 그러면 에이전트가 테이블을 만들고 GoogleSQL로 쿼리할 수 있으며, column family는 읽을 수 있는 열로 평탄화됩니다. IDE에서 카탈로그 탐색기의 Bigtable 인스턴스와 테이블을 탐색하고 SQL 편집기에서 쿼리를 실행할 수 있습니다.
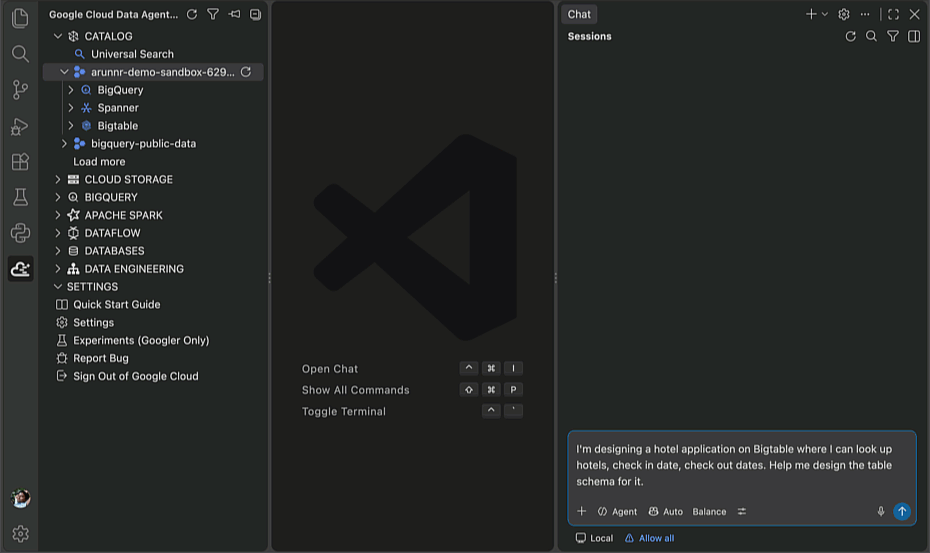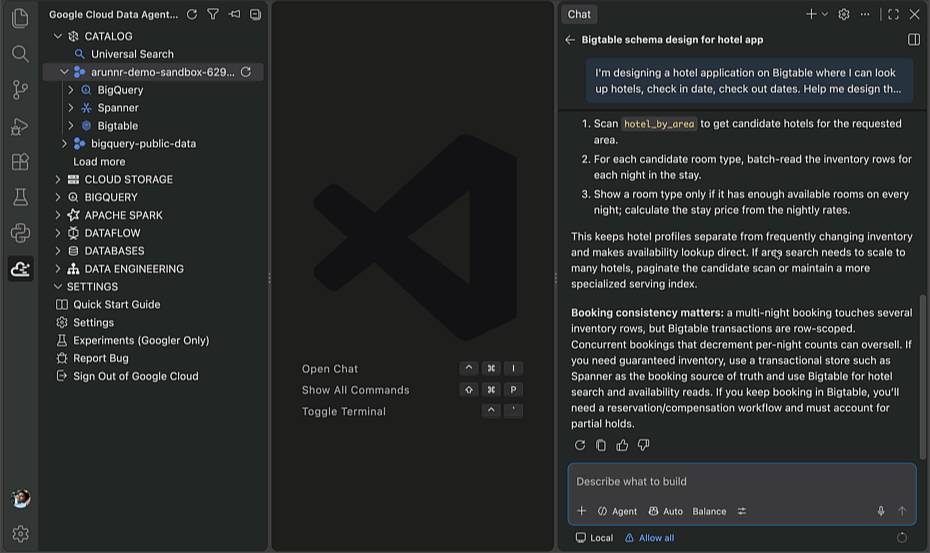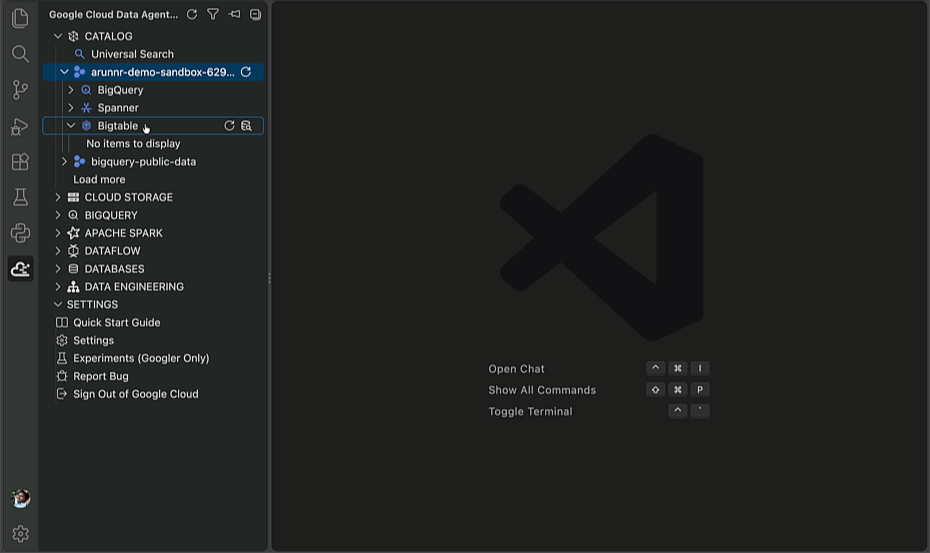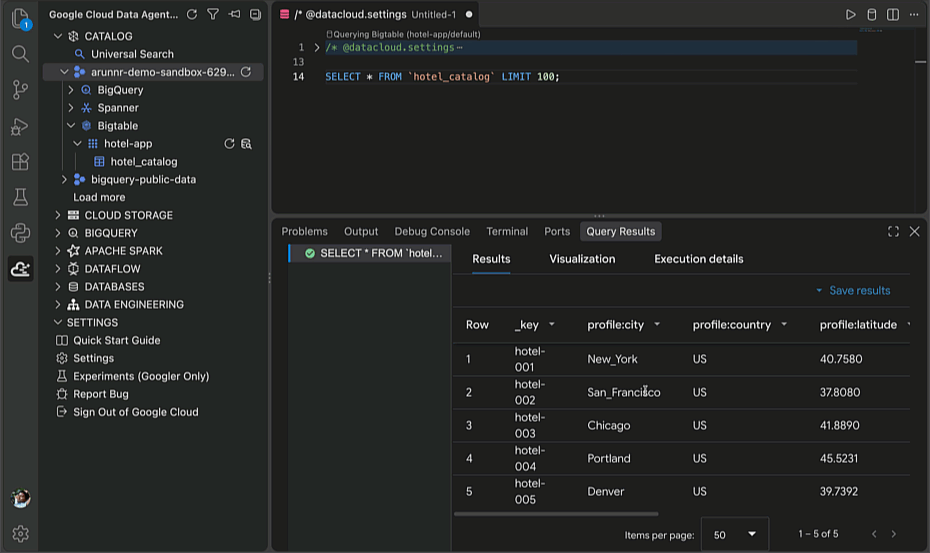
에이전트 가이드 Bigtable 스키마 설계 및 쿼리
레이크하우스 및 Spark: Managed Service for Apache Spark 및 Lakehouse for Apache Iceberg(정식 버전의 새로운 기능)
에이전트는 이미 BigQuery를 통해 레이크하우스의 Apache Iceberg 테이블을 쿼리할 수 있습니다. 이제 클러스터를 관리할 필요 없이 Managed Service for Apache Spark에서 서버리스 Spark를 통해 동일한 테이블을 사용할 수 있습니다. 각 세션은 상태를 유지하므로 임시 뷰가 문 간에 전달되며, 브랜치, 시간 이동, 스키마 변경을 포함한 Iceberg의 전체 특성 세트를 사용할 수 있습니다.
테이블이 모두 Google Cloud에 있을 필요도 없습니다. federate-lakehouse-catalog 스킬이 레이크하우스를 AWS Glue 및 Databricks Unity Catalog에 연결하므로 에이전트가 수집 파이프라인을 먼저 빌드하지 않고도 해당 데이터를 제자리에서 쿼리할 수 있습니다.
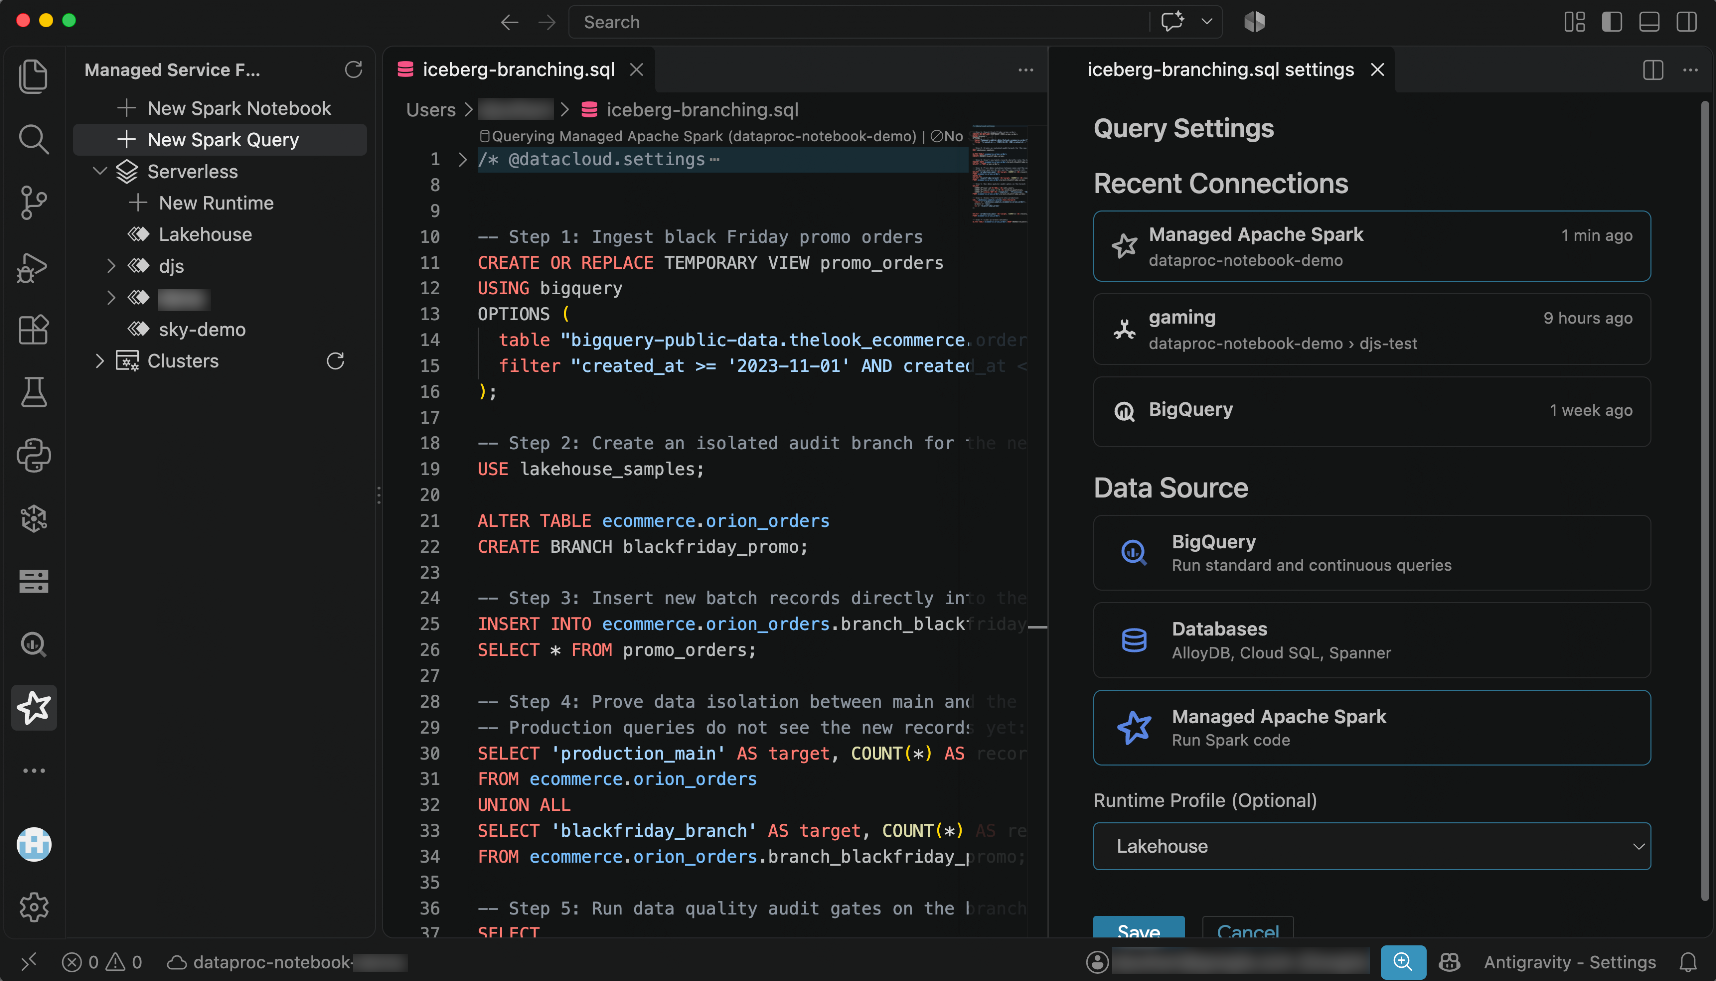
Managed Service for Apache Spark를 사용하여 Iceberg 테이블 브랜치 및 쿼리
파이프라인 및 조정: dbt, Dataform, Managed Service for Apache Airflow
로직이 작동하면 에이전트가 이를 자체적으로 실행되는 파이프라인으로 전환할 수 있습니다. dbt 또는 Dataform 모델을 작성하면 gcp-pipeline-orchestration 스킬이 노트북과 함께 Managed Service for Apache Airflow에서 오케스트레이션 파이프라인으로 예약합니다. 파이프라인에는 모델 업로드 또는 일괄 추론 실행과 같은 Gemini Enterprise Agent Platform 단계도 포함될 수 있습니다.
IDE에서 시각적 파이프라인 캔버스를 통해 각 실행을 추적할 수 있습니다. 작업에 주의가 필요한 경우 진단을 클릭하여 로그를 에이전트에 전달하면 됩니다. Airflow 및 Spark 문제 해결 기술은 근본 원인을 추적하고 승인할 수 있는 수정사항을 제안합니다.
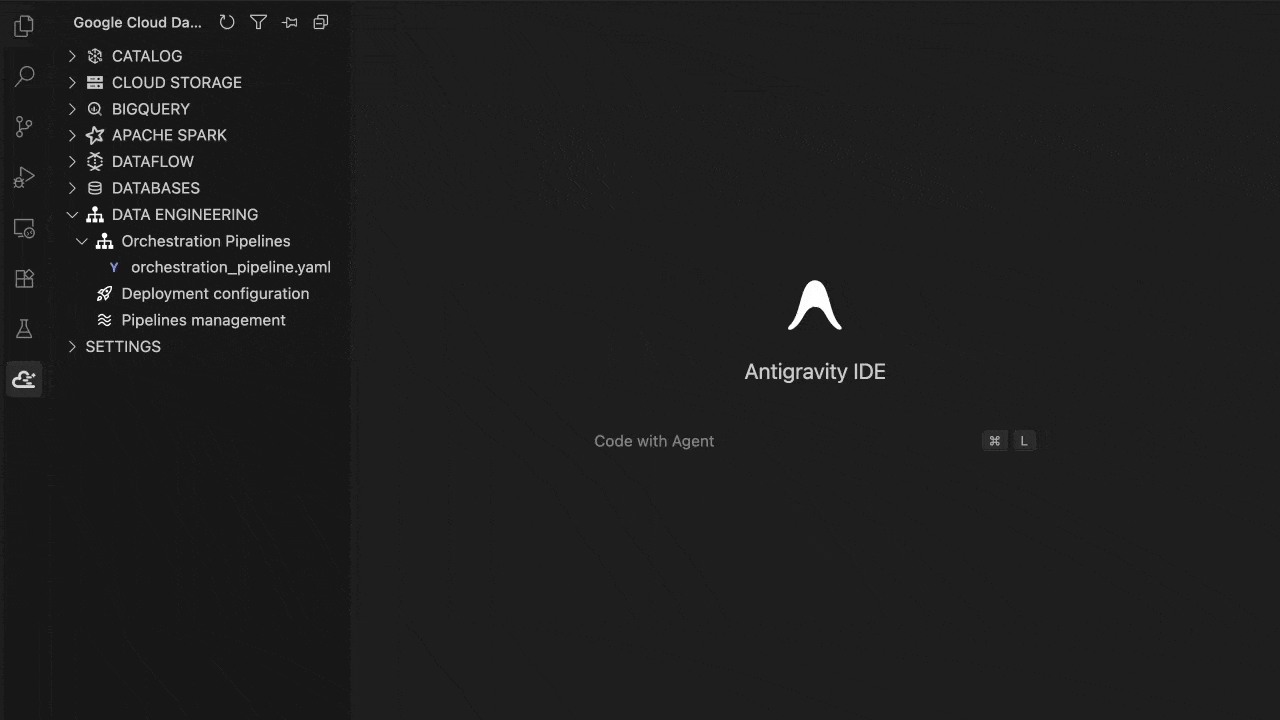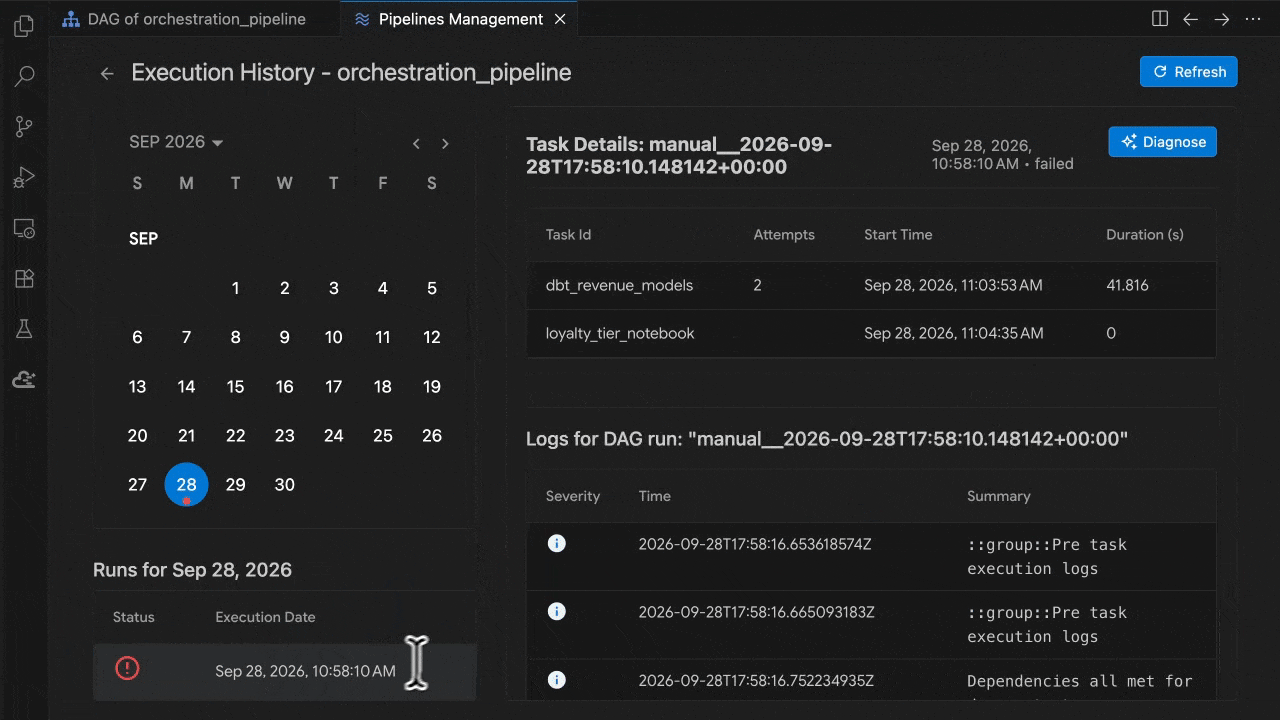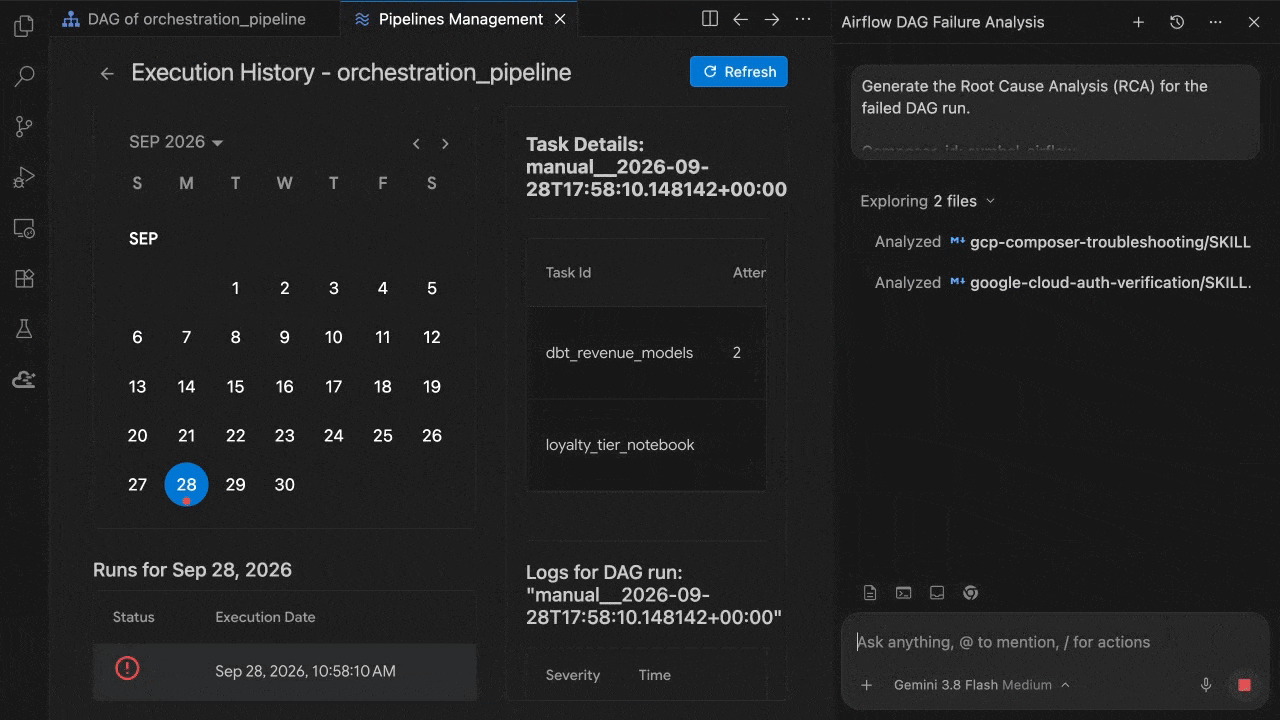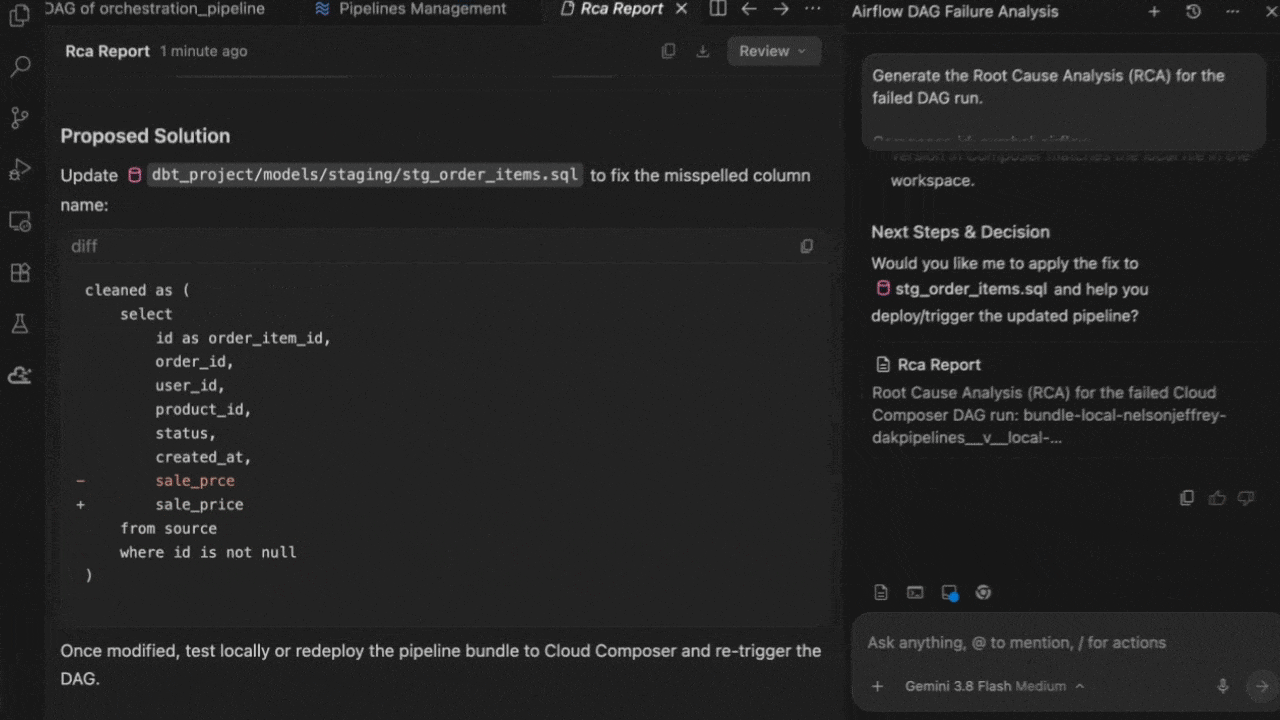
에이전트를 사용하여 실패한 Airflow DAG 문제 해결
개발자 환경 개선
정식 버전은 설정과 일상적인 워크플로도 간소화합니다. 시작할 때 한 번만 로그인하고 사용하는 Google Cloud 서비스를 선택하면 됩니다. Data Agent Kit는 수동 설정 파일 없이 필요한 API를 자동으로 사용 설정하고, 해당하는 스킬을 설치하고, MCP 서버를 구성합니다. IDE 내에서 SQL 편집기와 노트북은 이제 인라인 코드 생성, 테이블에 대한 @ 참조, 제안된 변경사항에 대한 비교 뷰를 지원합니다. 또한 확장 프로그램은 활성 프로젝트, 열려 있는 파일, 방금 실행한 쿼리의 오류를 에이전트와 공유하므로 '이 쿼리 수정'을 요청하면 바로 작동합니다.
핵심 도구의 속도와 반응성도 개선되었습니다. 새 Spark 노트북은 Spark Connect 런타임을 자동으로 만들고 선택하며, 편집기의 Spark SQL 쿼리는 기본 제공 실행 측정항목과 함께 격리된 세션에서 실행됩니다. 이제 카탈로그 탐색기가 더 빠르게 로드되고 사이드바에 BigQuery 공개 데이터 세트가 포함됩니다. 튜닝된 노트북 스킬은 에이전트가 더 적은 토큰을 사용하면서 노트북 작업을 더 빠르게 완료하는 데 도움이 됩니다.
엔터프라이즈 지원
Data Agent Kit는 추가 비용 없이 포함되어 있으며, 에이전트가 사용하는 Google Cloud 서비스에 대한 표준 가격만 지불하면 됩니다. 또한 스킬은 에이전트가 파티션 키를 확인하고 BigQuery 쿼리를 실행하기 전에 드라이 런을 실행하여 실수로 전체 테이블을 스캔하는 것을 방지하는 등 비용을 고려한 쿼리 패턴을 사용하도록 유도합니다. 또한 스킬은 GitHub에서 오픈소스로 제공되므로 팀에서 이를 감사하거나 포크하거나 자체 내부 표준에 맞게 커스텀 스킬을 작성할 수 있습니다.
액세스 제어를 위해 에이전트는 사용자 또는 사용자가 가장하는 서비스 계정으로 연결되어 행 및 열 수준 보안 정책이 자동으로 적용됩니다. 또한 관리자는 Identity and Access Management(IAM)를 통해 MCP 액세스를 제어하고, Model Armor를 통해 MCP 트래픽을 검사하고, VPC 서비스 제어 및 주 구성원 액세스 경계 정책을 통해 에이전트의 범위를 지정할 수 있습니다.
설치 및 시작하기
IDE 또는 터미널에서 1분 이내에 Data Agent Kit를 설정할 수 있습니다.
옵션 1: IDE 확장 프로그램 설치
-
IDE 확장 프로그램: VS Code, Antigravity IDE, Cursor 또는 VS Code 호환 편집기의 확장 프로그램 패널에서 'Google Cloud Data Agent Kit'를 검색합니다. VS Code Marketplace 또는 Open VSX에서 설치할 수도 있습니다.
-
Antigravity 2.0: 설정 > 맞춤설정 > Google 플러그인으로 빌드로 이동한 다음 Data Agent Kit를 다운로드합니다.
-
Cloud Shell 및 Cloud Workstations: 기본적으로 이미 설치되어 있으므로 편집기를 열고 로그인하기만 하면 됩니다.
옵션 2: CLI 플러그인 설치
공식 GoogleCloudPlatform/data-agent-kit-plugin 저장소를 사용하여 선호하는 코딩 에이전트에 대한 명령어를 실행합니다.
그런 다음 첫 번째 프롬프트를 입력합니다.
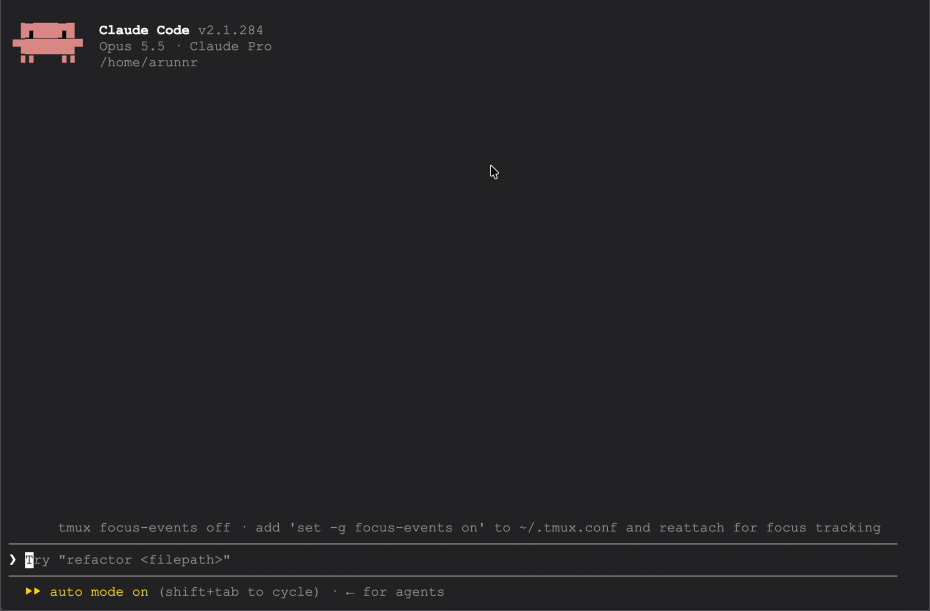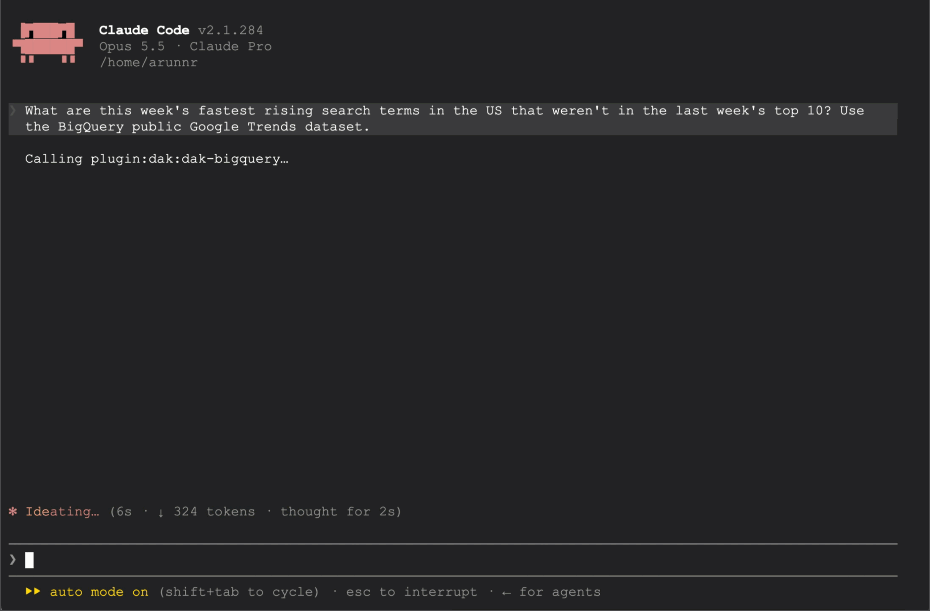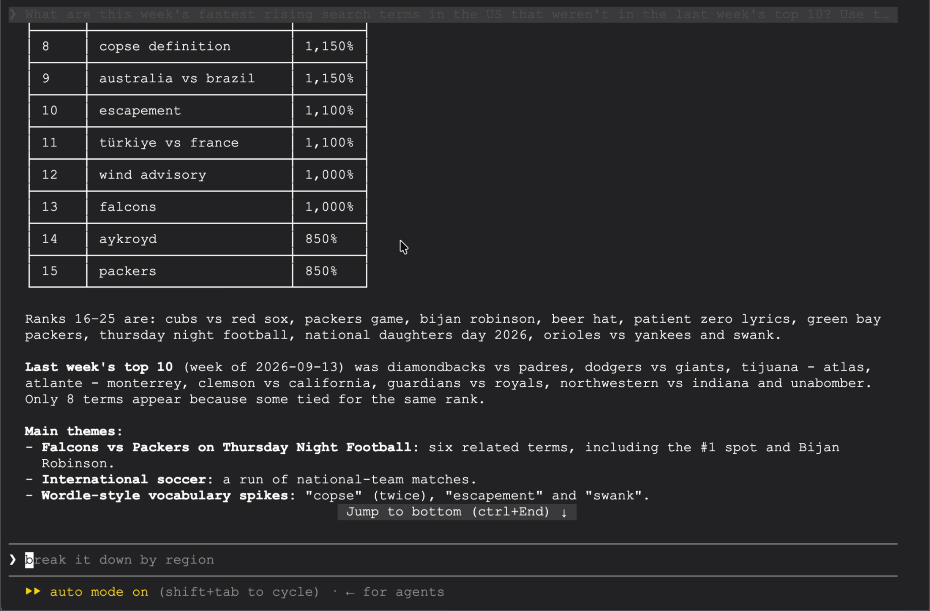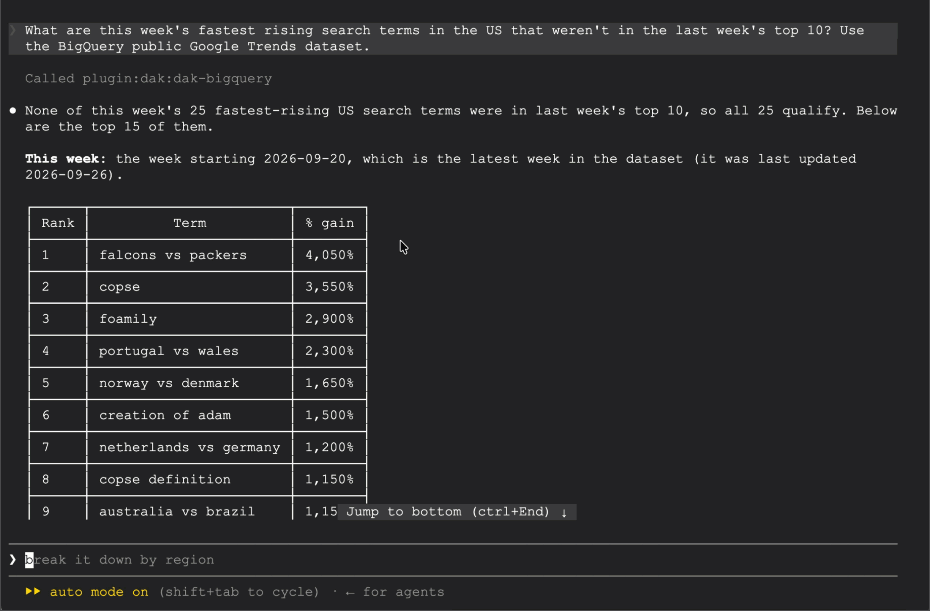
Claude Code에서 실행되는 Data Agent Kit 플러그인
다음 단계 및 실습 리소스
-
문서 읽기: Data Agent Kit 문서 및 제품 개요 페이지를 살펴보세요.
-
스킬 살펴보기: GitHub에서 스킬을 살펴보고, 별표를 표시하고, 기여해 보세요.
-
분석 워크플로 빌드: Data Agent Kit 및 Antigravity IDE를 사용한 분석 Codelab을 사용해 보고 관련 블로그인 Data Agent Kit를 사용한 에이전트 분석을 읽어보세요.
-
데이터 과학 파이프라인 빌드: Data Agent Kit 및 Antigravity IDE를 사용한 사기 감지 파이프라인 Codelab을 사용해 보세요.