KDDI에서 빌드한 더 빠르고 안정적인 소비자용 RAG 앱 Buffmee
Junichi Kashino
Platform Business Strategy Department, KDDI
Miki Katsuragi
AI Consultant, Google Cloud Japan
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
소비자용 생성형 AI 애플리케이션을 빌드할 때 다양한 미디어 유형에서 우수한 생성 품질과 빠른 응답 시간 사이의 균형을 유지하기 어려울 수 있습니다. 일본의 대형 통신사 KDDI는 소비자용 검색 증강 생성(RAG) 앱인 Buffmee를 개발하면서 이 과제에 정면으로 맞서 결국 문제를 해결했습니다.
Buffmee는 '성장을 돕는 AI'라는 개념을 기반으로 구축된 대화형 AI 서비스입니다. 도서, 잡지, 웹 미디어 등 100개 이상의 소스에 대답을 그라운딩하여 사용자가 정보를 검색하고, 핵심 사항을 요약하고, 맞춤형 학습 및 취미 관심분야를 탐색할 수 있도록 지원합니다. Buffmee에서는 출처를 인용하여 정보의 신뢰성에 대한 우려를 해소하므로 사용자가 안전하게 지식을 쌓을 수 있습니다.
앱 출시 과정에서 엔지니어팀은 도서와 잡지를 비롯한 다양한 독점 콘텐츠를 그라운딩해야 했습니다. 그러나 지연 시간 문제로 인해 응답 목표 시간을 충족하지 못했으며 할루시네이션 없는 결과를 보장할 수 있는 안정적인 방법도 필요했습니다.
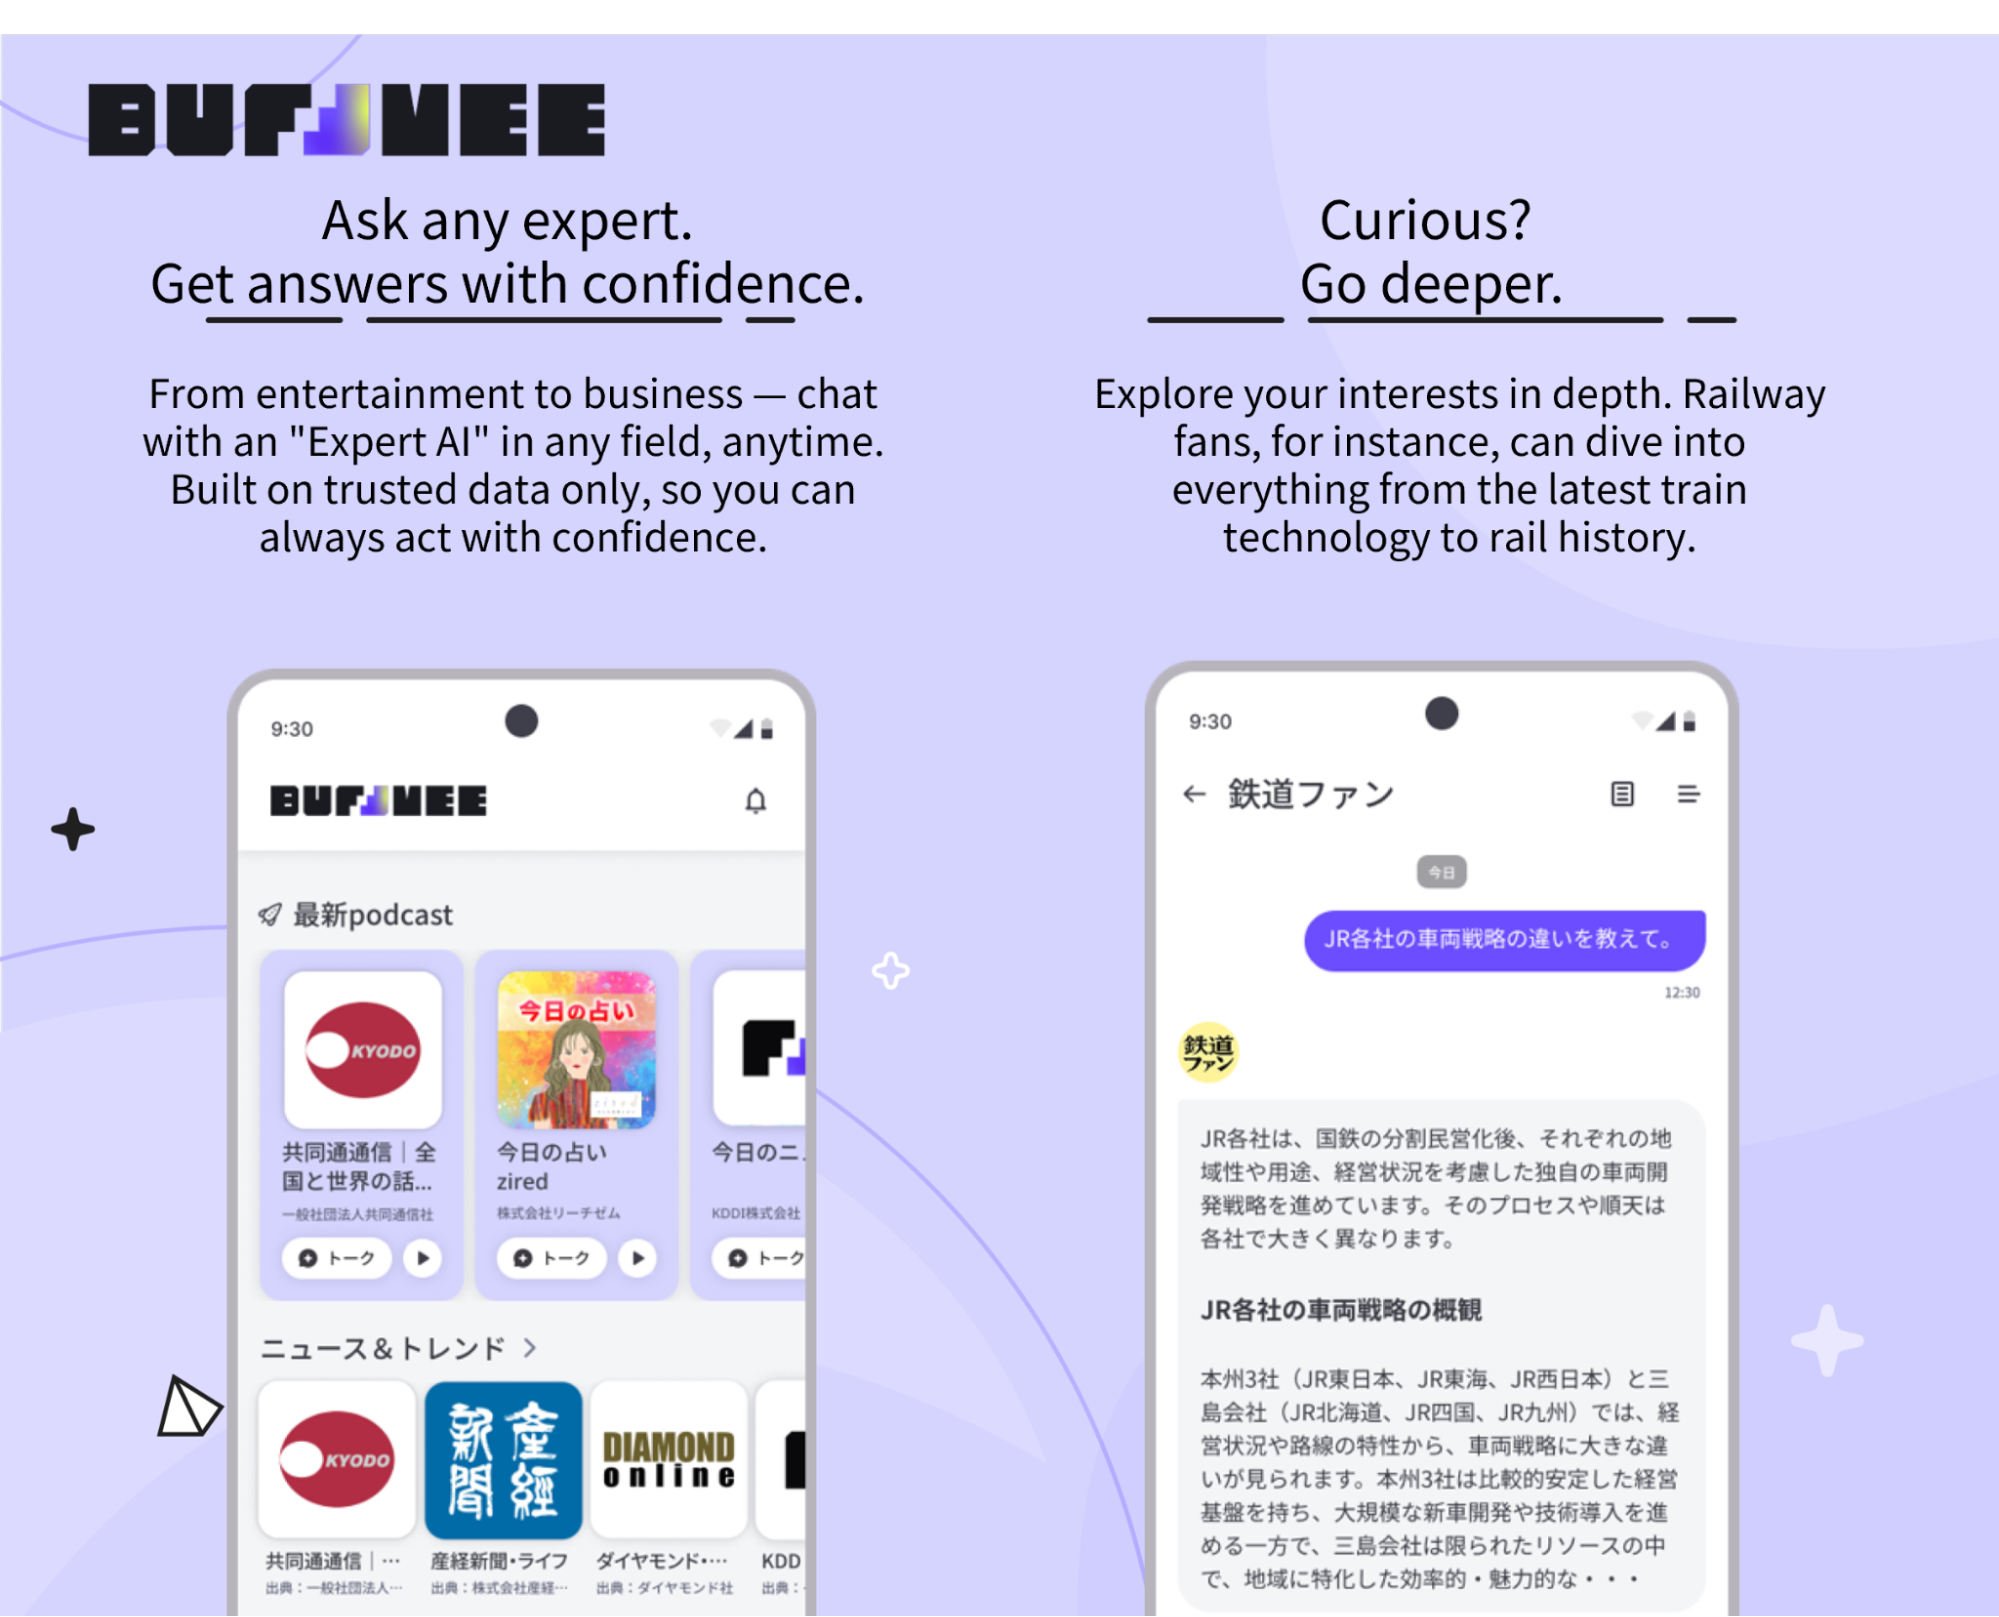
Buffmee 앱 설명 및 이미지
조직에서 이러한 성능 목표를 달성하려면 AI 평가와 실시간 병목 현상 식별에 대한 체계적인 접근방식이 필요합니다. 그렇기 때문에 KDDI의 성공적인 애플리케이션 출시에 도움이 되었던 자동 평가 프레임워크와 성능 최적화 기법을 공유하고자 합니다.
결과는 고무적이었습니다. KDDI는 총 애플리케이션 응답 지연 시간을 38% 줄여 응답 성능 목표를 성공적으로 달성했습니다. TTFT도 약 18% 개선되었습니다.
"KDDI의 비전을 달성하려면 콘텐츠가 수집되는 즉시 작동 가능한 RAG 시스템으로 기능하는 플랫폼을 구축해야 했습니다. Google의 세심한 실무 지원 덕분에 이를 실현할 수 있었습니다. Google의 지원에 진심으로 감사드립니다." — Shunya Onoda, KDDI AI 제품 부서
이처럼 성능과 정확성이 개선된 Buffmee는 콘텐츠 제공업체를 위한 엄격한 신뢰성과 규정 준수를 유지하면서 고도로 개인화된 경험을 제공하여 사용자가 대화형 Q&A와 심층 분석을 통해 좋아하는 미디어를 안전하게 탐색할 수 있게 되었습니다.
이러한 성과를 어떻게 달성했는지 자세히 살펴보겠습니다.
다양한 콘텐츠에 대한 자동 평가 설정
기존의 수동 테스트는 엄청난 노력이 필요할 뿐만 아니라 대규모 콘텐츠 라이브러리를 수용할 만큼 확장하기 어렵습니다. 이 문제를 해결하기 위해 개발팀에서 Gemini Enterprise Agent Platform Evaluation Service를 사용하여 체계적인 AI 평가 프로세스를 설계했습니다.
LLM-as-a-Judge 및 Rule of Hundreds와 같은 자동화된 평가 프레임워크를 구현하여 노동 집약적인 수동 테스트를 데이터 기반 프로세스로 대체했습니다. 방대한 문서 코퍼스를 수집하고, 수백 개의 자동 평가 테스트를 구성하고, 사용 사례별 대답의 신뢰성을 측정하기 위한 포괄적인 벤치마크 데이터 세트를 구축했습니다. 그 결과, 그라운딩 점수를 25% 개선하여 정확성과 신뢰성이 우수한 출력을 제공할 수 있게 되었습니다.
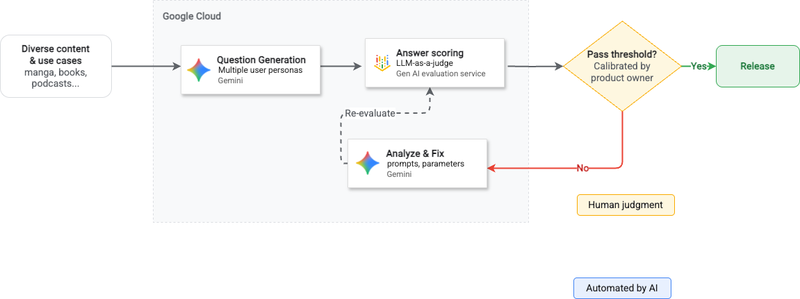
KDDI의 자동 평가 루프: AI가 질문을 생성하고 대답을 채점하면 인간이 기준점을 보정하고 특이 사례 실패를 분석합니다.
에이전트 루프를 통한 병목 현상 식별 및 성능 최적화
응답 속도를 개선하기 위해 BigQuery 에이전트 분석과 에이전트 개발 키트(ADK) 로그 분석 에이전트를 구현했습니다. 실제 프로덕션 로그를 분석하여 스킬 분할과 프롬프트 비대화(특히 여러 페이지로 이루어진 매우 복잡한 시스템 프롬프트)가 첫 번째 토큰까지의 시간(TTFT)에 어떤 영향을 미치는지 시각화했습니다.
스킬의 인라인 통합을 포함하여 시스템 프롬프트를 최적화하고 하위 에이전트 라우팅도 검토했습니다. 이를 통해 대답의 정확성을 저해하지 않고도 실시간으로 딥 스택 병목 현상을 식별하고 해결할 수 있었습니다.
신뢰할 수 있는 평가를 위한 4가지 핵심 원칙
이러한 결과를 얻기 위해 팀에서는 네 가지 핵심 기술 관행을 구현했습니다.
-
이진 평가로 전환: 중요한 측정항목에 대해 모호한 1~5점 평가 대신 이진 '통과(1)/실패(0)' 체계를 선택적으로 도입하여 분산과 노이즈를 최소화하고 자동화 정확성을 개선했습니다.
-
전략적 콘텐츠 샘플링: 모든 문서를 일일이 평가하는 대신 파일 형식(웹 기사, EPUB, PDF, 정형 데이터)과 미디어 구성(텍스트 중심, 이미지 중심, 혼합)이라는 2차원 그리드로 전체 코퍼스를 분류했습니다. 이 난이도 그리드의 각 셀에서 대표 샘플을 선택하여 포괄적인 테스트 범위를 유지하면서 평가 워크로드를 75% 줄였습니다.
-
제품 판단에 기반한 기준점: 제품 소유자가 기본 도구 파라미터에만 의존하지 않고 무작위로 샘플링된 대답을 자동 점수와 함께 검토하여 보정하고 사용자 경험 측면에서 충분한 '출시 품질'을 설정했습니다.
-
대규모 프롬프트를 ADK 스킬로 모듈식 분할: 800줄이 넘는 대규모 시스템 프롬프트는 LLM 어텐션 드리프트와 지연 시간 저하를 유발할 수 있으므로, 프롬프트를 기능별로 에이전트 개발 키트(ADK) 스킬로 분할하여 필요한 로직만 동적으로 로드하여 응답 시간을 최적화했습니다.
시작하기
확장 가능하고 안정적인 생성형 AI 애플리케이션을 빌드하려면 자동화된 평가와 심층적인 성능 분석이 모두 필요합니다. 이러한 기법을 자체 애플리케이션에 적용하려면 다음 단계를 따르세요.
-
Gen AI Evaluation Service를 사용하여 품질을 체계적으로 측정합니다.
-
에이전트 개발 키트로 에이전트를 구조화하고 점진적 공개를 신중하게 적용합니다.
-
Agent Search로 에이전트를 그라운딩하고 검색 쿼리를 검사합니다.