GKE 네트워킹을 확장하여 동시 실행 AI 에이전트의 고밀도 워크로드를 지원하는 방법
Srini Jasti
Group Product Manager
Venkat Krishnan
Software Engineer
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
고밀도 동시 실행 AI 에이전트를 조정하려면 무엇이 필요할까요? 정적 요청에서 자율적인 에이전트형 워크플로로 전환함에 따라 안전한 고밀도 샌드박스에 대한 필요성이 커지면서 기존 인프라는 아키텍처의 한계를 훨씬 뛰어넘는 요구사항에 직면하고 있습니다. 이러한 전환으로 인해 최고 수준의 연구소에서는 전례 없는 규모의 인프라를 요구하고 있으며, 최대 100만 개의 동시 코드 실행 샌드박스가 필요한 경우도 많습니다.
이러한 규모에서는 Kubernetes 네트워킹 인프라의 효율성이 에이전트 이니셔티브의 경제적 실행 가능성에 직접적인 영향을 미칩니다. 강화 학습(RL)과 같은 고급 워크플로에서는 극단적인 포드 제거로 인해 매분 수천 개의 격리된 샌드박스가 생성되고 삭제될 수 있습니다. 고가의 GPU와 TPU가 샌드박스 초기화를 기다리는 대신 모델을 실행하는 데 시간을 할애하도록 하려면 1초 미만의 프로비저닝과 매우 높은 컴퓨팅 밀도가 필요합니다.
GKE의 Agent Sandbox는 안전하고 가벼운 격리 기능을 제공하므로 이처럼 고도로 동적인 실행 환경을 지원하는 데 특히 적합합니다. 또한 수백만 개의 동시 유휴 세션이 존재하는 차세대 워크로드의 경우 GKE의 Agent Substrate는 이러한 기본 기능을 바탕으로 더 높은 밀도와 1초 미만의 상태 리하이드레이션 기능을 제공합니다.
이 게시물에서는 GKE Dataplane V2가 네트워크 ID 관리를 최적화하고, ID 확장 한도 문제를 해결하며, 1초 미만의 프로비저닝을 지원하여 대규모 고밀도 AI 에이전트 워크로드를 처리하는 방법을 알아봅니다.
일반적인 확장 과제: 네트워크 ID 관리
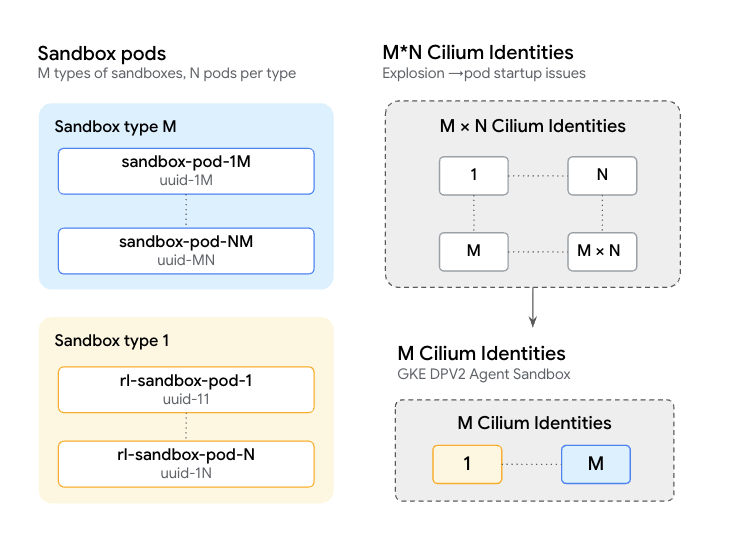
대규모 동시 실행 환경을 운영하다 보면 새로운 엔지니어링 과제가 발생하는데, 특히 네트워크 ID를 관리하는 방식에서 이러한 문제가 두드러집니다. 일반적으로 커스텀 컨트롤러와 워크로드 조정자는 각 포드에 고유한 동적 라벨(예: agent-id, 타임스탬프, claim-uid)을 할당하는 경우가 많습니다.GKE Dataplane V2는 eBPF 기술을 기반으로 하며, 포드 라벨을 숫자 ID에 매핑하여 강력한 네트워크 보안 정책을 적용할 수 있도록 지원합니다. 에이전트형 워크플로에서는 포드마다 고유한 라벨이 생성되므로 시스템은 각 샌드박스에 고유한 ID를 선제적으로 프로비저닝합니다. 빠르게 변화하는 환경에서 이러한 순차적 할당 프로세스는 시스템이 eBPF 맵을 안전하게 업데이트하는 동안 포드 생성을 일시적으로 중단시킬 수 있으며, 이로 인해 초기화 시간이 예상보다 길어질 수도 있습니다. 또한 정교한 워크로드에서는 네트워크 ID가 빠르게 생성되거나 워크로드 자체의 규모가 커지면서 클러스터 전체에 적용되는 65,536개의 한도에 도달할 수 있습니다.
에이전트 시대를 위한 GKE 네트워크 데이터 영역의 혁신
안정적이고 보안 수준이 높은 플랫폼을 제공하는 것은 Google Cloud가 수행하는 모든 일의 기본 원칙입니다. 따라서 Google Cloud는 더 높은 확장성과 성능을 제공하면서도 기존의 ID 및 보안 제어 기능을 유지할 수 있는 방법을 찾아야 했습니다. 바로 이 부분에서 GKE Dataplane V2의 아키텍처 혁신이 중요한 역할을 합니다. 한 고객은 GKE에서 Agent Substrate를 사용하여 클러스터 전반에서 수십만 개의 안전한 환경을 조정하고, 단일 클러스터에서 샌드박스가 30,000개 이상으로 급증하는 상황도 성공적으로 처리했다고 밝혔습니다.
이를 위해 GKE는 다음과 같은 두 가지 네트워킹 접근 방식을 사용합니다.
카디널리티가 높은 데이터 마이그레이션
Google의 GKE Dataplane V2는 '식별' 데이터를 '기능' 메타데이터와 분리합니다. 서비스 선택기 일치 또는 핵심 리소스 그룹화에 적극적으로 참여하지 않는 필드는 포드의 라벨 집합에서 주석 집합으로 마이그레이션되어야 합니다. GKE Dataplane V2는 주석이 아닌 라벨을 기반으로 네트워크 ID를 지능적으로 계산하므로, 이러한 카디널리티가 높은 메타데이터를 라벨에서 다른 곳으로 이전하면 포드마다 별도의 ID를 생성할 필요가 없습니다. 이러한 세련된 방식의 전환을 통해 가시성을 희생하지 않고도 ID 확장 한도 문제를 근본적으로 해결할 수 있습니다.
고급 Cilium 라벨 필터링
또한 !agents.x-k8s.io/sandbox-name-hash 또는 !timestamp와 같은 규칙을 구성하여 정확한 라벨 제외 필터를 적용하면(예: kube-system의 cilium-config-emergency-override ConfigMap 사용) GKE Dataplane V2가 보안 ID 계산 중에 이러한 동적 라벨을 무시하도록 명시적으로 지정할 수 있습니다.
즉, 개발자 프레임워크에서 의도치 않게 카디널리티가 높은 라벨을 도입하더라도 적절한 제외 필터를 구성하면 Google의 네트워크 데이터 영역에서 해당 라벨을 자동으로 제외할 수 있습니다.
그 결과 동일한 유형의 에이전트가 하나의 Cilium 포드 ID를 계속 공유하므로 동적 AI 워크로드에 필수적인 초저지연 시작 시간을 유지할 수 있습니다. GKE는 ID가 선형적으로 증가하는 것을 방지하고 Cilium의 65,536개 ID 한도에 도달하지 않도록 하여 완전히 격리된 에이전트를 위해 1초 미만의 지연 시간으로 초당 300개의 샌드박스를 프로비저닝하는 뛰어난 속도와 효율성을 제공합니다.
향후 계획
매우 높은 수준의 성능, 확장성, 밀도가 필요한 워크로드의 경우 Agent Substrate는 이러한 GKE Dataplane V2 권장사항을 기본적으로 통합하는 동시에 Kubernetes 예약 한도를 우회하여 GKE의 성능과 확장성을 더욱 향상합니다. 200,000개의 에이전트를 실행하는 벤치마크 검증에서 Agent Substrate는 500ms 미만의 일시중지 및 재개 지연 시간으로 초당 500회의 활성화를 유지했습니다. 지금 바로 기존 GKE 클러스터에 배포하여 가장 까다로운 AI 워크플로에서도 유휴 컴퓨팅 비용을 최소화할 수 있습니다.
GKE Dataplane V2는 네트워크 ID 계산을 최적화하고 카디널리티가 높은 메타데이터를 필터링하여 대규모 AI 워크로드에서 발생하는 주요 인프라 병목 현상을 해결합니다. 이러한 아키텍처 개선을 통해 샌드박스 프로비저닝 지연 시간을 1초 미만으로 줄이고, 고가의 GPU 유휴 시간을 최소화하며, 높은 컴퓨팅 밀도를 유지할 수 있습니다. 궁극적으로 이러한 효율성 덕분에 운영 비용을 관리하면서 에이전트 AI 운영 규모를 안정적으로 확장할 수 있습니다.
자세한 내용은 GKE의 Agent Sandbox와 Agent Substrate를 살펴보세요.