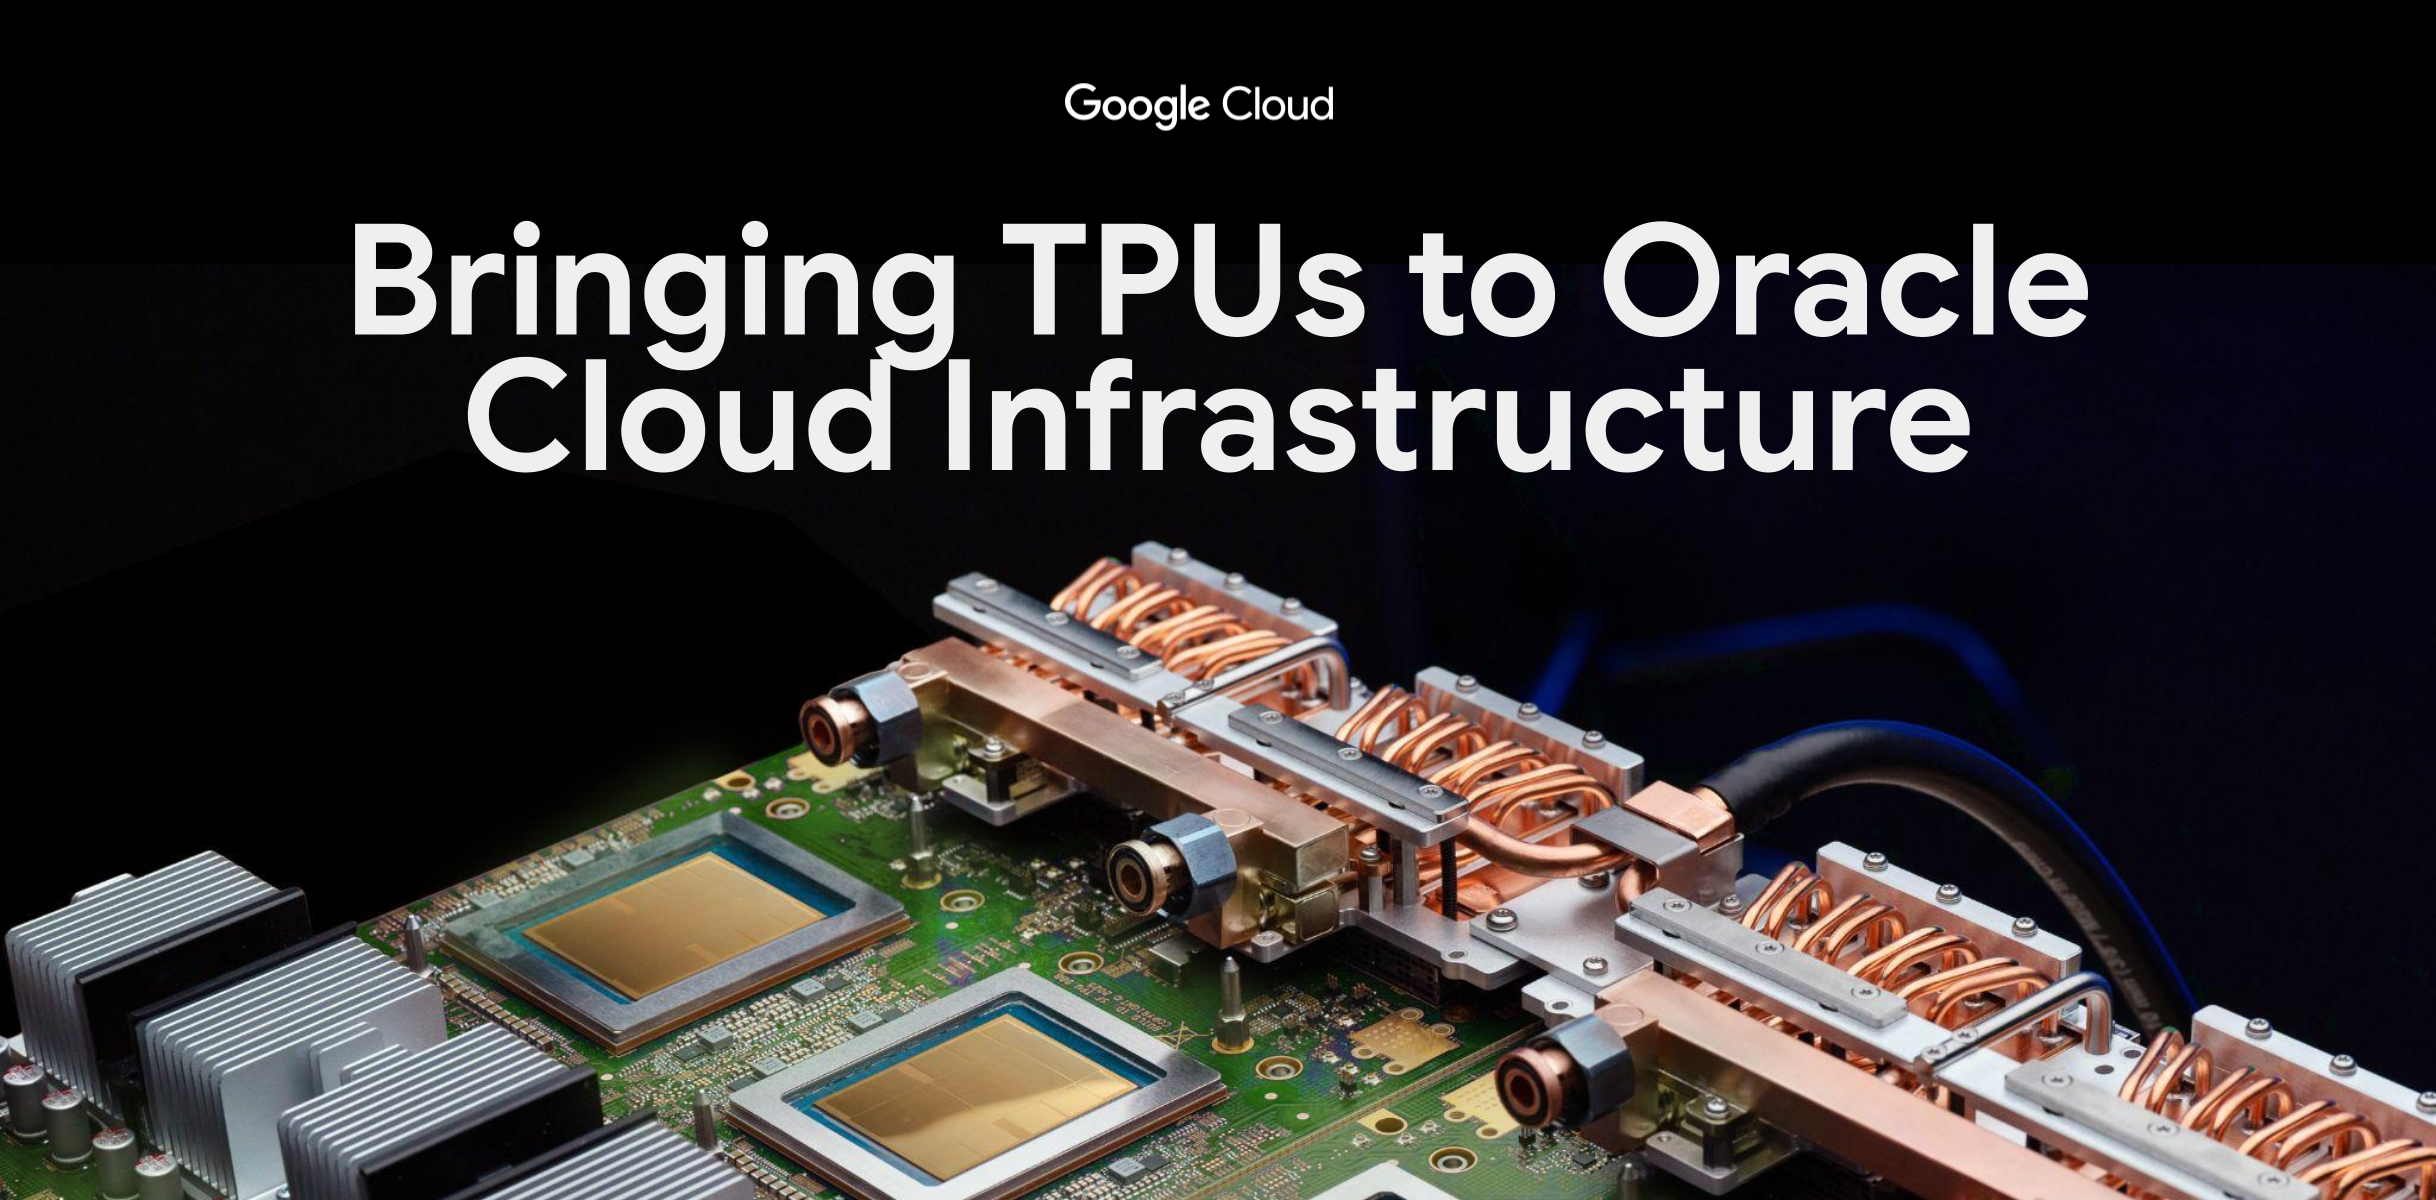
Oracle Cloud Infrastructure에 Google TPU 도입
Karan Batta
Senior Vice President, Oracle Cloud Infrastructure
Gurmeet Goindi
Sr. Director, Product Management
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
모든 산업에서 AI 워크로드가 확대되면서 기업들은 AI 수명 주기 전반에 걸쳐 처리량, 지연 시간, 단위 경제성을 최적화할 수 있는 컴퓨팅 옵션을 필요로 하고 있습니다. 이러한 수요에 대응하기 위해 Oracle과 Google Cloud가 파트너십을 통해 Oracle Cloud Infrastructure(OCI)에 Google Tensor Processing Unit(TPU)을 제공합니다. 이로써 OCI는 Google 외에 최초로 TPU를 지원하는 하이퍼스케일 클라우드 제공업체가 되며 양사는 2027년부터 OCI에 TPU 용량을 배포할 계획입니다.
TPU: 반도체부터 소프트웨어까지 아우르는 공동 설계
Google은 10여 년 전에 맞춤형 반도체를 광 네트워킹, 전력 공급, 액체 냉각, 컴파일러 소프트웨어와 함께 설계하면 개별 구성요소를 따로 최적화하는 것만으로는 달성할 수 없는 와트당 성능과 총소유비용 개선 효과를 얻을 수 있다는 명확한 설계 철학을 바탕으로 최초의 TPU를 개발했습니다.
TPU v1은 당시 프로세서보다 와트당 처리량이 30배 높았습니다. 현재 TPU는 수십억 명의 사용자가 이용하는 Google 제품 전반에서 Gemini 모델의 학습과 서빙을 지원하고 있습니다. 8세대 TPU는 칩당 최대 12.6PFLOPS의 네이티브 FP4 컴퓨팅 성능을 제공하며, 이는 TPU v1의 92TFLOPS보다 100배 이상 높은 수준입니다. 와트당 성능도 이전 세대보다 최대 2배 향상되었습니다. 하지만 학습과 추론 전반에서 고객이 얻는 경제적 이점은 단순히 FLOPS 수치만으로 결정되지 않습니다. 학습에서 중요한 측정항목은 클러스터가 실제로 유효한 연산을 수행하는 시간의 비율인 굿풋입니다. 추론에서는 지연 시간과 토큰당 비용이 핵심 측정항목입니다. TPU는 시스템 수준의 공동 설계를 통해 두 영역 모두에서 효율성을 높입니다.
컨트롤 플레인은 온다이(on-die) 칩 간 상호연결(ICI) 라우팅과 광회선 교환(OCS)을 결합하여 하드웨어나 링크의 성능 저하를 감지하고, 작업을 다시 시작하지 않고도 장애 구간을 우회하도록 광 경로를 실시간으로 재구성합니다. 이로써 수천 개의 칩을 사용하는 대규모 학습 실행 중에도 97% 이상의 굿풋을 유지하고 프로덕션 서빙 환경에서도 높은 가용성을 확보할 수 있습니다. 또한 칩 내 SRAM과 HBM 용량을 늘리고, 네트워크 홉 수를 50% 이상 줄이는 새로운 저직경 상호연결 토폴로지를 도입했습니다. 이를 통해 최신 세대 TPU는 지연 시간이 짧은 서빙 워크로드에서 달러당 성능을 최대 80% 높일 수 있습니다.
이러한 하드웨어 효율성이 실제 개발 속도 향상으로 이어지려면 개발자가 기술을 쉽게 도입할 수 있어야 합니다. Google은 최근 PyTorch Conference에서 발표한 내용을 통해 Google TPU 소프트웨어 생태계를 PyTorch 커뮤니티에 개방적이고 개발자 친화적인 환경으로 만들겠다는 의지를 다시 한번 강조했습니다. 특히 Google TPU용 네이티브 PyTorch 스택인 TorchTPU가 이제 GitHub에서 오픈소스로 제공됩니다. 이제 vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec, Hugging Face, LiteRT와 같은 기존 도구를 사용하여 TPU에서 모델을 학습, 서빙, 배포할 수 있습니다.
이러한 이식성 덕분에 팀은 모델 코드를 다시 작성하지 않고도 워크로드별로 토큰당 비용이 가장 낮거나 학습 시간이 가장 짧은 가속기를 선택할 수 있습니다. 또한 이번 발표를 통해 앞으로는 Google Cloud뿐 아니라 Oracle 인프라의 TPU에서도 워크로드를 실행할 수 있게 됩니다.
OCI를 통한 AI 인프라 생태계 확장
Google Cloud에서 TPU 도입이 확대되고 있지만, 전 세계 AI 컴퓨팅 수요는 단일 클라우드 제공업체의 인프라만으로 감당하기 어려운 수준입니다. OCI에서 TPU를 제공하면 고객은 다음과 같은 네 가지 이점을 얻을 수 있습니다.
-
고밀도 AI 워크로드에 최적화된 데이터 센터: Google TPU 시스템은 랙 규모의 직접 액체 냉각을 고려해 설계되었으며, OCI의 차세대 데이터 센터 역시 이러한 요구사항에 맞춰 구축됩니다. Oracle은 고객 수요 변화에 따라 프런티어 모델 학습과 프로덕션 추론 사이에서 유연하게 전환할 수 있는 안정적인 컴퓨팅 용량을 제공합니다. TPU의 높은 효율성과 Oracle의 혁신적인 전력 공급 및 냉각 기술을 결합하면 에너지 효율적인 AI 컴퓨팅 용량을 전 세계에 신속하고 대규모로 제공할 수 있습니다.
-
Oracle Acceleron을 통한 안전한 고성능 네트워킹: TPU가 ICI와 OCS를 통해 칩 간 트래픽을 처리하는 동안, Oracle Acceleron은 TPU 컴퓨팅 용량을 OCI의 나머지 인프라와 연결하는 네트워킹 기반을 제공합니다. Acceleron의 SmartNIC는 하드웨어 수준의 테넌트 격리를 지원하며, High Performance Fabric과 제로 트러스트 패킷 라우팅을 함께 활용합니다. 이를 통해 호스트 컴퓨팅 리소스에 부담을 주거나 보안 경계를 약화하지 않으면서도 Oracle 데이터베이스, 스토리지, TPU 클러스터 간에 높은 처리량과 짧은 지연 시간으로 데이터를 전송할 수 있습니다.
-
엔터프라이즈 데이터와의 근접성: Oracle 데이터베이스는 기업의 공식 기록을 관리하는 핵심 시스템으로 사용되는 경우가 많습니다. OCI 내에서 TPU를 직접 제공하면 기업은 비용이 많이 드는 크로스 클라우드 데이터 전송 없이 기존 엔터프라이즈 데이터와 가까운 환경에서 모델 미세 조정과 추론을 실행할 수 있습니다.
-
다양한 아키텍처를 선택할 수 있는 유연성: OCI에서 GPU와 TPU를 함께 제공하는 팀은 비용과 성능을 고려해 AI 워크로드의 각 단계에 가장 적합한 가속기를 유연하게 선택할 수 있습니다.
Google Cloud와 Oracle은 Oracle Cloud Infrastructure에 Google TPU를 도입함으로써 10년 넘게 축적해 온 특화 AI 시스템 엔지니어링 기술을 더 많은 개발자가 활용할 수 있도록 지원하고 있습니다. 고객이 여러 클라우드에서 특화된 컴퓨팅 옵션을 더 다양하게 선택할 수 있게 되면 업계 전체의 개발 속도와 운영 효율성이 높아집니다. 여러분이 빌드할 멋진 결과물을 기대하겠습니다.