Knowledge Catalog의 새로운 자체 학습 컨텍스트 보강 기능 소개
Firat Elbey
Group Product Manager, Data Analytics
Vasiya Krishnan
Product Lead
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
오늘 Google Cloud는 에이전트를 위한 컨텍스트 엔진인 Knowledge Catalog에서 자체 학습 컨텍스트 보강(프리뷰) 기능과 새롭게 단장한 Knowledge Studio 환경(프리뷰)을 출시합니다. Knowledge Catalog의 기존 Gemini 기반 보강 기능을 토대로 발전시킨 자체 학습 보강 기능은 에이전트와 사용자 간 상호작용을 분석합니다. 이를 통해 정보의 공백을 찾아내고, 변화하는 비즈니스 컨텍스트를 정확하게 최신 상태로 유지해 줍니다. Knowledge Studio는 컨텍스트 엔지니어와 데이터 관리자가 대화하듯 데이터 자산을 탐색할 수 있는 새로운 지휘 센터입니다. 이곳에서 시각화된 컨텍스트 그래프를 자유롭게 살펴보고, 제안된 변경 사항이 사용자나 에이전트에게 게시되기 전에 미리 꼼꼼하게 검토할 수 있습니다.
에이전트의 성능은 추론에 활용할 수 있는 조직 전반의 정의, 규칙, 관계, 즉 컨텍스트에 따라 달라집니다. 이것이 바로 컨텍스트 큐레이션이 엔터프라이즈 에이전트 기능에서 가장 중요한 분야 중 하나로 꼽히는 이유입니다. 오늘날 이러한 작업의 대부분은 수작업으로 이루어집니다. 컨텍스트 엔지니어는 에이전트마다 일일이 프롬프트와 매핑을 작성하고, 데이터 관리자는 수천 개의 애셋에 걸쳐 정의를 수동으로 최신 상태로 유지하려 노력합니다. 하지만 에이전트 수가 소수에서 수천 개, 나아가 수백만 개로 늘어나면 이러한 방식은 더 이상 통하지 않게 됩니다.
Knowledge Catalog의 Gemini 기반 자체 학습 보강 기능은 이러한 수동 유지보수를 지속적인 피드백 루프로 전환합니다. 에이전트와 사용자 간의 상호작용을 분석하여 누락되었거나 오래된 컨텍스트를 집어내고, 플레이북, 코드 저장소, 비즈니스 문서에서 검증된 정의를 추출하여 거버넌스가 적용된 재사용 가능한 컨텍스트 세트로 구성합니다. 그런 다음 최적화된 검색을 통해 모든 에이전트는 비대해진 프롬프트와 원시 스키마를 추론하는 대신, 필요한 정확한 컨텍스트를 얻고 조직 전체에 축적된 학습 성과를 같이 누릴 수 있습니다. 내부 벤치마크에 따르면 Knowledge Catalog는 AI 에이전트의 정확성을 약 4배 높이고 지연 시간을 최대 33% 줄이며 토큰 사용량을 최대 75% 줄입니다.
Gemini 기반의 자체 학습 보강 기능으로 컨텍스트를 최신 상태로 유지하세요
Gemini 에이전트에게 "지난 분기 EMEA 지역의 순매출은 얼마였나요?"라며 간단한 질문을 던지는 상황을 떠올려 보세요. 이 질문에 정확하게 답하려면 회사가 순매출을 어떻게 정의하는지, 어떤 테이블에 예약이 포함되어 있는지, 어떻게 조인하는지 알아야 하지만, 이러한 정보는 일반적으로 Google Docs의 재무 플레이북, GitHub의 데이터 모델, Confluence 페이지에 흩어져 있습니다. 정적 카탈로그 방식에서는 에이전트가 적절한 데이터를 효과적으로 쿼리할 수 있도록, 주제별 전문가가 비즈니스 정의, 측정항목 및 기타 컨텍스트를 사전에 수동으로 캡처하고 업데이트해야 합니다. 하지만 현실적으로 전문가가 모든 자산을 문서화할 시간적 여유가 있는 경우는 드뭅니다. 또한 재무팀이 다음 분기에 파트너 크레딧 처리 방식을 수정하는 순간, 기존의 정적 정의는 시대에 뒤처지게 되고 하드코딩된 수식을 사용하는 모든 에이전트가 잘못된 답변을 내놓기 시작합니다.
Knowledge Catalog의 보강 기능은 팀의 모든 문서, 저장소, 테이블 등 비즈니스 지식이 이미 보관되어 있는 곳에서 작동합니다. 퍼스트 파티 및 서드 파티 소스의 정형 데이터와 Cloud Storage, Google Workspace, GitHub, Confluence, SharePoint의 비정형 데이터에 연결됩니다. 이 기능은 사용자를 대신해 비즈니스 지식을 찾아내고 추출, 조합 및 유지 관리합니다. 또한 플레이북이나 위키와 같은 비정형 소스와 그 컨텍스트를 테이블 및 스키마와 같은 Knowledge Catalog의 정형 메타데이터에 연결함으로써, 정형 데이터의 발견 가능성과 활용도를 획기적으로 높여 줍니다. 주문형 또는 일정에 따라 비즈니스 정의, 테이블 및 열 설명, 조인 관계, 표준 쿼리, 작업별 에이전트 요청 사항을 제안하며, 각 제안에는 소스 인용과 신뢰도 점수가 포함됩니다. 실행할 때마다 소스에서 변경된 사항을 감지하고, 오래된 정의를 폐기하고, 검토가 필요한 충돌을 표시합니다.
사용자와 에이전트의 상호작용을 모두 학습합니다. Gemini 에이전트, BigQuery의 대화형 분석 또는 커스텀 에이전트의 상호작용 추적을 분석하도록 보강 기능을 설정할 수 있습니다. 이 과정에서 개인 식별 정보(PII)가 수정되며, 모호한 열 조회, 근거 없는 측정항목, 누락된 정의 또는 사용자가 같은 질문을 반복하는 등 에이전트가 어려움을 겪는 지점을 정확하게 찾아낼 수 있습니다. 그런 다음 신뢰할 수 있는 답변을 찾아 수정안을 마련함으로써, 동일한 실수가 반복되지 않도록 합니다. 컨텍스트 엔지니어링은 이와 같은 방식으로 수백만 건의 에이전트 상호작용에 대응하며, 전문가가 변경 사항을 처음부터 직접 작성할 필요 없이 변경 사항을 검토하는 데 집중할 수 있도록 지원합니다.
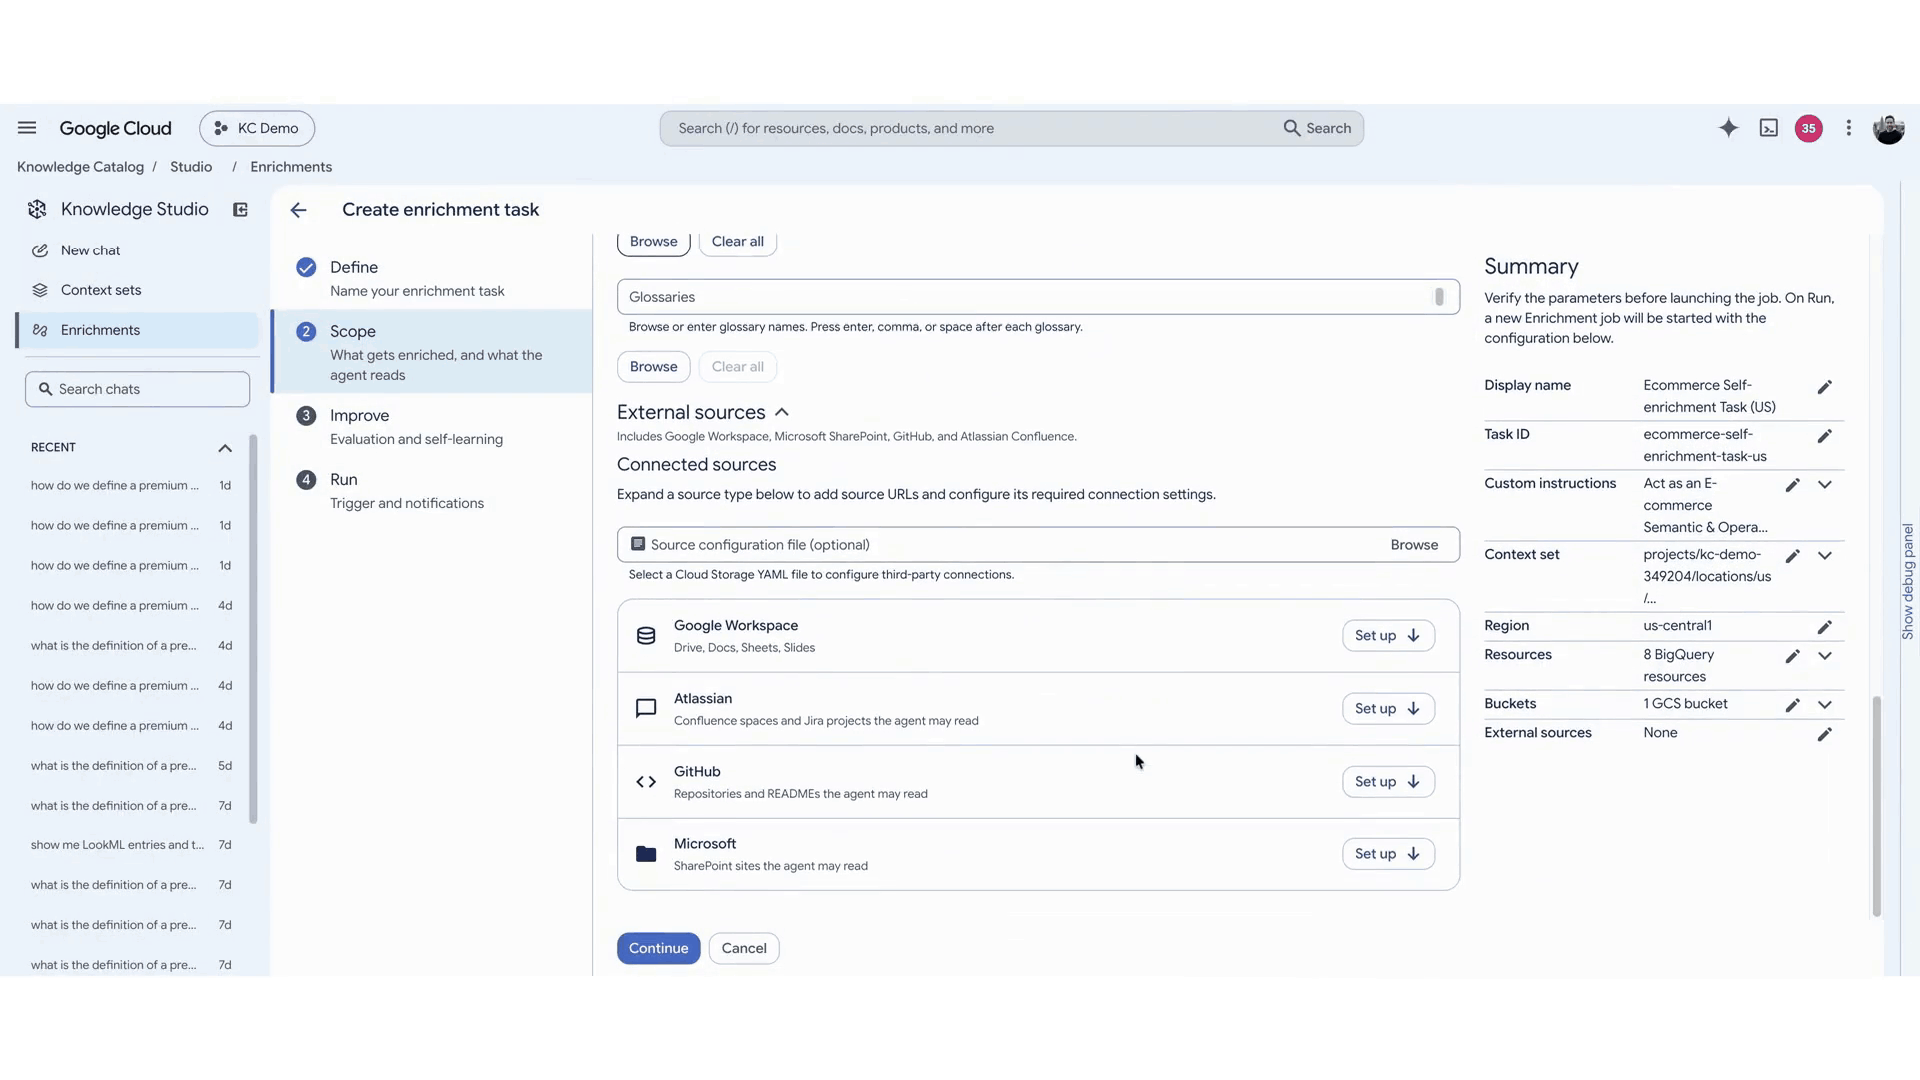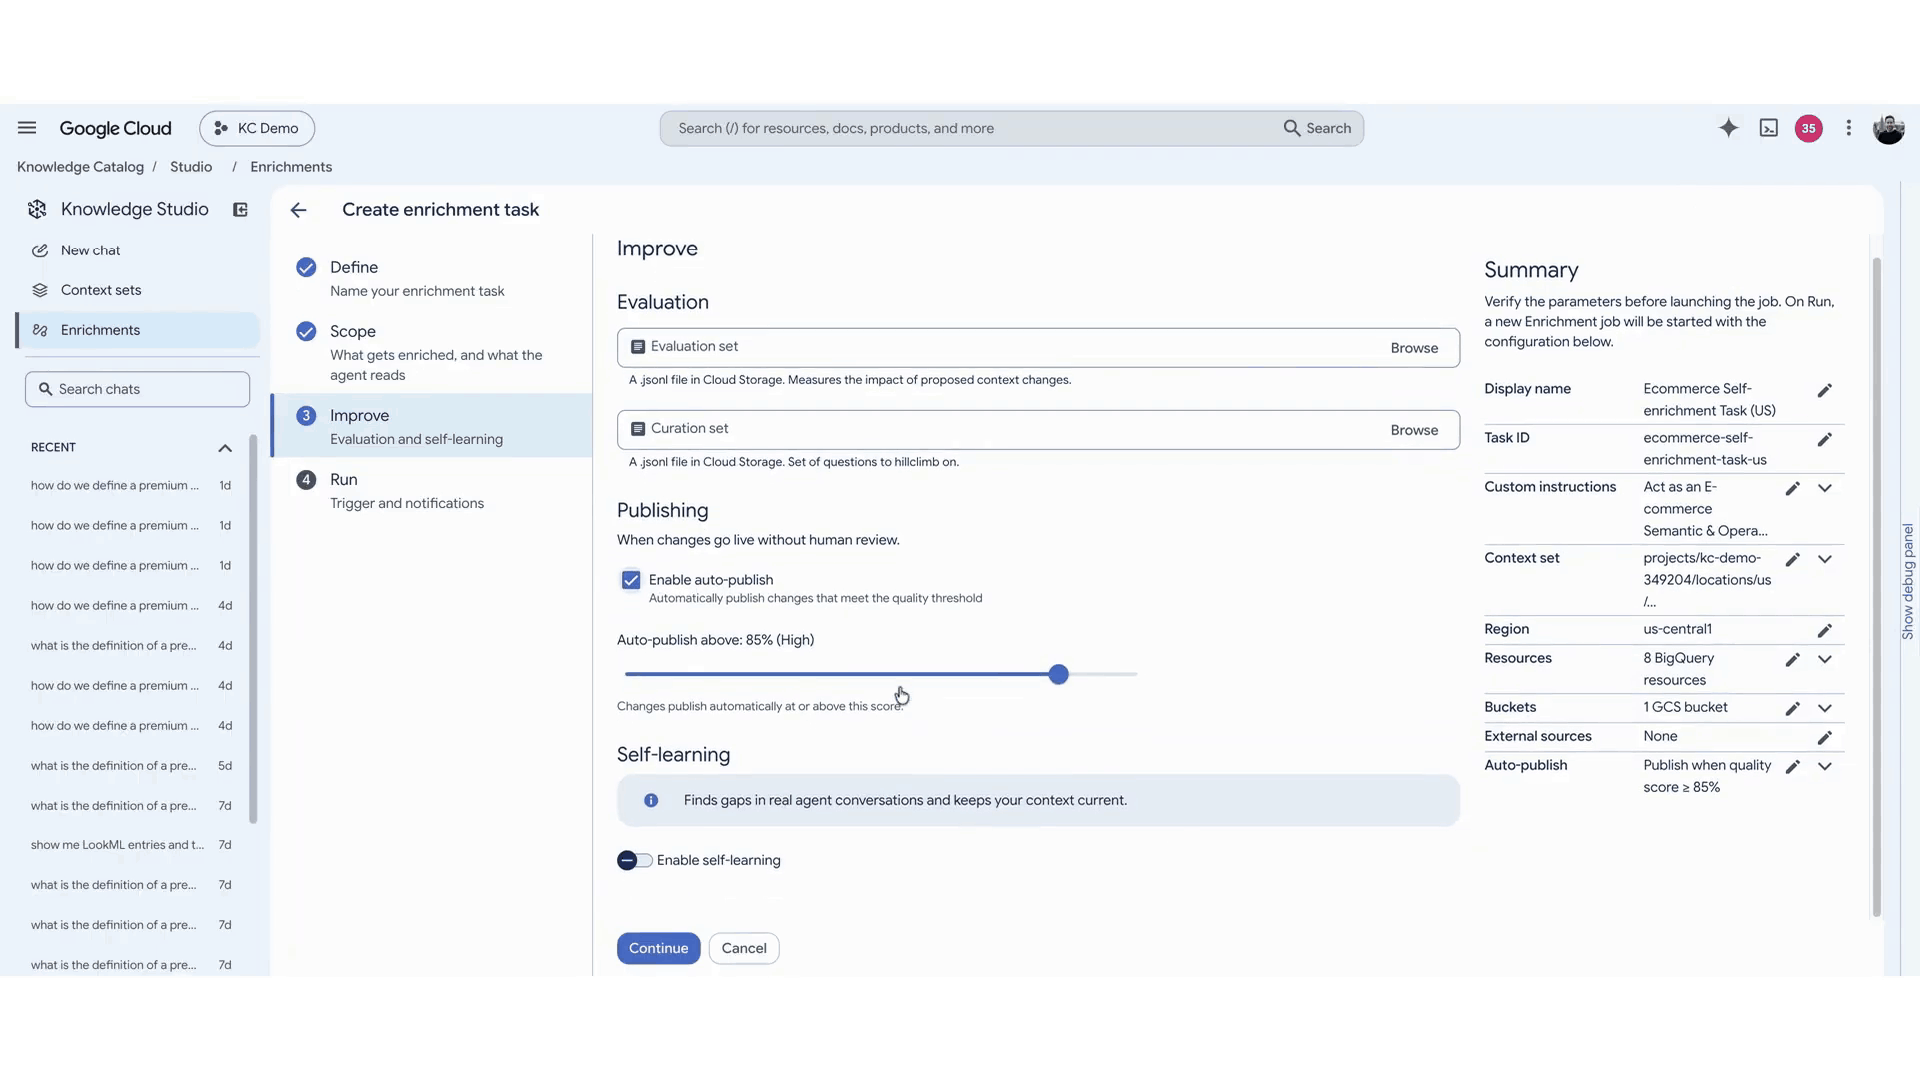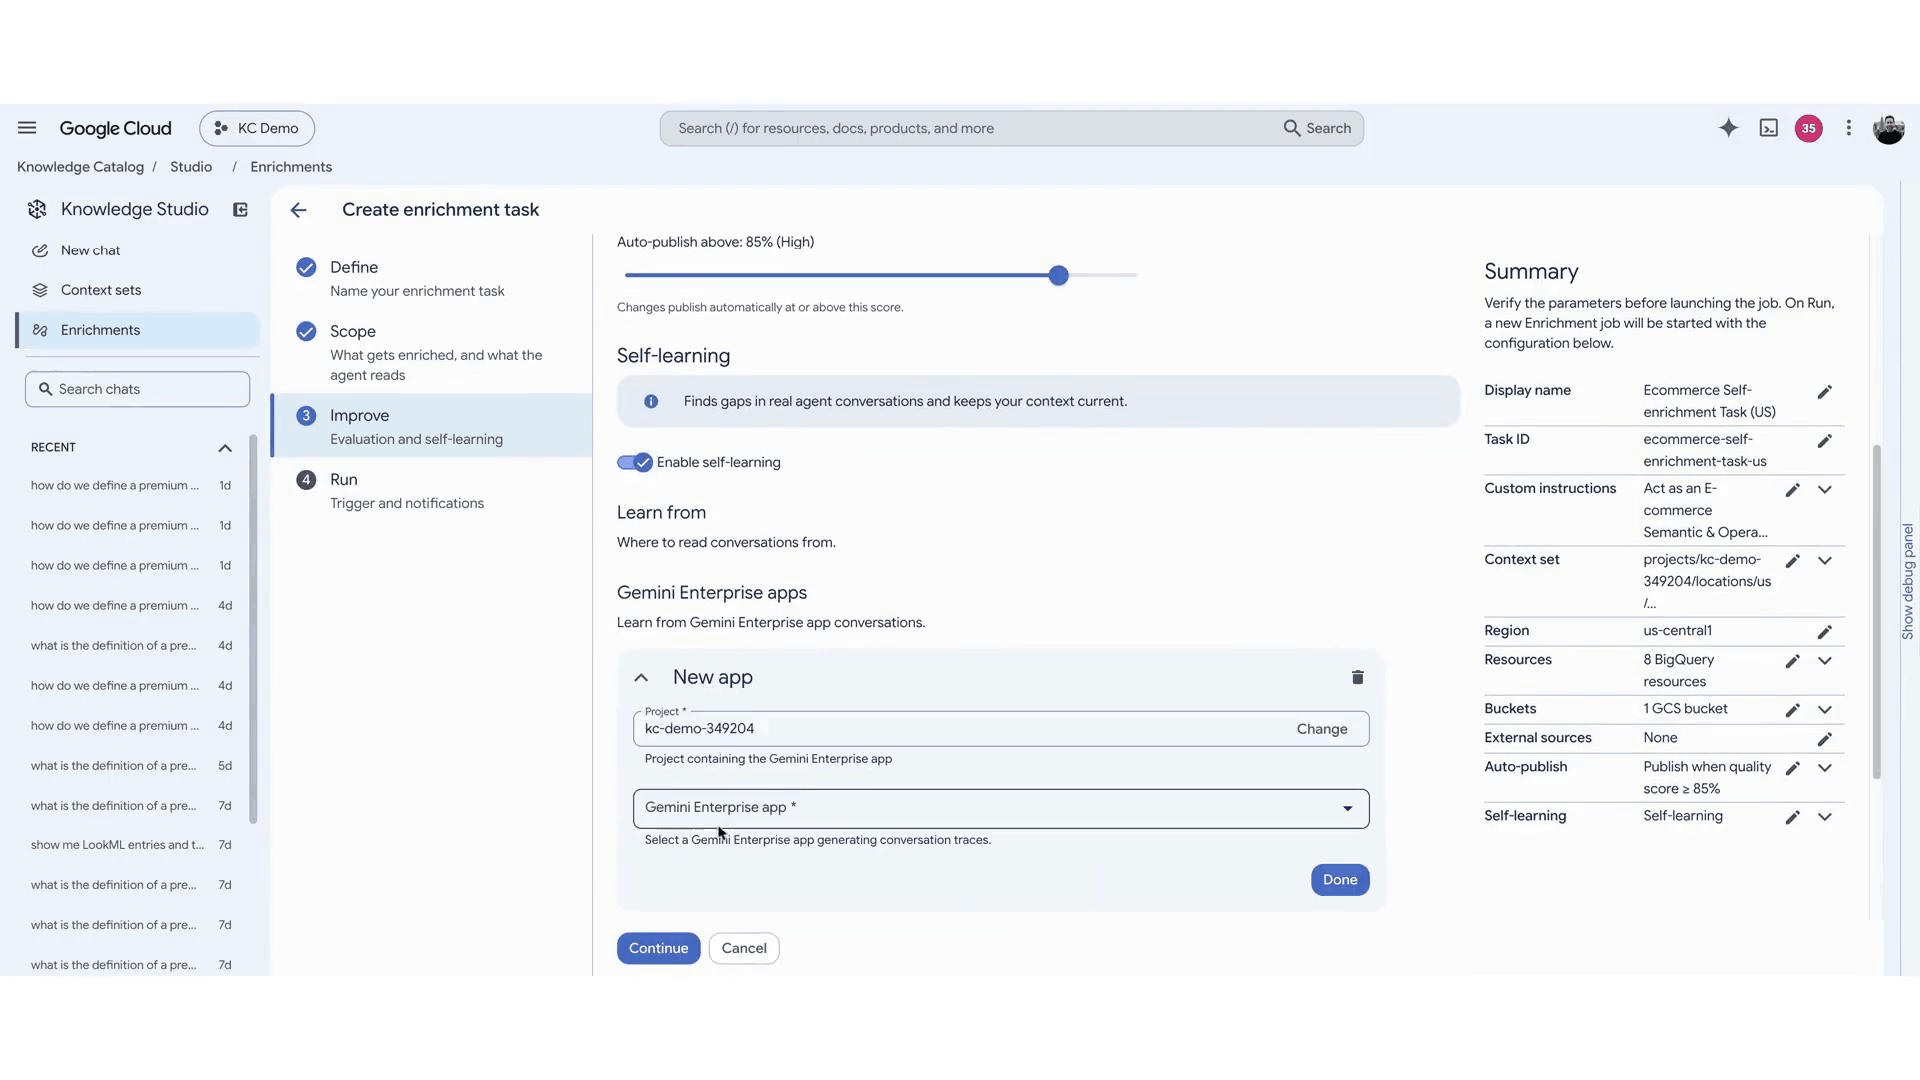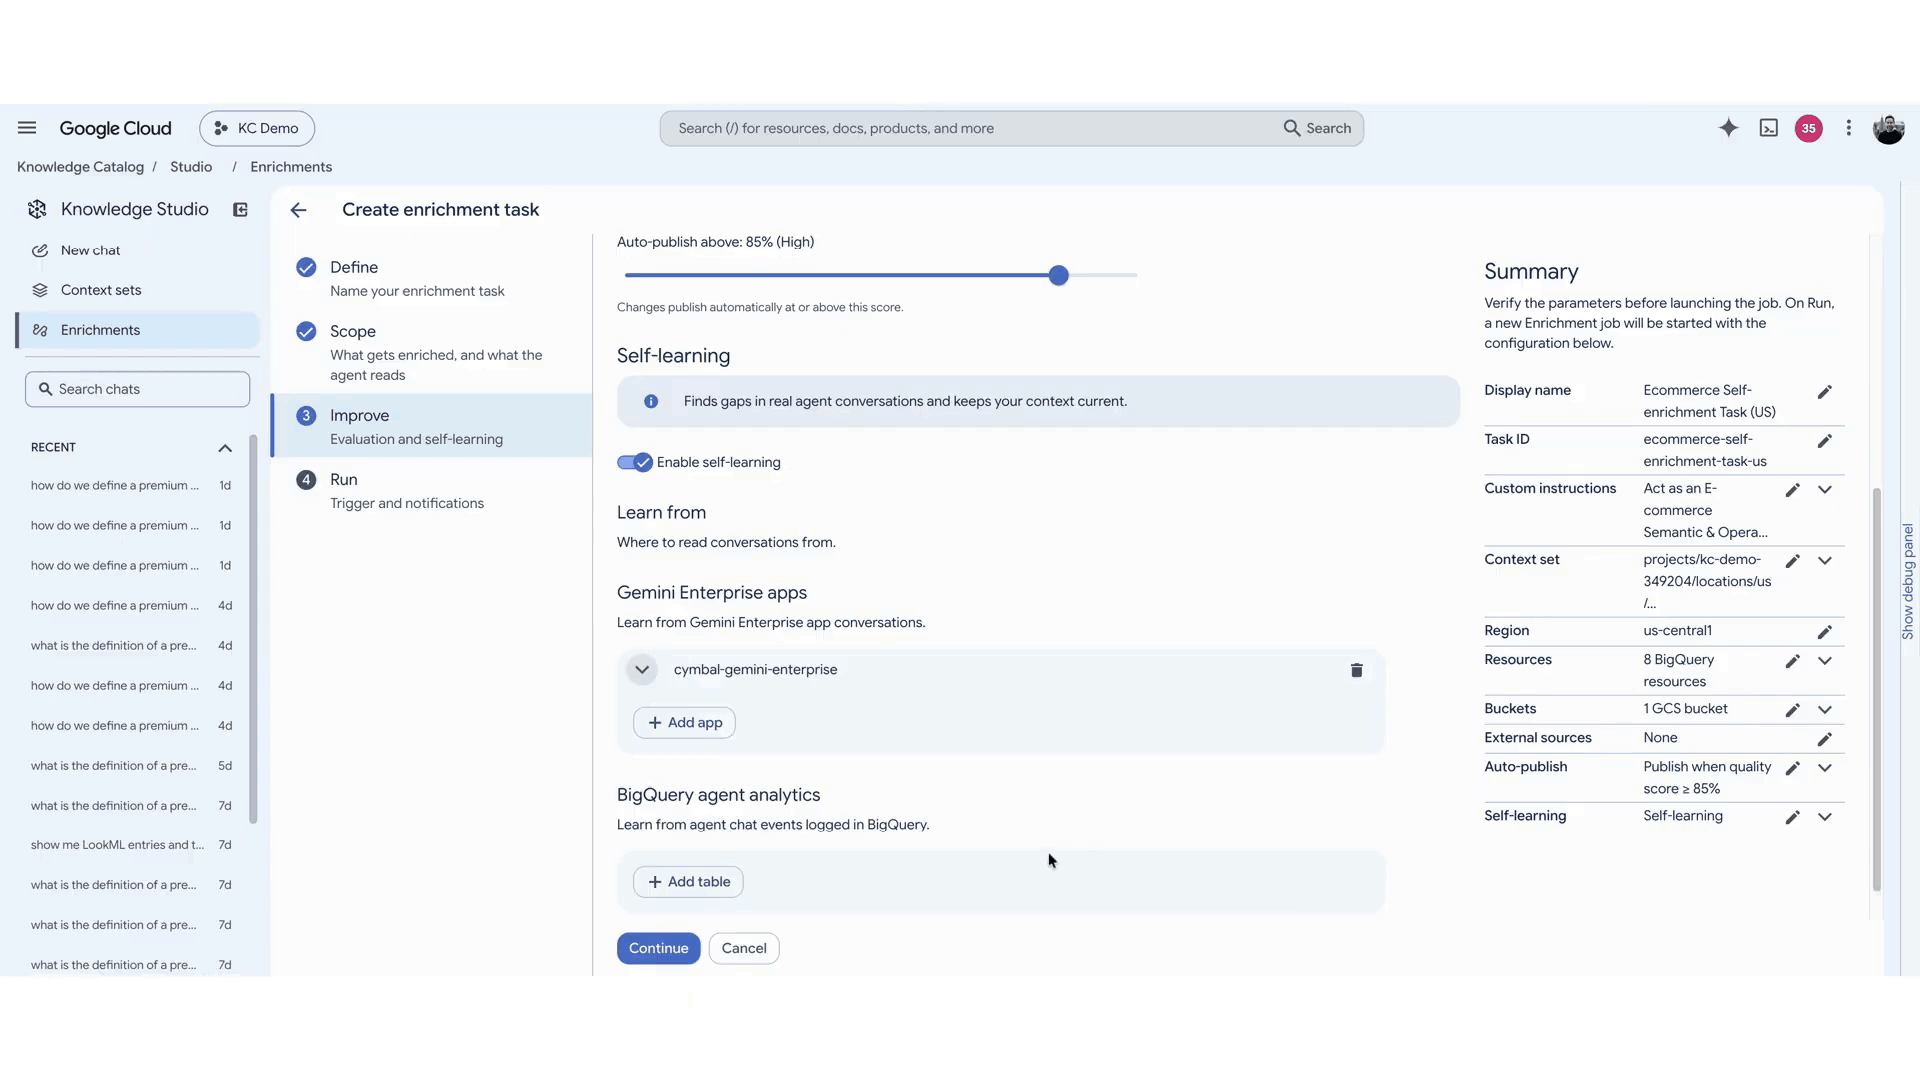
연결된 소스, 평가, 자체 학습을 통한 보강 작업 설정하기
자동화가 곧 제어권 포기를 의미하진 않습니다. 언제든지 자동 게시 기능을 켜거나 끌 수 있으며, 제안된 변경사항이 자동으로 승인되는 기준이 될 정확한 신뢰도 점수(예: 85%)를 직접 설정할 수 있습니다. 설정한 기준점 미만의 모든 항목과 삭제와 같은 민감한 업데이트는 데이터 관리자가 승인, 수정 또는 거부할 수 있도록 변경 요청으로 전환됩니다. 또한 직접 만든 평가 세트를 활용하여 제안된 업데이트를 엔드 투 엔드로 테스트할 수도 있습니다. 모든 변경사항은 전체 출처와 함께 기록되며, 이전 상태로 되돌릴 수 있습니다. 물론 Google은 모델 학습에 고객 데이터를 사용하지 않습니다.

게시 전 보강 제안, 신뢰도 점수, 변경사항 차이 검토하기
컨텍스트 세트로 각 대상에 적합한 컨텍스트를 설정하세요
엔터프라이즈 컨텍스트 그래프는 설계 특성상 그 범위가 매우 방대하지만, 에이전트와 사용자가 특정 작업을 수행할 때는 대개 그래프 전체가 아닌 신뢰할 수 있는 적절한 세그먼트만 있으면 됩니다. Knowledge Catalog는 컨텍스트 세트를 통해 이를 달성합니다. 컨텍스트 세트는 특정 도메인, 팀, 에이전트 또는 최종 사용자 그룹에 대한 정의, 측정항목, 조인 로직, 표준 쿼리를 포함하는 컨텍스트 그래프 중 선별되어 관리되는 하위 집합입니다. 예를 들어 영업 에이전트는 영업 컨텍스트 세트에 연결하고, 재무 분석가의 어시스턴트는 재무 컨텍스트 세트에 연결하여 사용할 수 있습니다. '순매출'은 그룹마다 충분히 다른 의미로 정의될 수 있으므로, 모든 도메인은 동일한 카탈로그 내에서 각자 고유한 정의를 유지합니다. 하지만 에이전트가 단일 세트에만 국한될 필요는 없습니다. Knowledge Catalog의 검색 기능을 활용하면 에이전트가 수행 중인 작업에 가장 적합한 컨텍스트 세트를 동적으로 찾아낼 수 있습니다.
컨텍스트 세트는 기본 제공되는 데이터 거버넌스와 세분화된 액세스 제어도 제공합니다. 각 컨텍스트 세트에 대한 액세스는 IAM으로 관리되므로, 관리자가 어떤 에이전트와 사용자가 이를 읽고 사용하거나 편집할 수 있는지 결정합니다. 에이전트는 사용 권한이 있는 세트에서만 컨텍스트를 검색하며, 기본 데이터에 대한 액세스는 기존 권한을 계속 따릅니다. 모든 업데이트는 추적 및 되돌리기가 가능합니다. 또한 컨텍스트 세트는 Open Knowledge Format(OKF)을 기반으로 하므로, OKF 번들을 가져와 컨텍스트 세트로 변환하거나 다시 OKF로 내보낼 수 있어 컨텍스트의 이식성이 유지됩니다.
Approved enrichments published to a governed context set
Knowledge Studio에서 탐색하고 제어하세요
이러한 모든 기능은 에이전트를 위한 컨텍스트를 선별하고 관리하는 컨텍스트 엔지니어와 데이터 관리자를 위해 새롭게 빌드된 Knowledge Catalog 환경에 통합되어 있습니다.
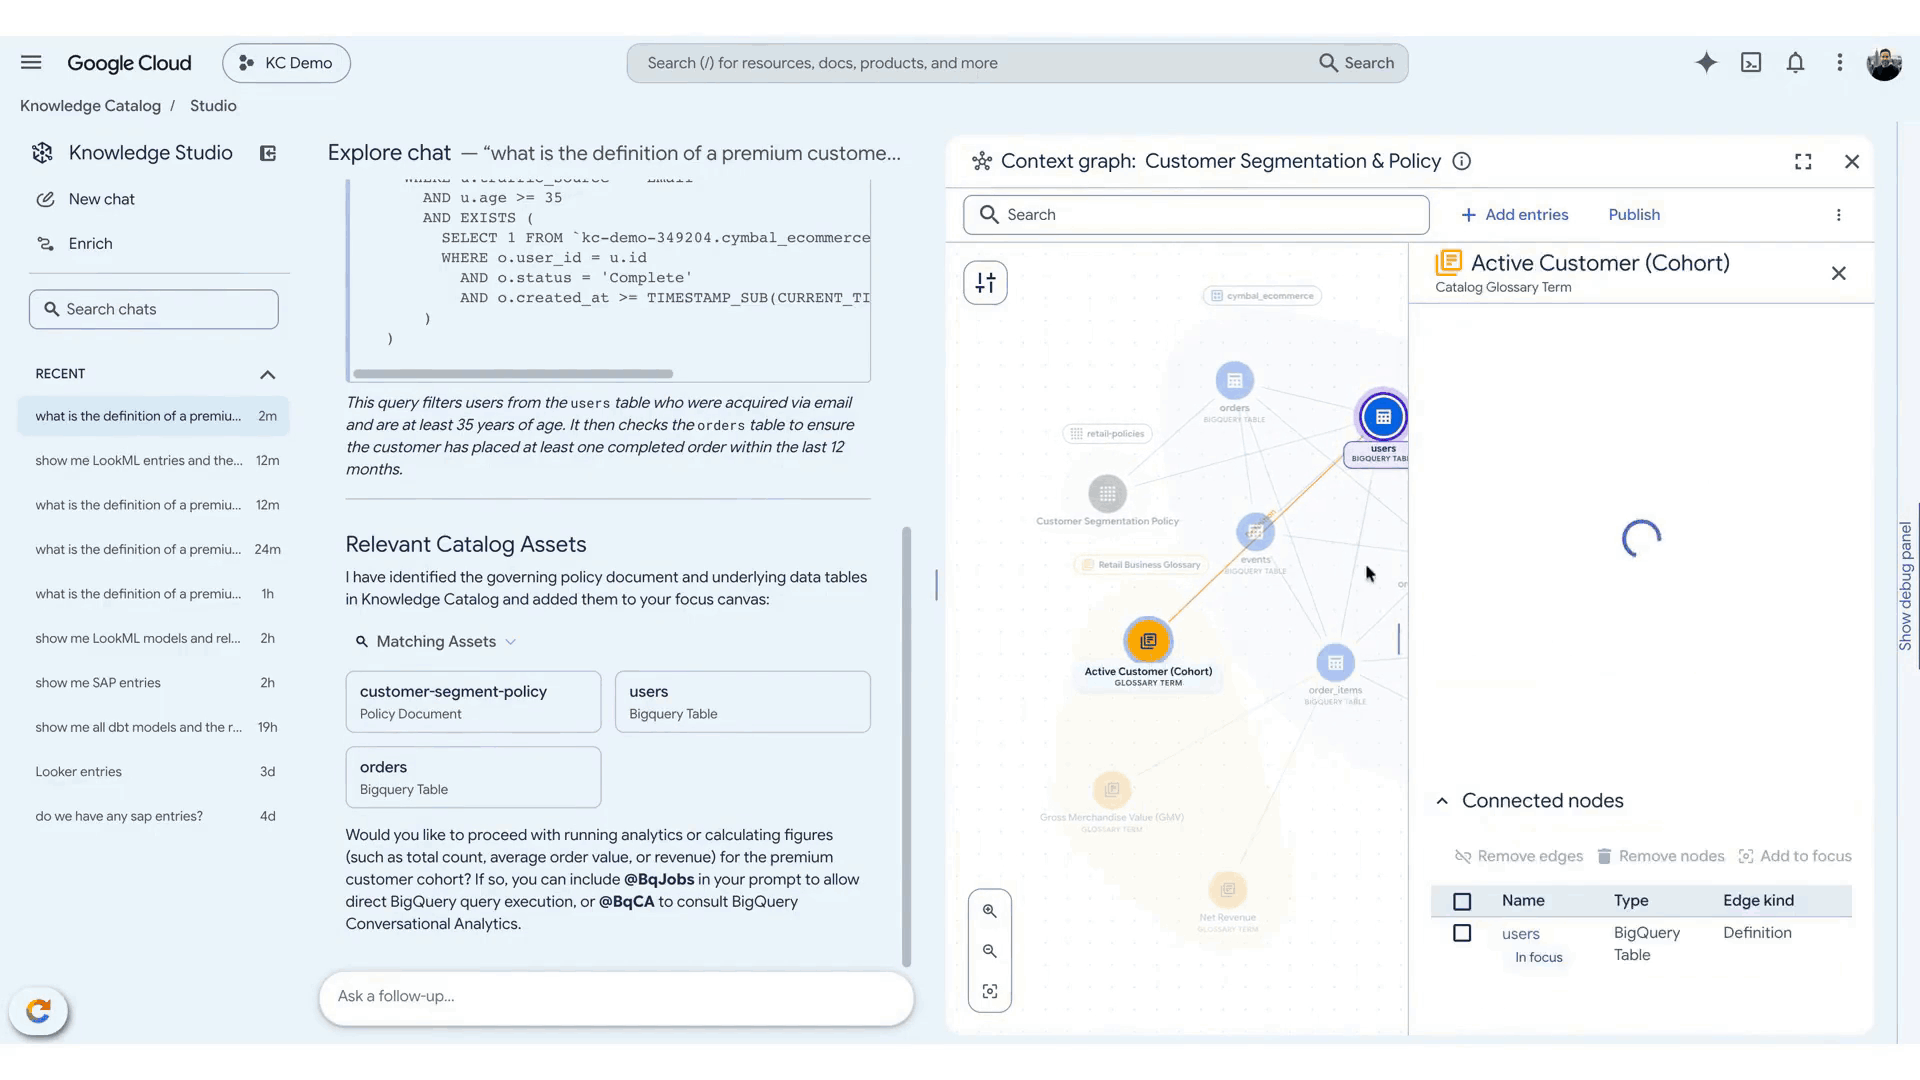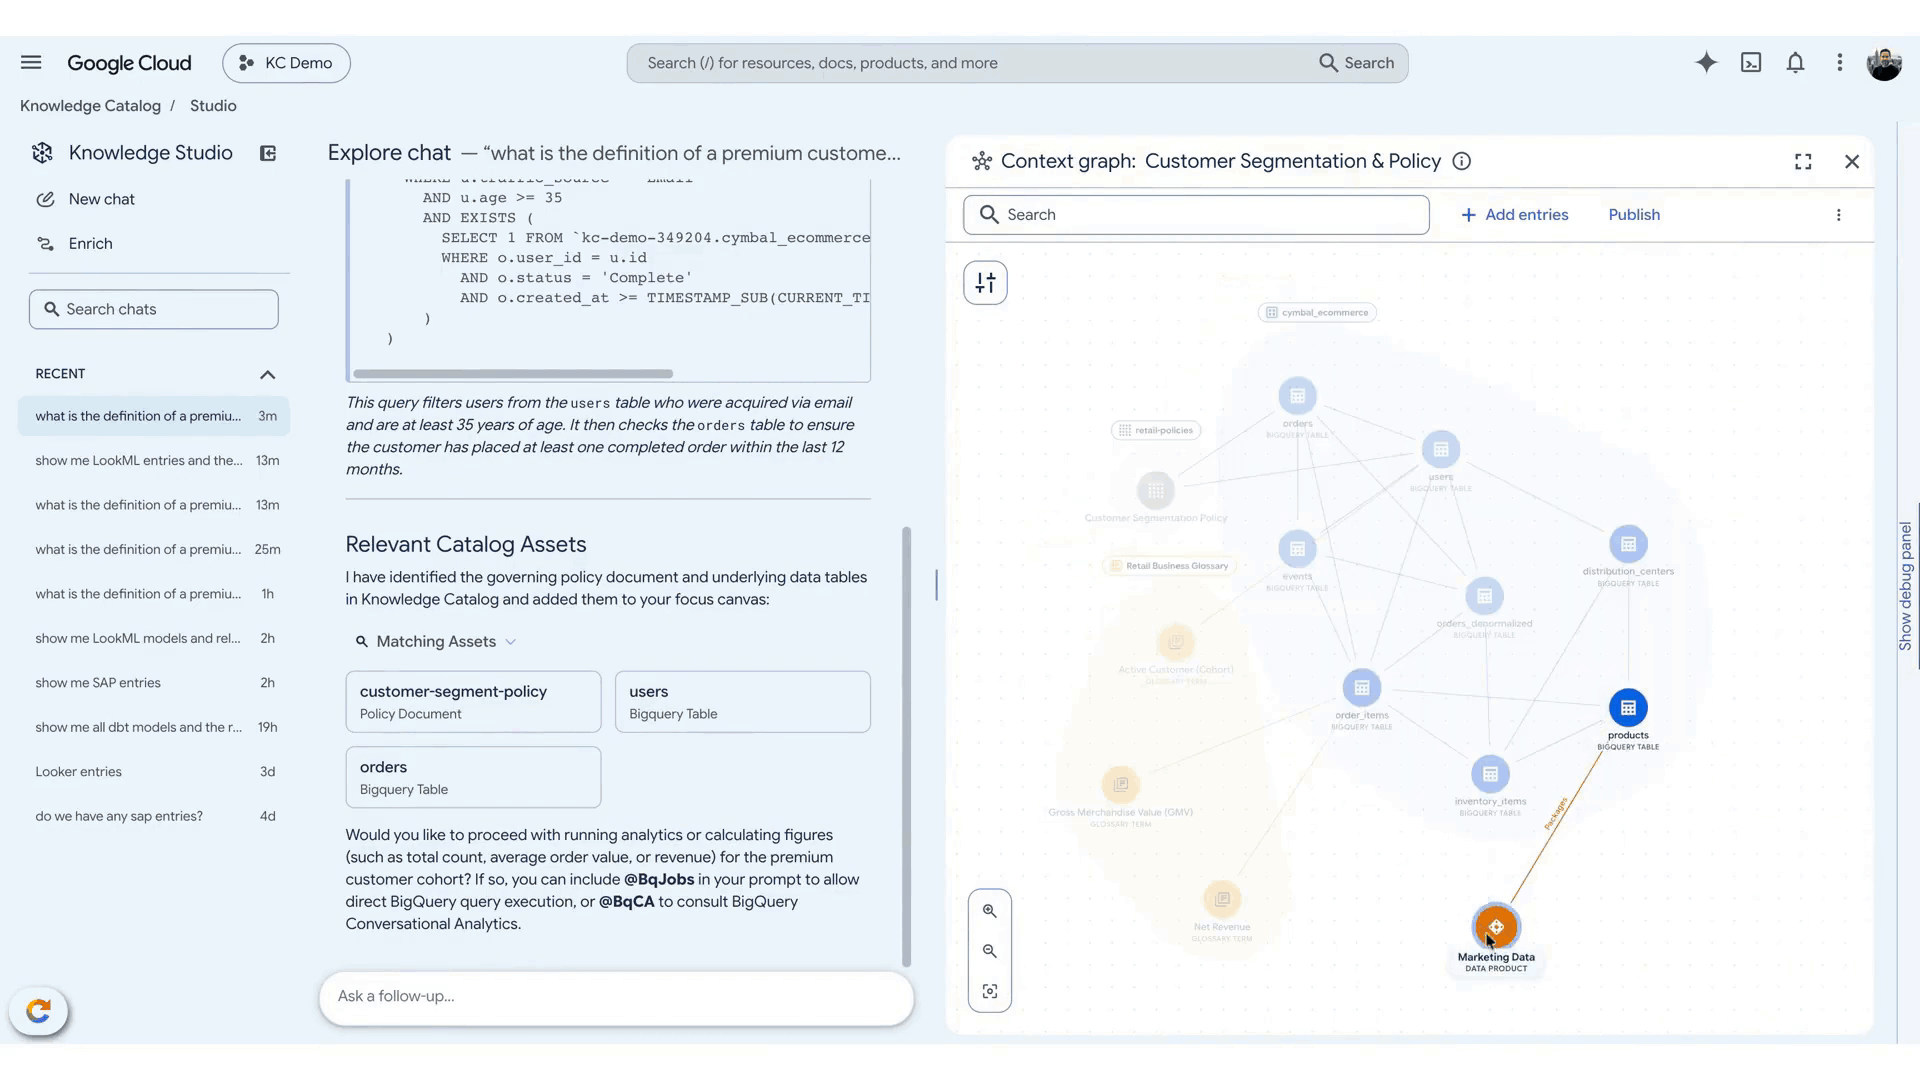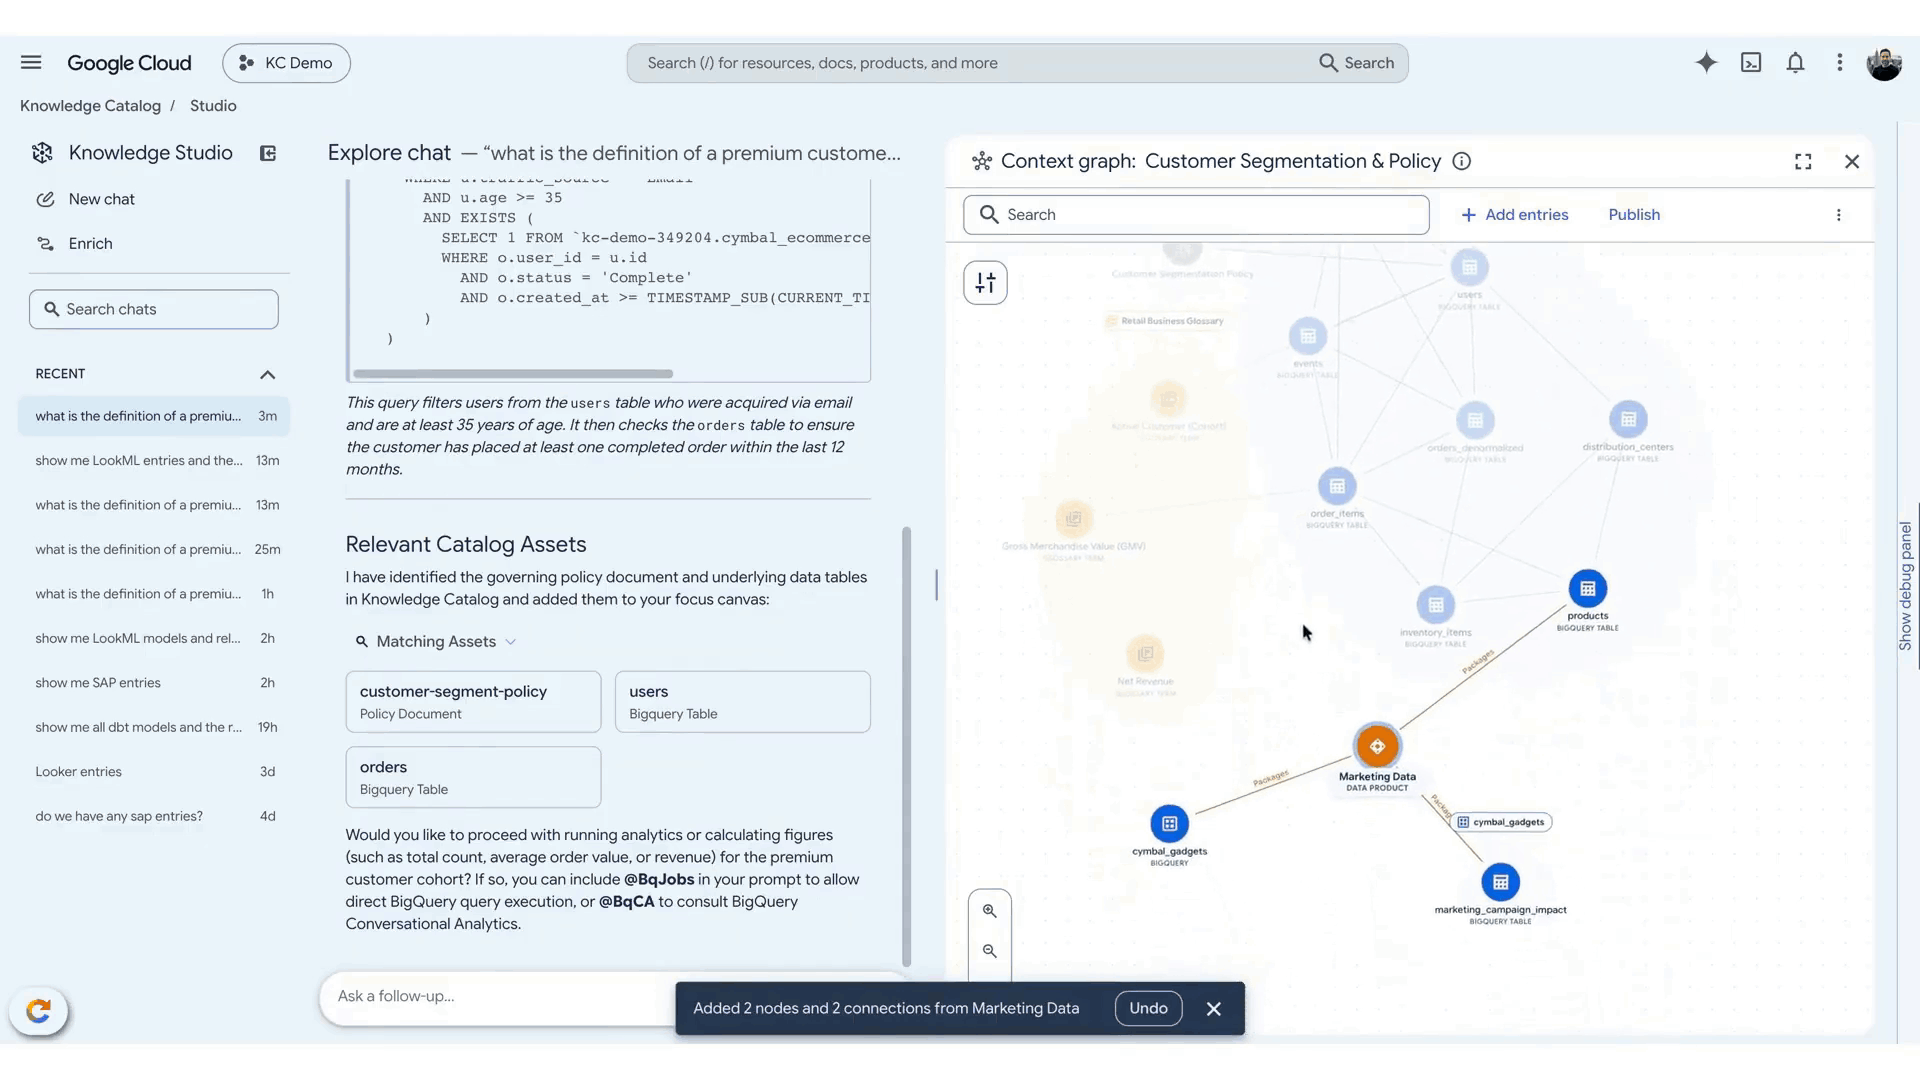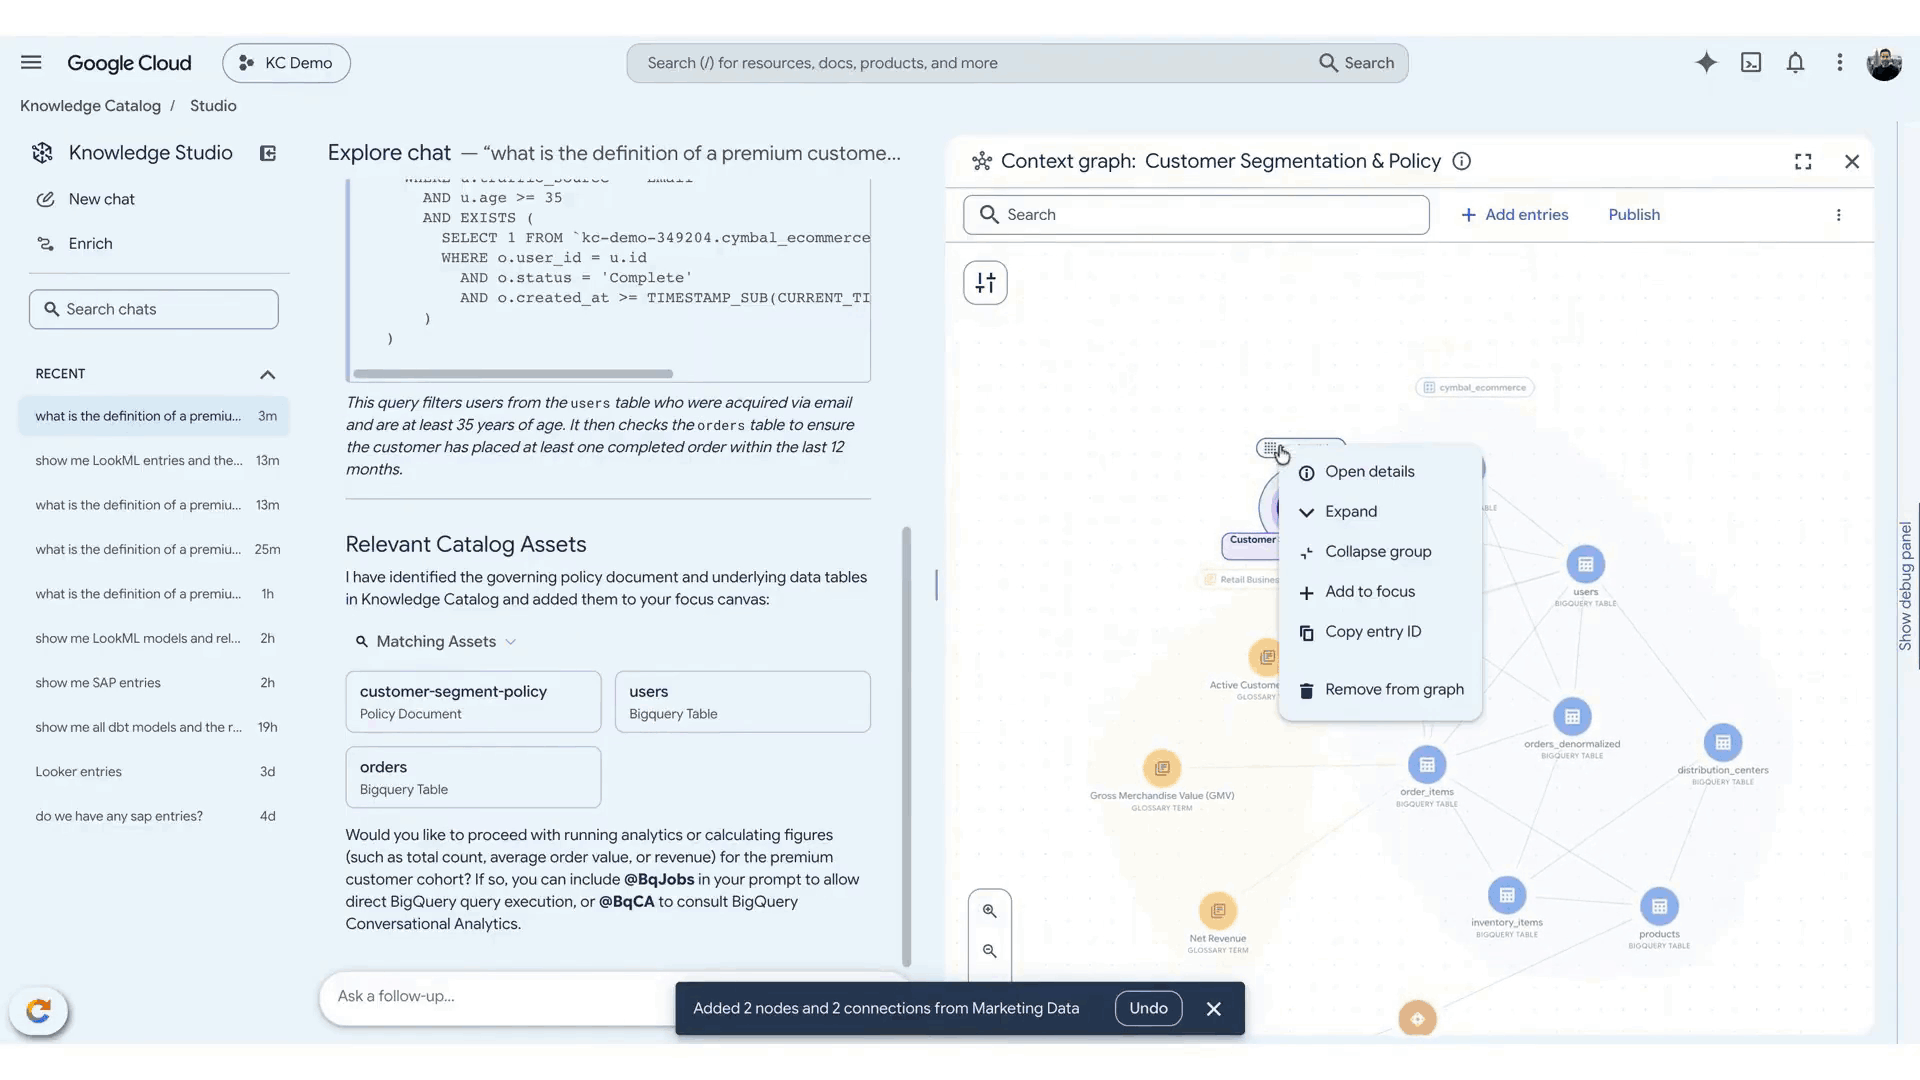
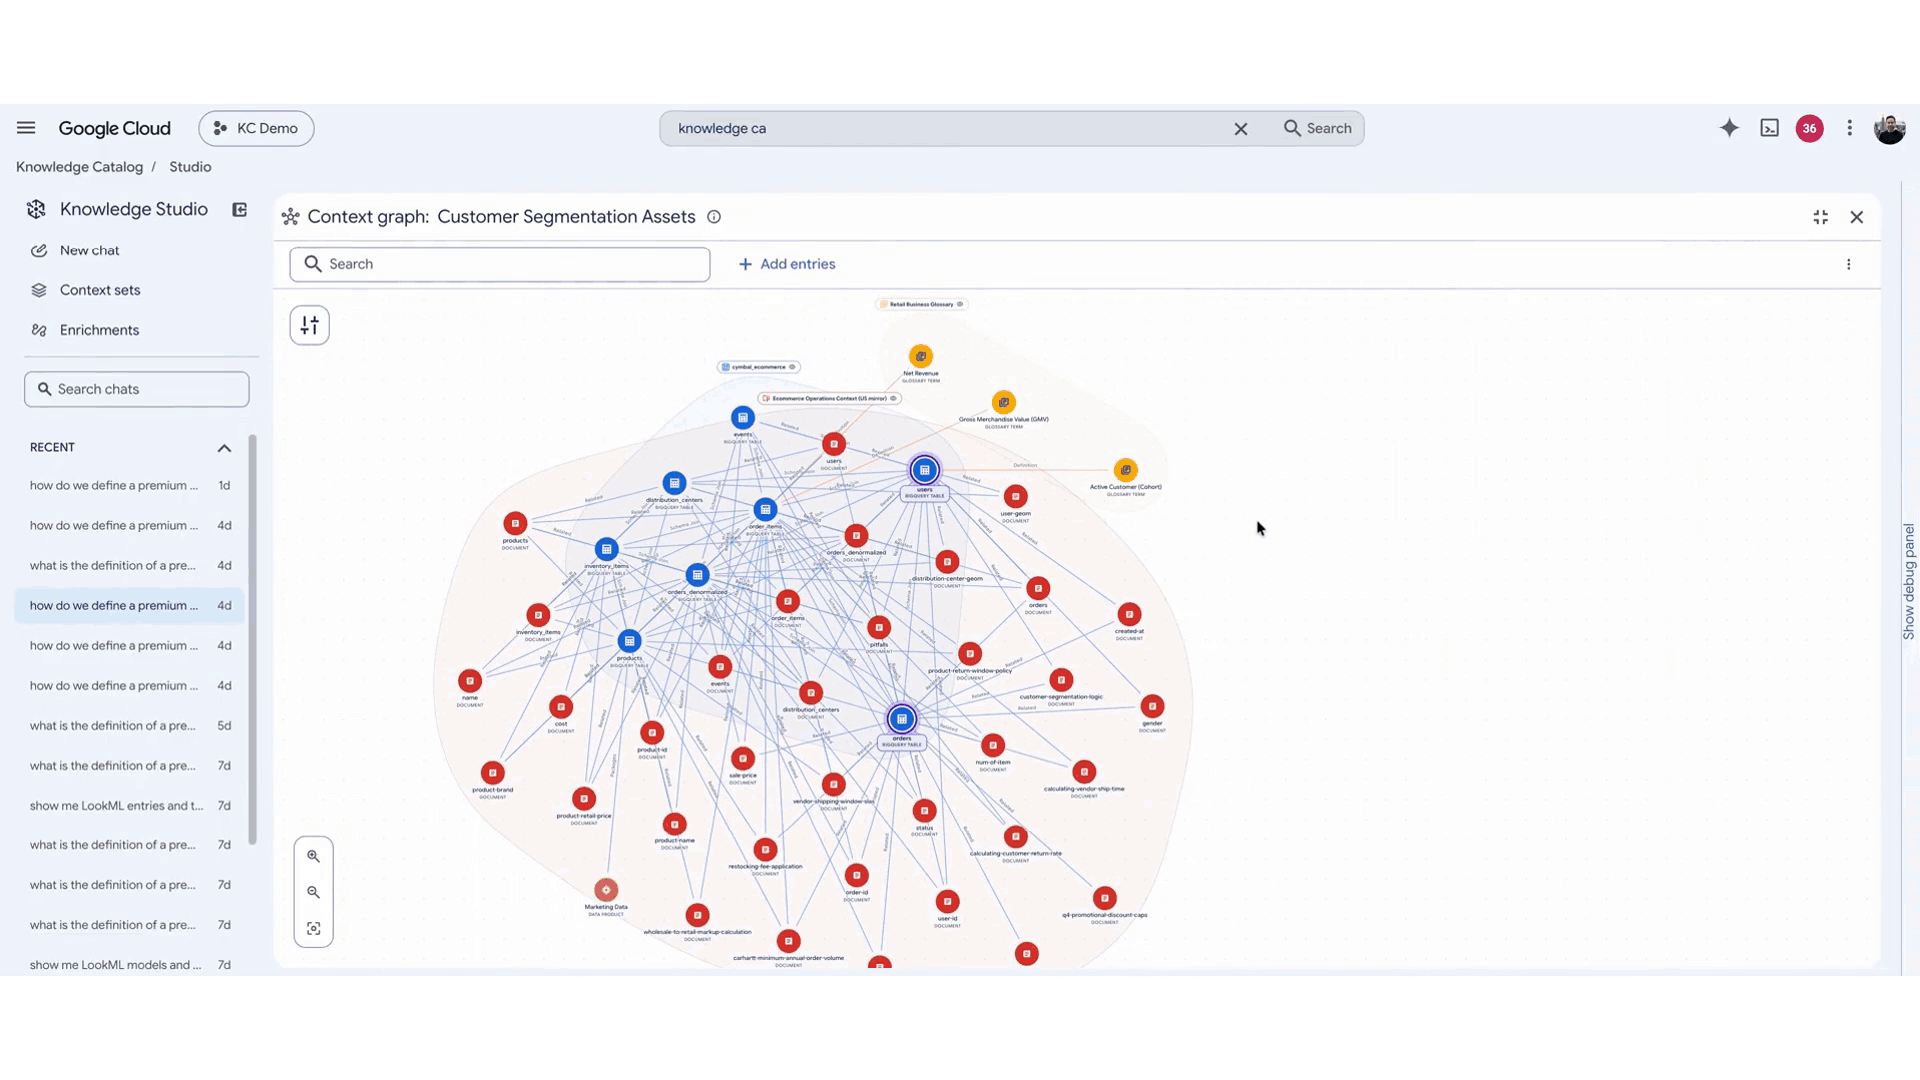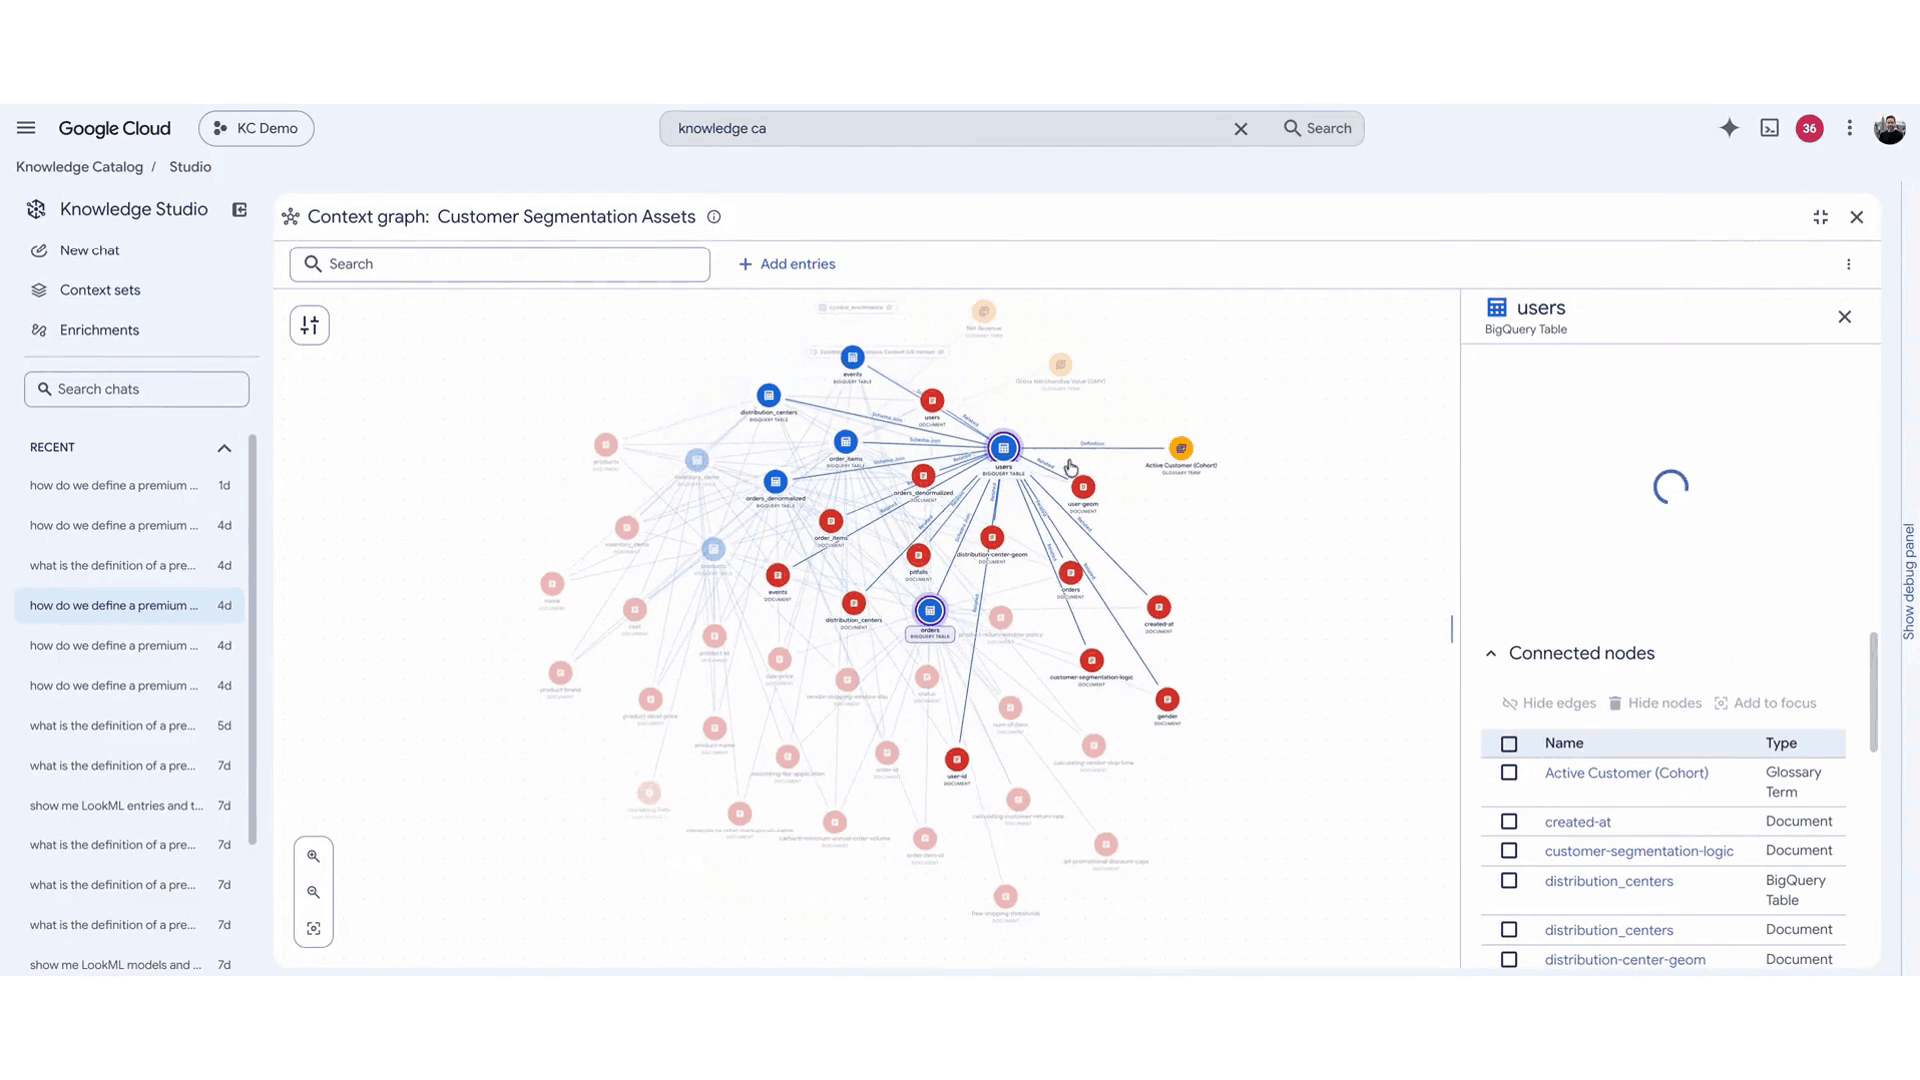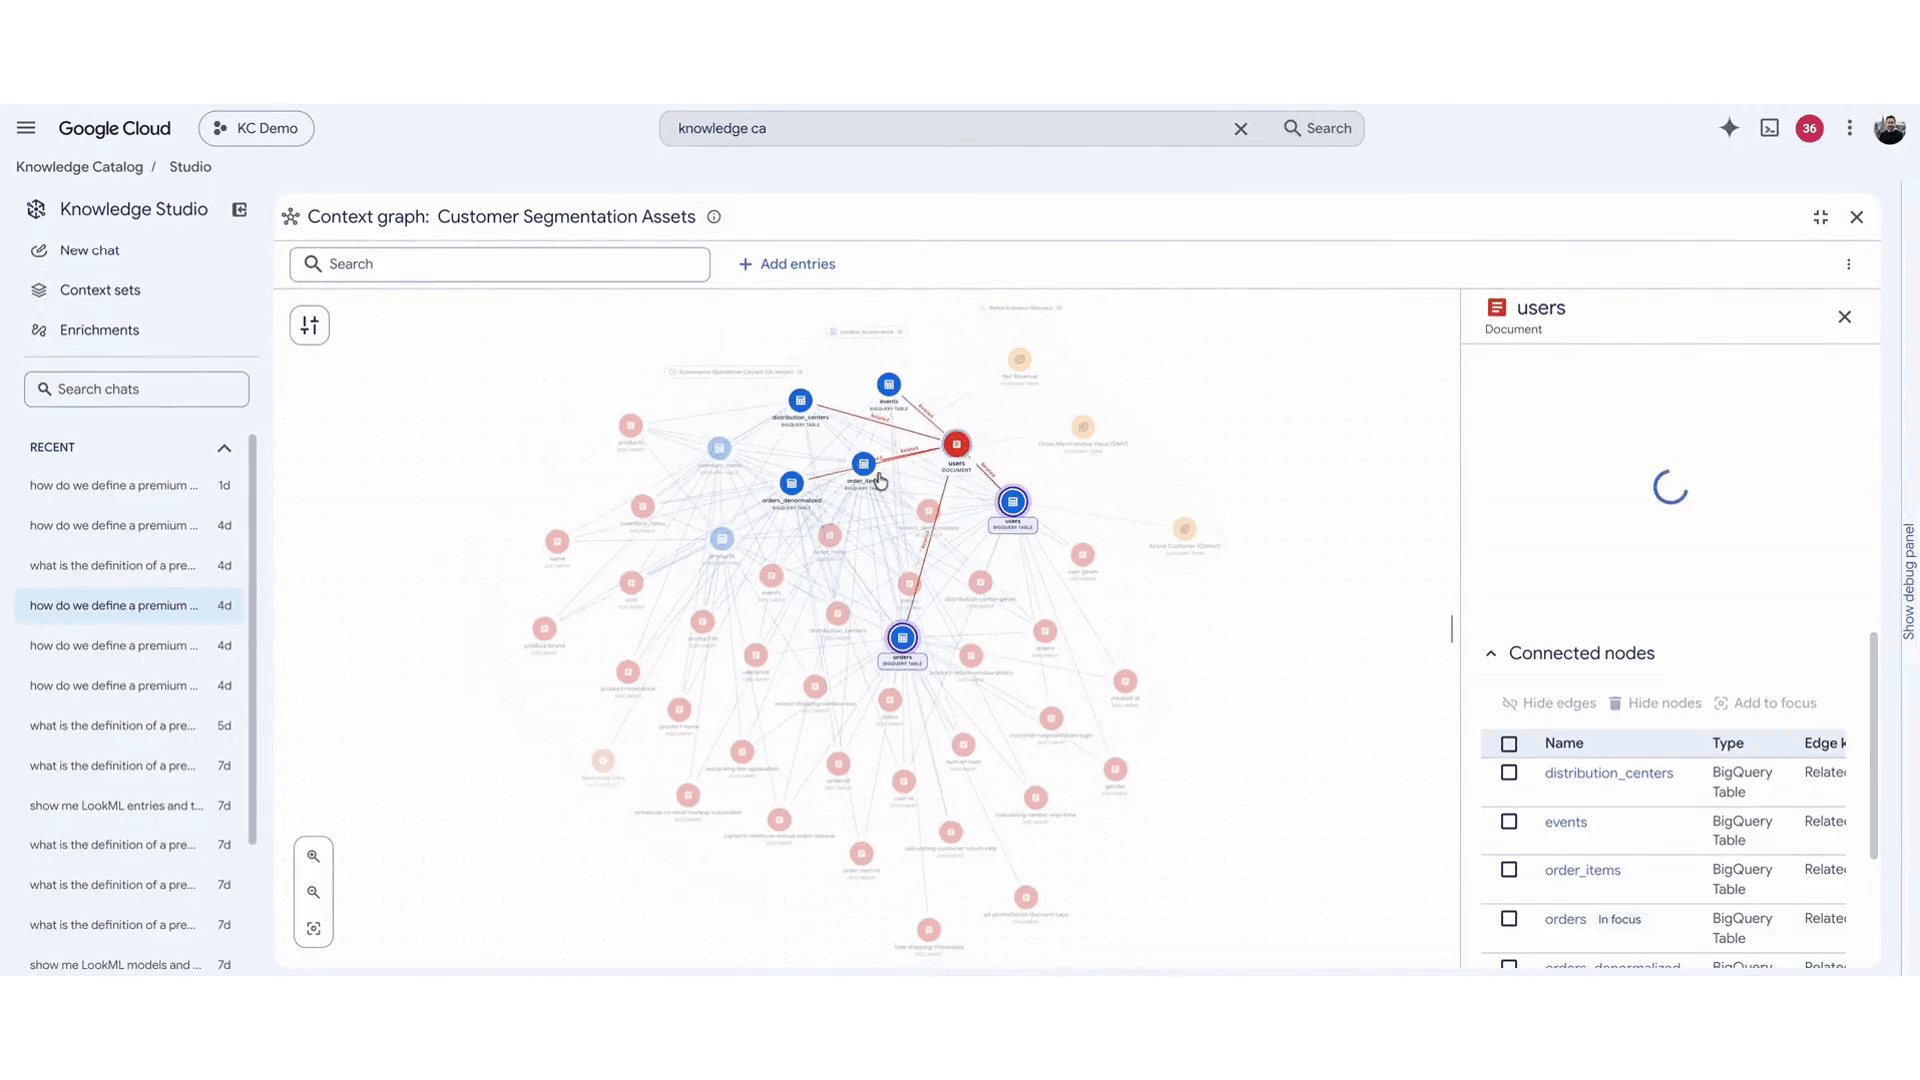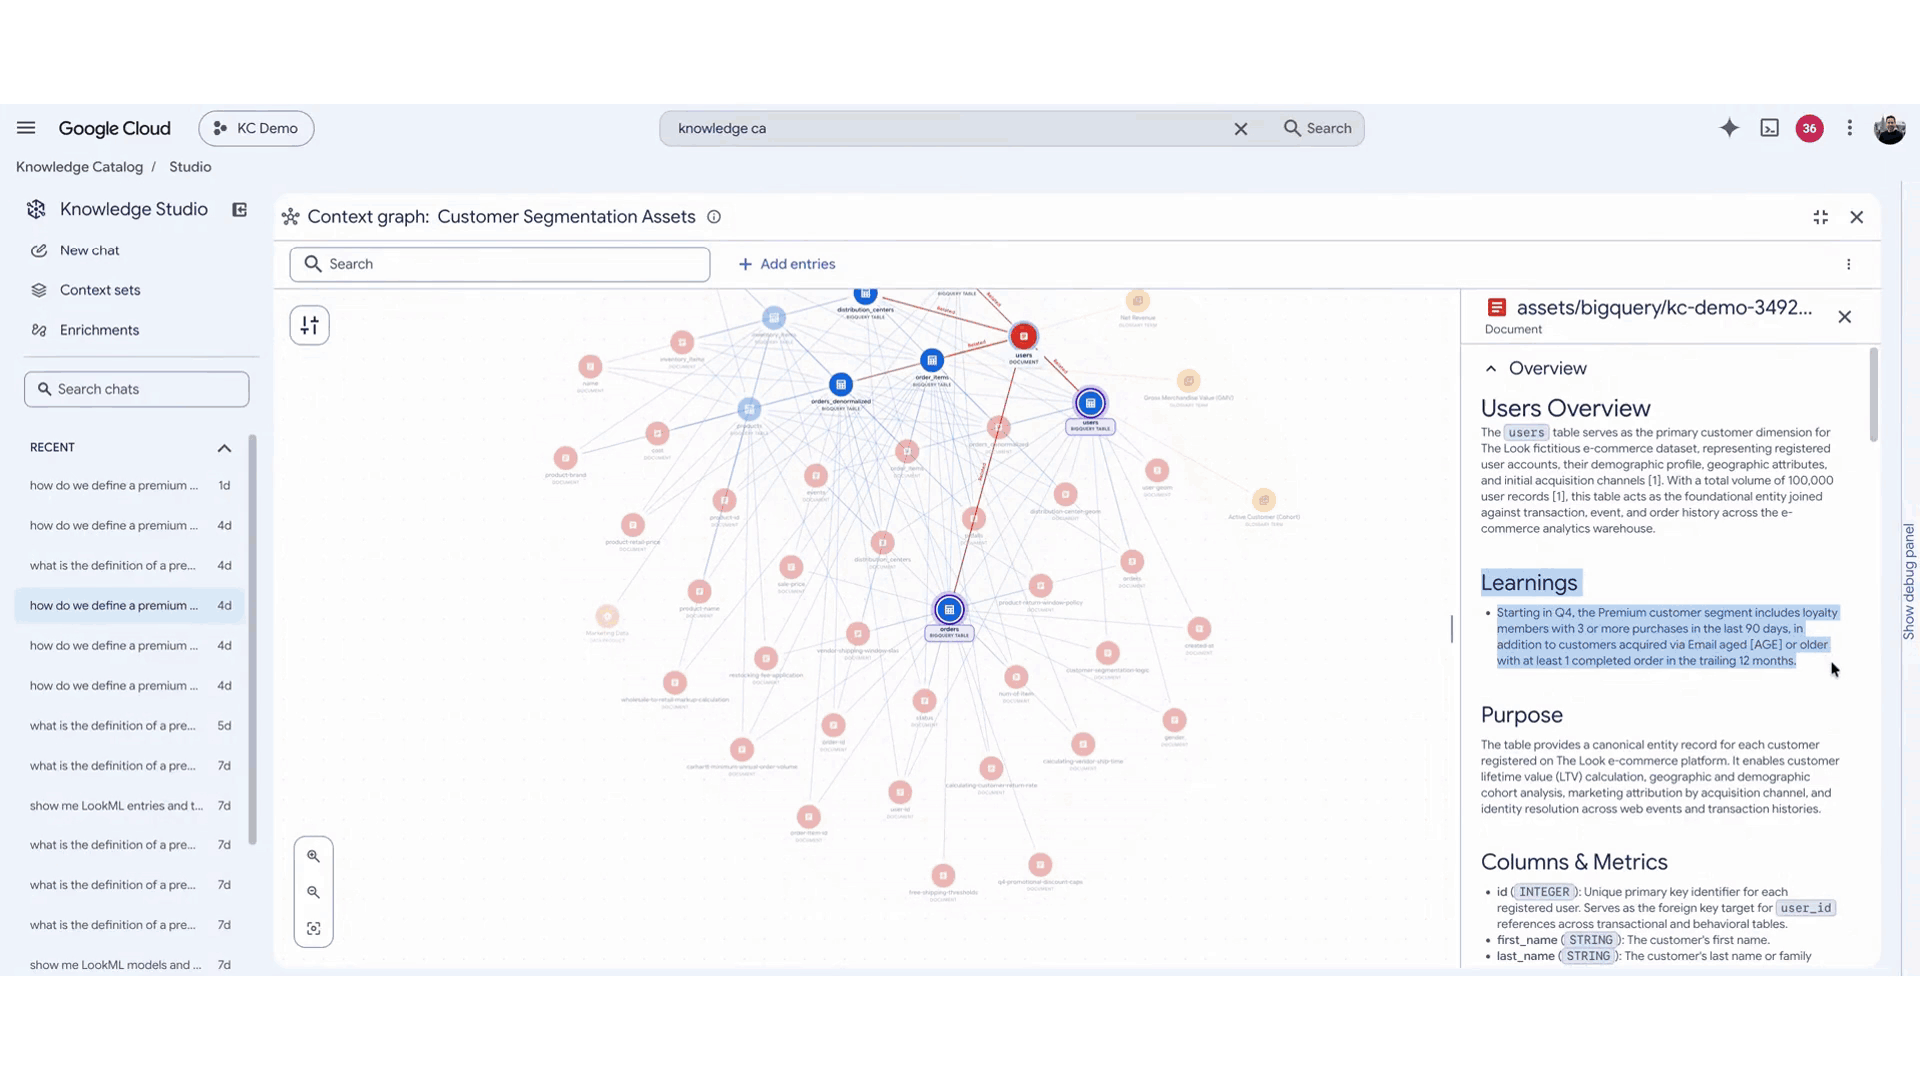
Knowledge Studio에서 컨텍스트 그래프를 시각적으로 탐색하기
새로운 Knowledge Studio는 Knowledge Catalog를 정적인 인벤토리 저장소에서 대화형 지휘 센터로 전환해 다음과 같은 기능을 제공합니다.
- 한눈에 확인하는 컨텍스트 범위: 운영 데이터베이스와 웨어하우스부터 시맨틱 모델, 컨텍스트 세트, 문서까지 크로스 클라우드 데이터 자산의 시각적 맵을 탐색할 수 있습니다.
- 대화하듯 탐색하는 컨텍스트: 자연어로 비즈니스 질문을 던지고, 엔터프라이즈 컨텍스트 그래프 전반에 걸쳐 관계를 넘나들며, 에이전트가 메타데이터를 분석하고 추론하는 방식을 확인합니다.
- 한곳에서 검토하고 검증하는 보강: 제안된 각 변경사항과 소스 인용, 신뢰도 점수를 꼼꼼하게 확인합니다. 실제 질문을 바탕으로 컨텍스트 세트를 테스트하고, 소프트웨어 방식의 버전 제어 기능으로 변경 요청을 승인, 수정 또는 롤백할 수 있습니다.
- 보강 실행 모니터링: 각 보강 작업의 일정, 결과, 토큰 사용량, 실행 시간을 추적하고 실행이 완료되면 이메일로 알림을 받습니다.
시작하기