개방형 표준으로 간편해지는 크로스 클라우드 대화형 분석
Praveen Kumar
Customer Engineer, Data & AI
*이 콘텐츠는 AI 번역 도구를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역에는 오류나 누락이 포함될 수 있습니다. 정확한 정보는 영문 원본을 참고해 주시기 바랍니다.
대부분의 조직에서 데이터는 어디에나 존재합니다. 엔지니어링팀이 규모를 키우고 워크로드에 특화된 플랫폼을 도입함에 따라 엔터프라이즈 데이터는 자연스럽게 여러 클라우드와 운영 시스템으로 분산됩니다. 분석 및 AI 이니셔티브에 조직 전체의 컨텍스트가 필요한 경우, 관련 팀은 일반적으로 복잡한 추출 파이프라인을 빌드하여 데이터를 중앙 저장소에 복사하거나 데이터가 파편화된 상태로 보고되는 상황을 감수해야 하는 어려운 선택의 기로에 직면합니다.
기존 아키텍처는 원격 데이터 세트를 중앙 스테이징 웨어하우스에 복사하는 예약된 추출 파이프라인을 통해 이러한 데이터 파편화 문제를 해결합니다. 이러한 방식은 동기화 지연을 유발하고, 지속적인 스토리지 비용을 발생시키며, 가변적인 네트워크 이그레스 수수료를 초래합니다. 업스트림에서 스키마가 변경되면 파이프라인이 중단되고, 팀은 동기화되지 않은 대시보드에서 측정항목을 조정하는 데 몇 시간을 허비하게 됩니다.
BigQuery와 Google Cloud의 경계 없는 Lakehouse는 개방형 Apache Iceberg REST 카탈로그 사양을 기반으로 이러한 문제를 해결할 수 있는 간소화된 방법을 제공합니다. 데이터를 컴퓨팅 엔진으로 이동하는 대신 Google Cloud 컴퓨팅과 생성형 AI를 데이터에 직접 적용하여 Databricks, Snowflake, AWS Glue에서 데이터를 인플레이스로 쿼리할 수 있습니다.
이 게시물에서는 BigQuery 페더레이션을 위해 Databricks Unity Catalog를 구성하는 방법(AWS Glue 및 Snowflake 설정 부록 참조), 세 개의 외부 카탈로그 모두에서 데이터를 조인하는 단일 쿼리를 실행하는 방법, BigQuery의 대화형 분석을 사용하여 자연어로 통합 데이터를 탐색하는 방법을 단계별로 살펴봅니다.
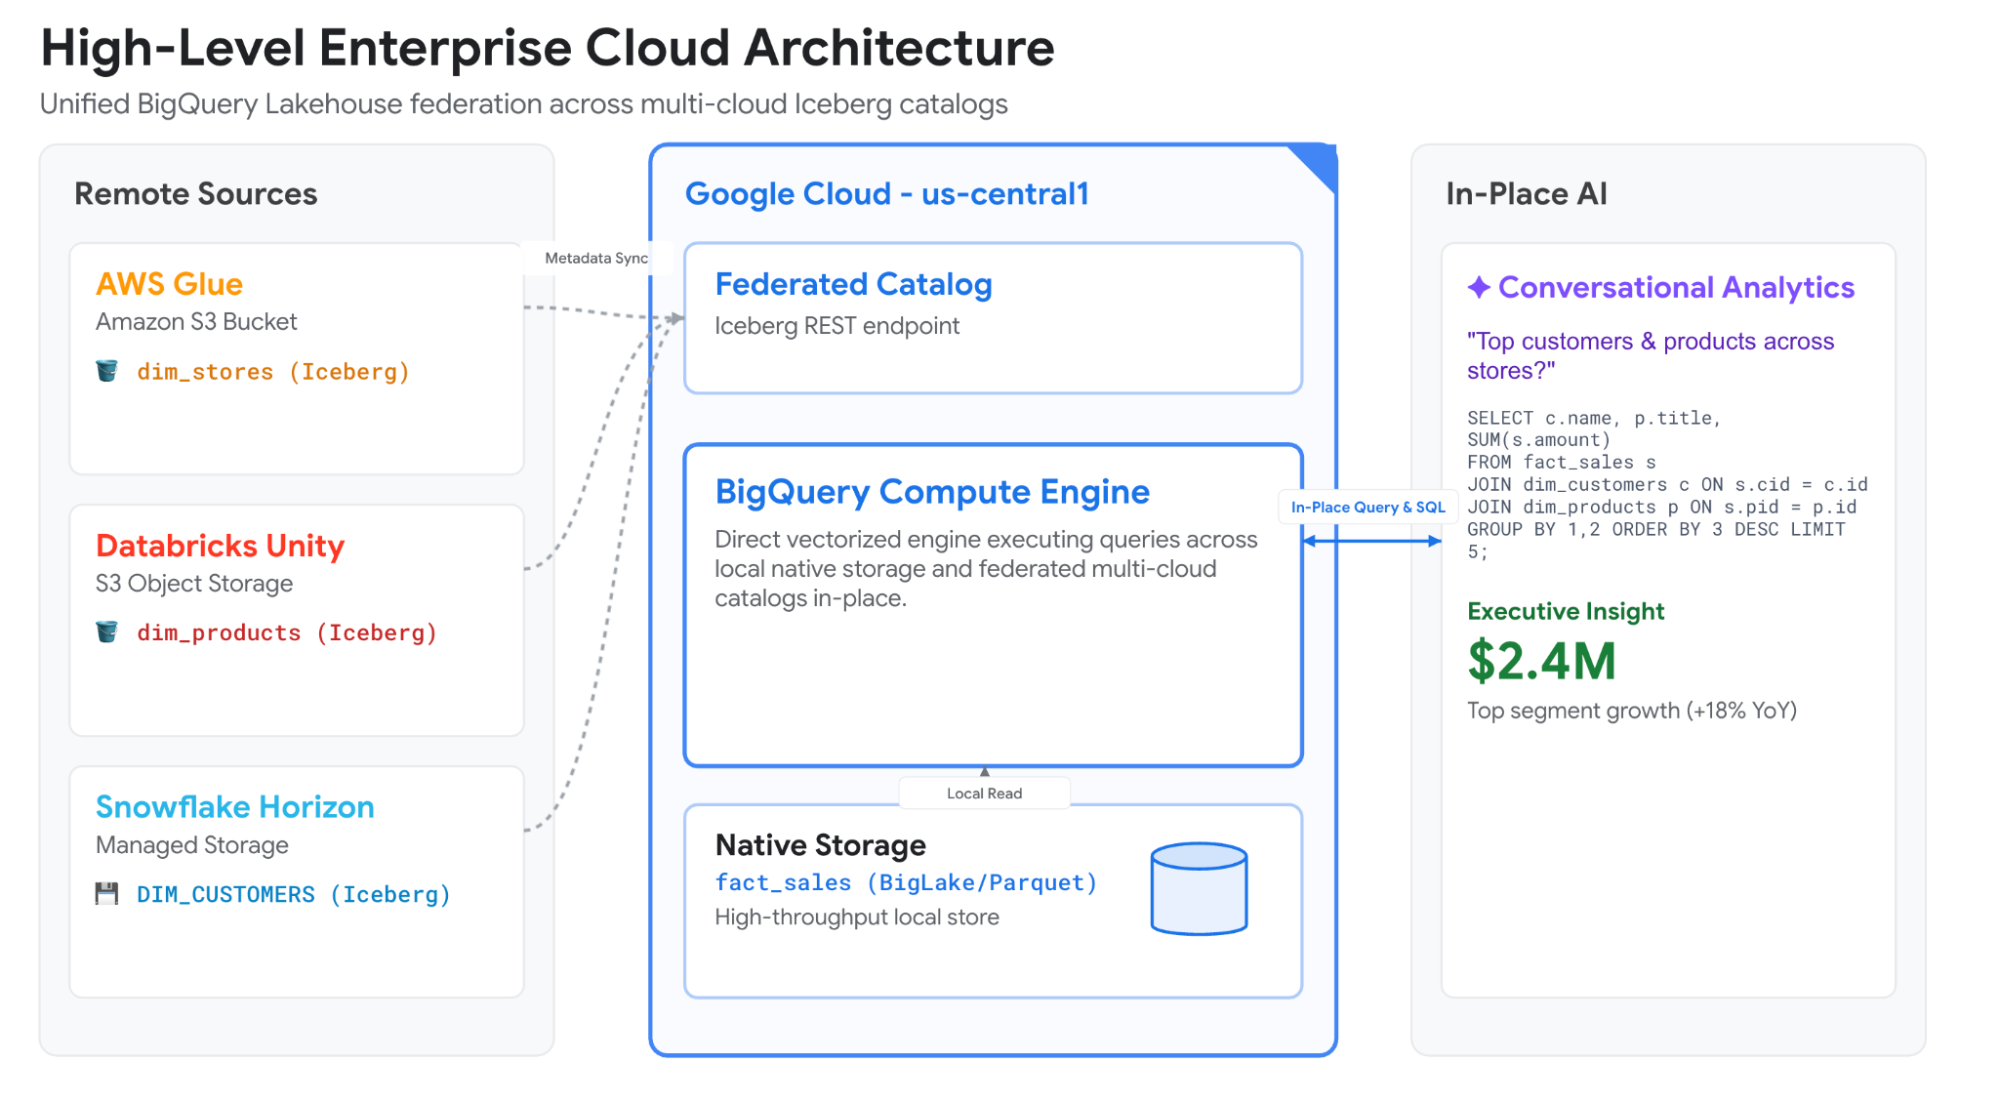
그림 1: BigQuery는 Lakehouse를 통해 외부 Apache Iceberg REST 카탈로그 전반의 메타데이터를 통합하여, 데이터 마이그레이션 없이도 즉시 대화형 분석을 수행할 수 있게 해줍니다.
경계 없는 레이크하우스 아키텍처
이 솔루션은 Lakehouse 런타임 카탈로그를 사용하여 다른 클라우드 제공업체의 메타데이터를 동기화하므로 데이터를 마이그레이션하지 않고도 Apache Iceberg REST 카탈로그 엔드포인트를 통해 BigQuery 또는 외부 오픈소스 엔진으로 데이터를 쿼리할 수 있습니다. Databricks Unity Catalog, Snowflake Horizon Catalog, AWS Glue Data Catalog는 개방형 Apache Iceberg REST 카탈로그 사양을 지원하므로 세 플랫폼 모두에 일관된 연결 패턴을 적용할 수 있습니다.
페더레이션 쿼리를 실행하면 Lakehouse 런타임 카탈로그가 메타데이터 동기화를 스토리지 액세스와 분리합니다.
-
메타데이터 동기화: Lakehouse 런타임 카탈로그는 정의된 새로고침 일정에 따라 원격 카탈로그에서 스키마, 스냅샷 포인터, 테이블 정의를 주기적으로 동기화합니다.
-
직접 스토리지 액세스: 쿼리 런타임 중에 호환되는 엔진은 원격 플랫폼에서 발급한 임시 사용자 인증 정보를 사용하여 Amazon S3와 같은 원격 객체 스토리지에서 직접 Parquet 데이터 파일을 읽습니다.
모든 쿼리 처리는 BigQuery 또는 Apache Spark용 관리형 서비스와 같은 Google Cloud 컴퓨팅 내에서 실행됩니다. 실행 중에는 원격 Databricks 클러스터, Snowflake 가상 웨어하우스, AWS 컴퓨팅 인스턴스가 호출되지 않습니다.
인증은 명확한 3단계 배포 패턴을 따릅니다. 먼저 Google Cloud에서 페더레이션 카탈로그를 생성하고, 설정을 확인하여 자동으로 생성된 서비스 계정을 가져온 다음, 원격 플랫폼에서 액세스 권한을 부여합니다.
AI를 사용하여 샘플 데이터를 생성할 수 있습니다. 테이블의 스키마 세부정보는 아래와 같습니다.
Databricks Unity Catalog 구성
먼저 Databricks에서 카탈로그와 테이블을 준비합니다. Unity Catalog에서 페더레이션 액세스를 사용하려면 대상 스키마가 Databricks에 등록된 외부 위치와 연결되어 있어야 합니다.
-
AI를 사용하여 샘플 데이터를 생성할 수 있습니다. 각 섹션에서 테이블의 스키마 세부정보를 확인할 수 있습니다.
외부 엔진이 이 테이블을 읽으려면 먼저 Databricks metastore 관리자가 metastore 세부정보 탭에서 외부 데이터 액세스를 사용 설정해야 합니다.
Databricks 관리자 계정으로 이동하여 사용자 관리 메뉴에서 Databricks 서비스 보안 주체를 만들고, 해당 UUID '6ea7b861-c5a5-xxxx-xxxx-xxxxxxxxxxxx'를 별도로 기록해 둡니다.
BigQuery에 Databricks 연결
다음으로 gcloud 명령줄 도구를 사용하여 Google Cloud 내에 페더레이션 카탈로그를 만듭니다. Databricks 작업공간 URL과 Databricks 서비스 보안 주체의 애플리케이션 ID가 필요합니다.
카탈로그가 생성되면 카탈로그 정보를 조회하여 할당된 서비스 계정을 확인합니다.
Databricks로 돌아가 서비스 보안 주체에 권한을 할당합니다.
외부 데이터 액세스를 위한 사용자 인증 정보 벤더 제공을 사용 설정하려면 대상 스키마 또는 카탈로그에서 Databricks 서비스 보안 주체에 EXTERNAL USE SCHEMA 권한을 부여해야 합니다.
마지막으로 연결을 완료하려면 다음 세부정보를 사용하여 Databricks 서비스 보안 주체에 페더레이션 정책을 설정합니다.
-
발급기관 URL* - https://accounts.google.com
-
소유자* - 카탈로그 describe 명령어에서 반환된 숫자 소유자 ID(예: 1124251400450xxxxxxxx)
-
대상 - https://accounts.cloud.databricks.com
3개의 클라우드에서 단일 쿼리 실행
페더레이션된 Iceberg 테이블은 project.catalog.namespace.table과 같이 4단계로 구성된 경로를 통해 BigQuery에서 호출할 수 있습니다.
이 환경에서 판매 트랜잭션은 BigQuery에 기본적으로 저장되어 있습니다.
이제 단일 SQL 쿼리를 실행하여 기본 판매 트랜잭션을 Snowflake의 고객 레코드, Databricks의 제품 라인, AWS Glue의 매장 위치와 조인할 수 있습니다.
BigQuery는 조인을 즉시 처리합니다. Snowflake 식별자는 대문자(CORE.DIM_CUSTOMERS)로 표시되는 반면 Databricks와 AWS Glue는 소문자 테이블 경로를 유지합니다.
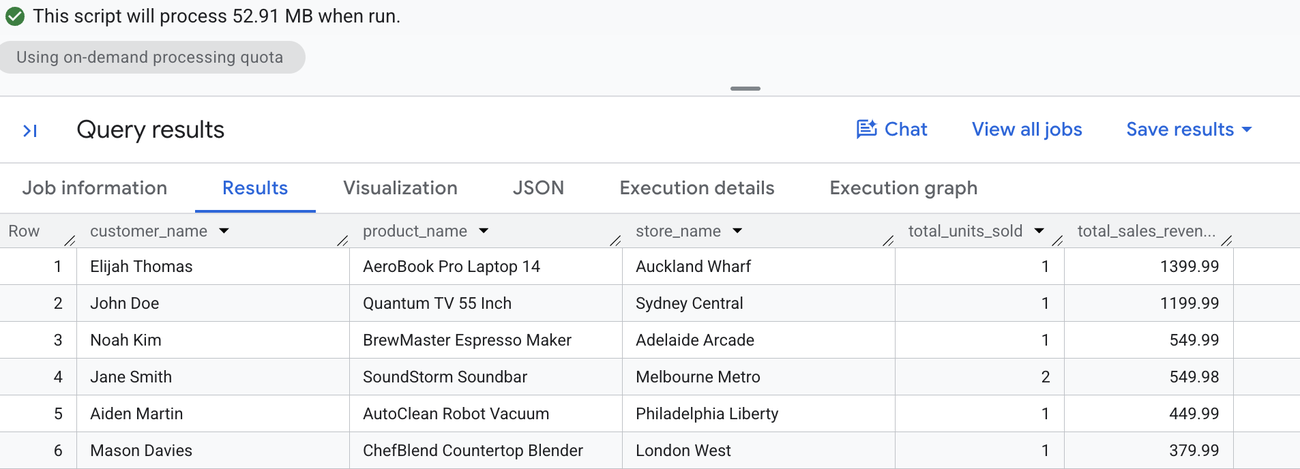
그림 2 - Snowflake, Databricks, AWS Glue의 데이터를 통합한 쿼리 결과
자연어로 크로스 클라우드 데이터 탐색
페더레이션된 Iceberg 테이블은 BigQuery 내에서 네이티브 테이블처럼 작동하므로 다운스트림 분석 기능이 액세스 권한을 직접 상속합니다. BigQuery의 대화형 분석을 이러한 통합 스키마에 연결하면 팀원들이 자연어 프롬프트를 사용하여 크로스 클라우드 데이터를 탐색할 수 있습니다.
대화형 분석에 필요한 모든 운영 컨텍스트를 제공하기 위해, 페더레이션 조인을 논리적 뷰로 저장합니다.
자연어로 매출 실적 분석
BigQuery의 대화형 분석에 질문할 때:
"총 판매 수익을 기준으로 상위 고객은 누구이며, 어떤 제품을 구매했고, 어떤 매장에서 쇼핑했어?"
대화형 분석은 세 가지 원격 카탈로그 모두에서 스키마를 평가하고, SQL 문을 생성하고, 쿼리를 실행하고, 응답을 표시합니다.
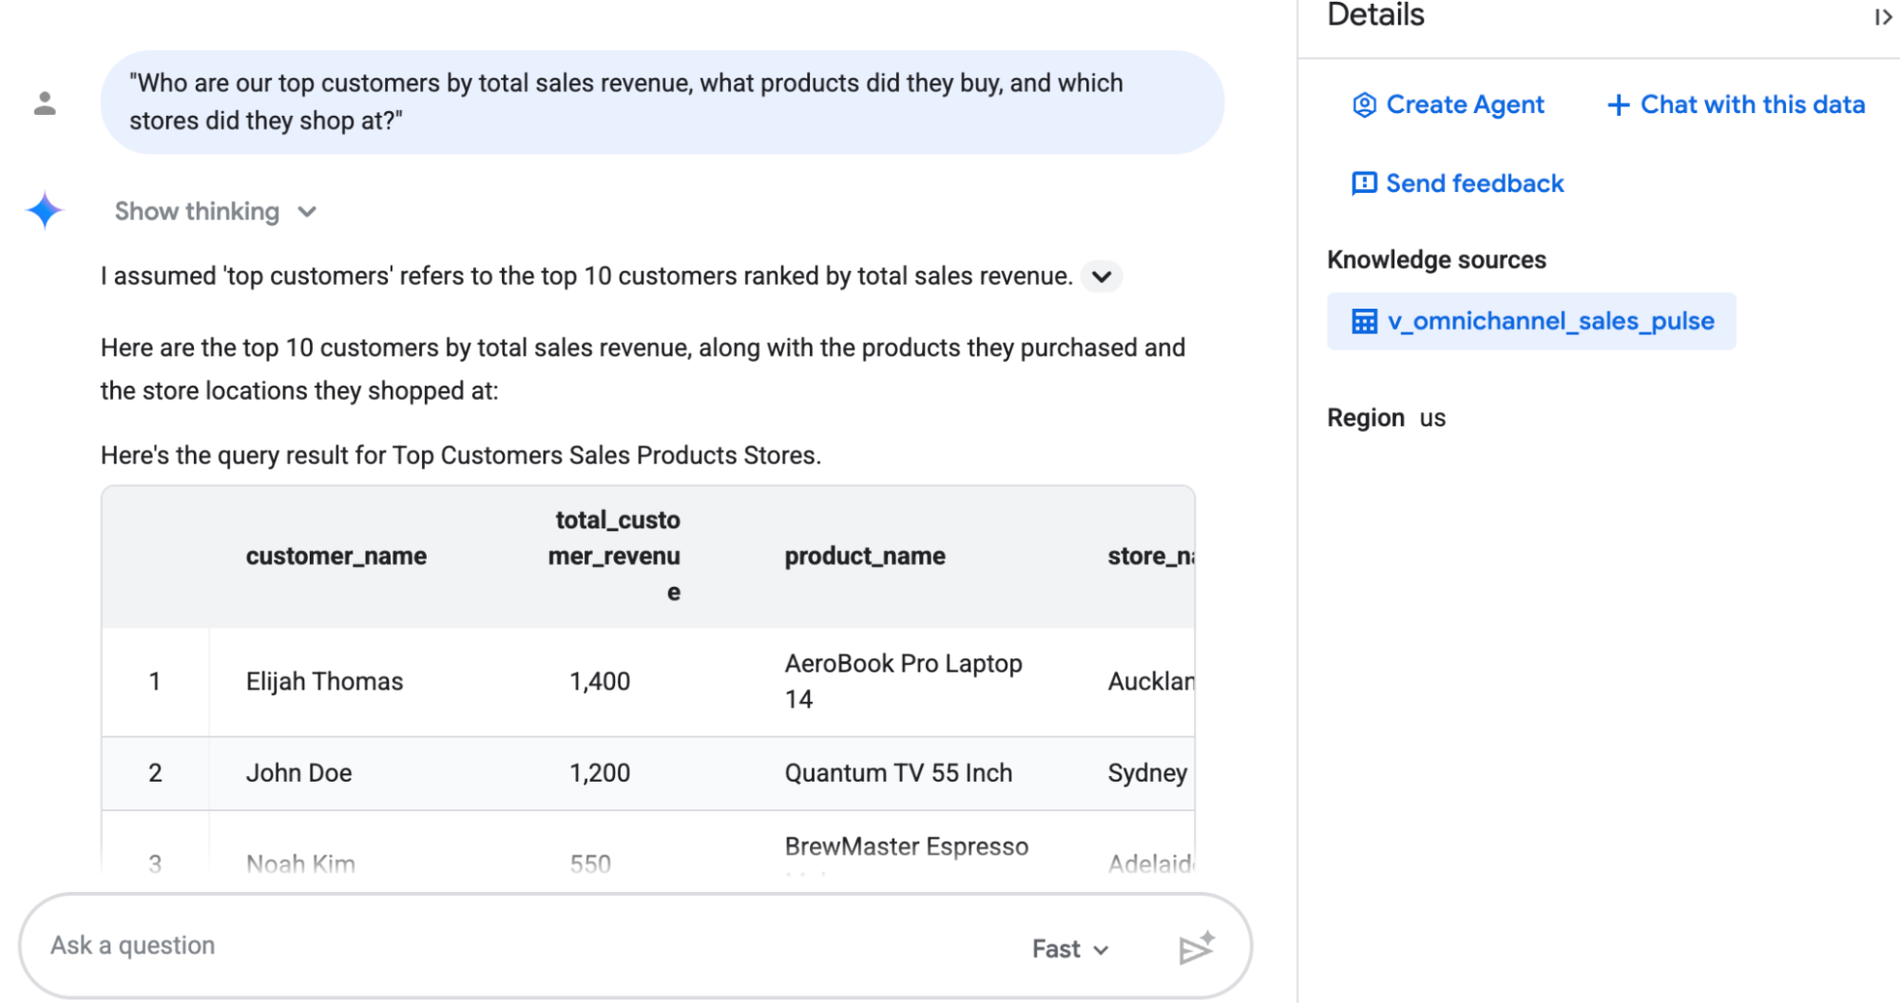
그림 3: BigQuery의 대화형 분석은 일반 언어 프롬프트를 Snowflake, Databricks, AWS Glue 전반의 페더레이션 쿼리로 변환합니다.
캐싱 및 데이터 레지던시 계획
프로덕션에 페더레이션 카탈로그를 배포하기 전에 다음 운영 동작을 고려하세요.
-
백그라운드 새로고침 주기:
--refresh-interval플래그는 메타데이터 동기화를 제어합니다. 최소 간격은 300초입니다. 수백 개의 테이블이 포함된 대규모 카탈로그의 경우 메타데이터 검색에 더 오랜 시간이 걸릴 수 있습니다. 동기화 주기가 지연되어 실행 시간이 초과되면, BigQuery는 태스크 큐가 쌓이는 것을 방지하기 위해 다음 예약된 실행을 건너뜁니다. -
자동 쿼리 캐싱: BigQuery는 검색된 크로스 클라우드 데이터 블록을 페더레이션 카탈로그가 있는 리전(예:
us-central1)에 캐시합니다. 이렇게 하면 반복되는 쿼리에서 네트워크 전송을 줄일 수 있습니다. 캐시된 블록은 해당 리전의 Google Cloud Storage 내에 상주하므로 조직의 데이터 레지던시 정책에 부합하는지 확인하세요. -
암호화 설정: 크로스 클라우드 캐시 블록은 Google 관리 암호화 키를 사용합니다. 조직에서
constraints/gcp.restrictNonCmekServices정책 제약 조건을 시행하는 경우, BigQuery는 캐시를 거치지 않고 모든 쿼리에 대해 원격 스토리지에서 데이터를 직접 읽어옵니다. -
액세스 측정항목 모니터링: 쿼리 실행 계획에서 캐시 사용률을 평가할 수 있습니다. BigQuery 작업 통계의
objectStorageStats섹션을 확인하여cacheBytesRead를objectStorageBytesRead와 비교합니다.
다음 단계
요약하자면, Google Cloud의 경계 없는 Lakehouse를 사용하면 비용이 많이 드는 마이그레이션이나 추가 데이터 파이프라인 빌드 없이도 데이터가 어디에 있든 상관없이 데이터를 바로 활용할 수 있습니다. 지금 바로 경계 없는 Lakehouse 아키텍처 문서를 확인하여 지원되는 리전과 사용자 인증 정보 구성에 대해 자세히 알아보세요. 경계 없는 Lakehouse Codelab을 통해 외부 카탈로그를 단계별로 페더레이션하는 방법을 연습할 수 있습니다. 마지막으로 Google Cloud 계정팀 또는 고객 엔지니어에게 문의하여 특정 데이터 플랫폼이나 업종에 맞는 경계 없는 Lakehouse 패턴을 검토해 보세요.
부록
Snowflake 및 AWS Glue 크로스 클라우드 데이터 액세스 설정
Snowflake와 BigQuery 연결
Snowflake Horizon Catalog 구성
먼저 Snowflake에서 데이터베이스, 스키마, Iceberg 테이블을 만듭니다. Snowflake Horizon에서 관리형 Iceberg 테이블은 개방형 Apache Iceberg REST 카탈로그 인터페이스를 자동으로 노출합니다.
외부 엔진이 이 카탈로그를 읽을 수 있도록 전용 리더 역할을 설정하고 데이터베이스, 스키마, 테이블 전체에 대한 순회 권한을 부여하세요.
SQL
다음으로 gcloud 명령줄 도구를 사용하여 Google Cloud 내에 페더레이션 카탈로그를 만듭니다. Snowflake 계정 식별자, 리더 역할, 루트 Iceberg 데이터베이스 이름이 필요합니다.
bash
Apache Iceberg REST 사양에서 --snowflake-warehouse는 가상 컴퓨팅 웨어하우스가 아니라 카탈로그 루트 데이터베이스 이름(SF_RETAIL_DB)을 참조합니다.
카탈로그가 생성되면 카탈로그 정보를 조회하여 할당된 숫자 서비스 계정 ID를 확인합니다.
bash
Snowflake로 돌아가 워크로드 아이덴티티 제휴(WIF)를 통해 Google Cloud의 숫자 ID를 비밀번호 없는 서비스 사용자에게 연결합니다.
SQL
이 과정을 통해 OpenID Connect 기반의 비밀번호 없는 인증이 설정되며, BigQuery는 Snowflake Horizon에서 직접 테이블 메타데이터를 탐색하고 쿼리 실행 시에만 유효한 임시 사용자 인증 정보를 발급받을 수 있게 됩니다.
AWS Glue Data Catalog 구성
AWS에서 IAM ID를 준비하고, AWS Glue와 Amazon S3 전반에 액세스 권한을 설정하고, Iceberg 테이블을 등록하는 과정부터 시작합니다.
먼저 trust_policy.json이라는 이름의 플레이스홀더 신뢰 정책을 만듭니다. 이렇게 하면 Google Cloud에서 고유한 카탈로그 서비스 에이전트를 할당하기 전에 AWS IAM 역할을 프로비저닝할 수 있습니다.
AWS CLI를 사용하여 IAM 역할을 만듭니다. 세션 시간을 12시간(43200초)으로 설정하면 장기 실행 분석 쿼리 중에 사용자 인증 정보가 만료되는 것을 방지할 수 있습니다.
다음으로 permissions_policy.json이라는 이름의 파일에 권한 정책을 정의합니다. 이 정책은 BigQuery에 AWS Glue 카탈로그 메타데이터를 읽고 Amazon S3에 있는 기본 Parquet 데이터 파일에 액세스할 수 있는 권한을 부여합니다.
새로 만든 역할에 이 권한 정책을 연결합니다.
중요 (AWS Lake Formation): AWS 환경에서 AWS Lake Formation을 사용하는 경우 IAMAllowedPrincipals 그룹에 대상 데이터베이스 및 테이블에 대한 액세스 권한이 있는지 확인합니다(또는 버킷이 AWS Lake Formation에 등록된 경우 lakehouse_glue_federation_role에 명시적 Lake Formation 권한을 부여합니다). 이 설정이 없으면 Lake Formation 보안 설정이 IAM 역할의 카탈로그 메타데이터 액세스를 차단합니다.
권한 설정이 완료되면 Amazon Athena를 사용하여 AWS Glue에 데이터베이스와 Iceberg 테이블을 만듭니다.
AWS Glue를 BigQuery에 연결
다음으로 gcloud 명령줄 도구를 사용하여 Google Cloud 내에 페더레이션 카탈로그를 등록합니다. 12자리 AWS 계정 ID, AWS 리전, 위에서 만든 역할 ARN이 필요합니다.
AWS 신뢰 정책이 전파되는 동안 백그라운드 새로고침이 너무 일찍 실행되어 실패하는 것을 방지하려면, 새로고침 일정을 설정하지 않은 상태로 카탈로그를 초기 설정하세요.
다음으로 Google Cloud에서 카탈로그에 할당한 고유한 숫자 소유자 ID를 추출합니다.
AWS CLI로 돌아가서 IAM 역할의 신뢰 정책을 업데이트하고 플레이스홀더를 확인된 Google Cloud ID로 바꿉니다.
5. 메타데이터 동기화 사용 설정 및 확인
bash
네임스페이스가 검색되고 동기화되었는지 확인합니다.
bash