コンテンツに移動
デベロッパー

LLM ワークロードはすべて同じではない: 分類と生成における TPU のパフォーマンス ベンチマーク

2026年9月14日
https://storage.googleapis.com/gweb-cloudblog-publish/images/hero_2_fvBime0.max-2500x2500.jpg
Rupjit Chakraborty

AI Engineer

※この投稿は米国時間 2026 年 9 月 5 日に、Google Cloud blog に投稿されたものの抄訳です。

大規模言語モデル(LLM)を試験運用版のプロトタイプからエンタープライズ規模の本番環境に移行すると、インフラストラクチャがパフォーマンスの上限とユニット エコノミクスの両方を左右するという重要な事実が明らかになります。多くの標準的なハードウェア ベンチマークでは、すべての LLM リクエストが同じようにシリコンに負荷をかけるわけではないという基本的な現実が見過ごされています。

この投稿では、Google Cloud TPU v6e 上で Gemma 3 12B と Gemma 3 27B を比較する包括的なベンチマーク テストについて詳しく見ていくことで、「構造的に異なるワークロードを大規模に処理する場合、TPU インフラストラクチャの実際のパフォーマンスはどうなるのか?」というアーキテクチャに関する重要な問題を考えます。

主な結果と提案

ベンチマークの手法を詳しく説明する前に、TPU v6e で Gemma 3 をデプロイするアーキテクトにとって重要なポイントを以下に示します。

生成タスクにおけるパフォーマンスの壁

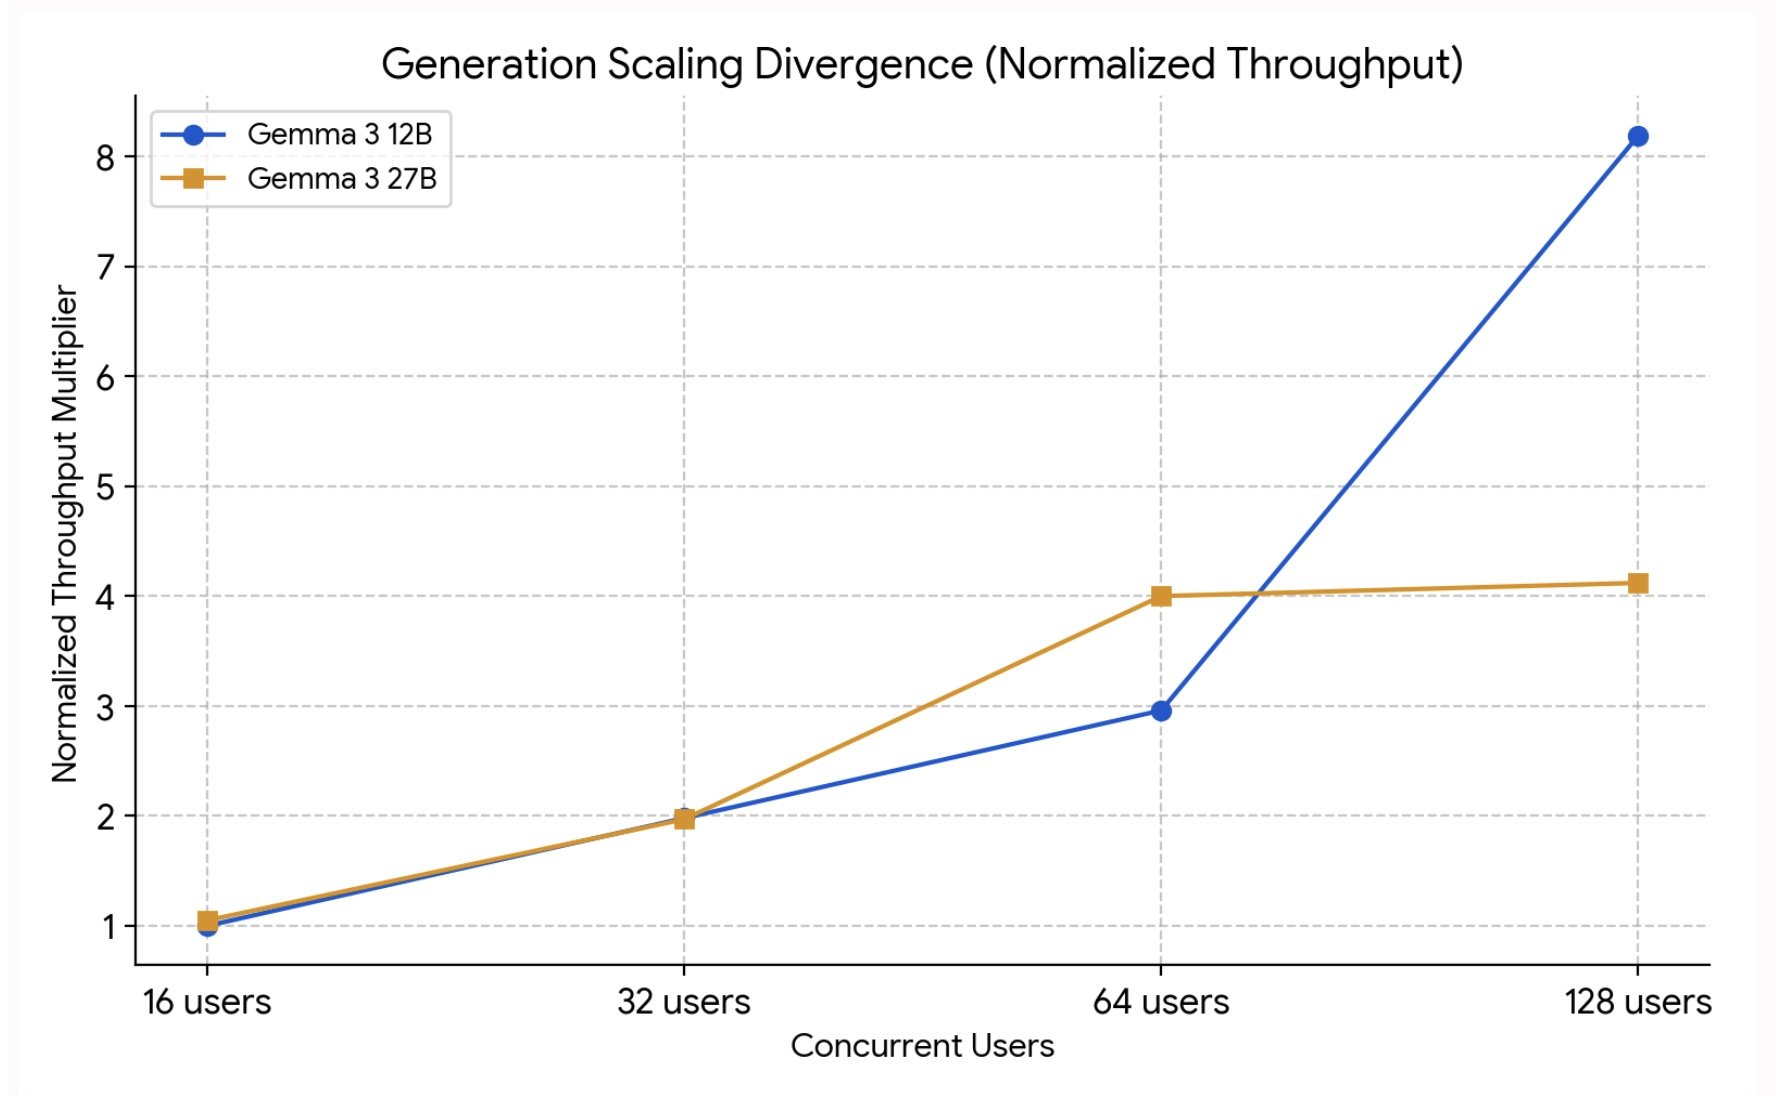
デコード負荷が高い生成タスクでは、Gemma 3 27B モデルは同時ユーザー数が 64 人を超えるとパフォーマンスの限界に達し、128 人では正規化スループット係数が 4.12 倍で頭打ちになります。一方、12B モデルは最大 8.19 倍までスケールアップします。

提案: 多くの生成を同時実行するワークロードの場合は、12B モデルに縮小するか、27B モデルでレプリカあたりの同時リクエスト数を 64 に制限する厳格な Pod 自動スケーリング制限を設定します。

分類タスクでは互角

プリフィル負荷が高い分類タスクでは、モデルのパラメータ サイズの影響が大きく下がります。12B モデルと 27B モデルはどちらも、TPU を飽和させることなく、同様のピーク スケーリング(ユーザー 128 人で正規化スループットが約 6.0 ~ 6.4 倍)を達成しています。

提案: 要約や分類のワークフローでは、スループットを低下させることなく、より大規模で高性能なモデルを安全にデプロイできます。平均の --max-num-seqs や --max-model-len は、平均ユーザー負荷とリクエストあたりの平均トークン数に基づいて慎重に維持する必要があります。そうしないと、リクエストのドロップが発生する可能性があります。

壁を回避するための設計

ハードウェアの飽和は、深刻なレイテンシの急増と、リクエストのサイレント ドロップアウトとして現れます。これを軽減するには、標準の CPU / メモリ スケーリング トリガーに依存しないようにします。代わりに、エンドツーエンド(E2E)レイテンシ指標に基づいてスケールし、積極的な vLLM バケット パディング最適化(VLLM_TPU_BUCKET_PADDING_GAP)を実装してメモリを節約します。

アーキテクチャの構成

推論スタックは、次の 3 つの主な要素に分けることができます。

1. インフラストラクチャ: GKE と TPU

今回のデプロイメントの基盤となったのは、Google Kubernetes Engine(GKE)Autopilot クラスタです。これに、2×2 チップ トポロジで構成された単一ホストの TPU v6e ノードプールを接続しました。

2. ソフトウェアとツール: vllm

サービング フレームワークには、vllm-project/tpu-inference を介して vLLM を活用しました。

3. モデル: Gemma 3 12B、27B

今回は、Gemma 3 12B と Gemma 3 27B という 2 つの高性能なオープン ウェイト モデルを評価しました。これらのモデルには HuggingFace 経由でアクセスしました。

ワークロード: 分類と生成

すべての LLM リクエストがシステムに同じ負荷をかけるわけではありません。今回は、分類と生成という 2 つの異なるシナリオで、同時ユーザー数が 16 人、32 人、64 人、128 人の場合のベンチマークを実施しました。

  • 分類(高入力、低出力): このユースケースは、e コマースのコンプライアンス タスクを模倣するものです。プロンプトには、商品ルール、アイテムの説明、OCR で抽出されたテキストの大きなブロックが含まれています。出力は非常に小さく、通常はアイテムを「許可」または「禁止」に分類するだけです。入力シーケンス長(ISL)は約 4,000 トークン、出力シーケンス長(OSL)は約 10 トークンです。

  • 生成(低 / 中入力、高出力): このユースケースは、長文テキストの生成を模倣するものです。プロンプトでは、労働市場における AI の未来に関する詳細な分析的政策提言書を求めます。モデルは、ほとんどの時間を数百のトークンのデコードとストリーミングに費やします。入力シーケンス長(ISL)は 500 トークン、出力シーケンス長(OSL)は約 1,000 トークンです。

結果と考察

スループット(リクエスト数/秒)、エンドツーエンドのレイテンシなどの指標を測定した結果、パラメータ サイズとハードウェア帯域幅の相互作用について興味深い知見が得られました。アーキテクチャの整合性を確保するため、ベンチマークはすべて vllm-project/tpu-inference ハードウェア プラグインを使用して実行され、max-model-len=128000、max-num-batched-tokens=8192、max-num-seqs=512 という標準的なグローバル サービング構成が利用されました。

生成タスクにおけるスケーリングの相違

生成タスクでは、同時ユーザー数が 64 人まで、両モデルのパフォーマンスは同等です。しかし、同時ユーザー数が 128 人になると、Gemma 3 12B モデルのほうが大幅にスケーリングに優れ、正規化スループット係数が 8.19 倍に達します。一方、Gemma 3 27B モデルは 4.12 倍で頭打ちになります(ユーザー数 16 人での Gemma 3 12B のベースラインに対する正規化)。これは、生成負荷が高い状況では、より大規模な 27B モデルのほうが大幅に早くメモリまたはコンピュートの上限に達することを示唆しています。

同時ユーザー数 Gemma 3 12B のスループット(リクエスト数/秒) Gemma 3 27B のスループット(リクエスト数/秒)
16 人 1.00 倍 1.05 倍
32 人 1.98 倍 1.97 倍
64 人 2.96 倍 4.00 倍
128 人 8.19 倍 4.12 倍
https://storage.googleapis.com/gweb-cloudblog-publish/images/generation_scaling.max-1800x1800.jpg

分類タスクにおけるパフォーマンスは互角

分類タスクでは、Gemma 3 12B モデルと Gemma 3 27B モデルのスケーリング動作にほとんど差はありません。どちらのモデルもハードウェアの容量内で効率的に動作し、スケーラビリティに優れています。同時ユーザー数が 128 人の場合、正規化スループットのピークは約 6.04~6.37 倍に達します(ユーザー数 16 人での Gemma 3 12B のベースラインに対する正規化)。
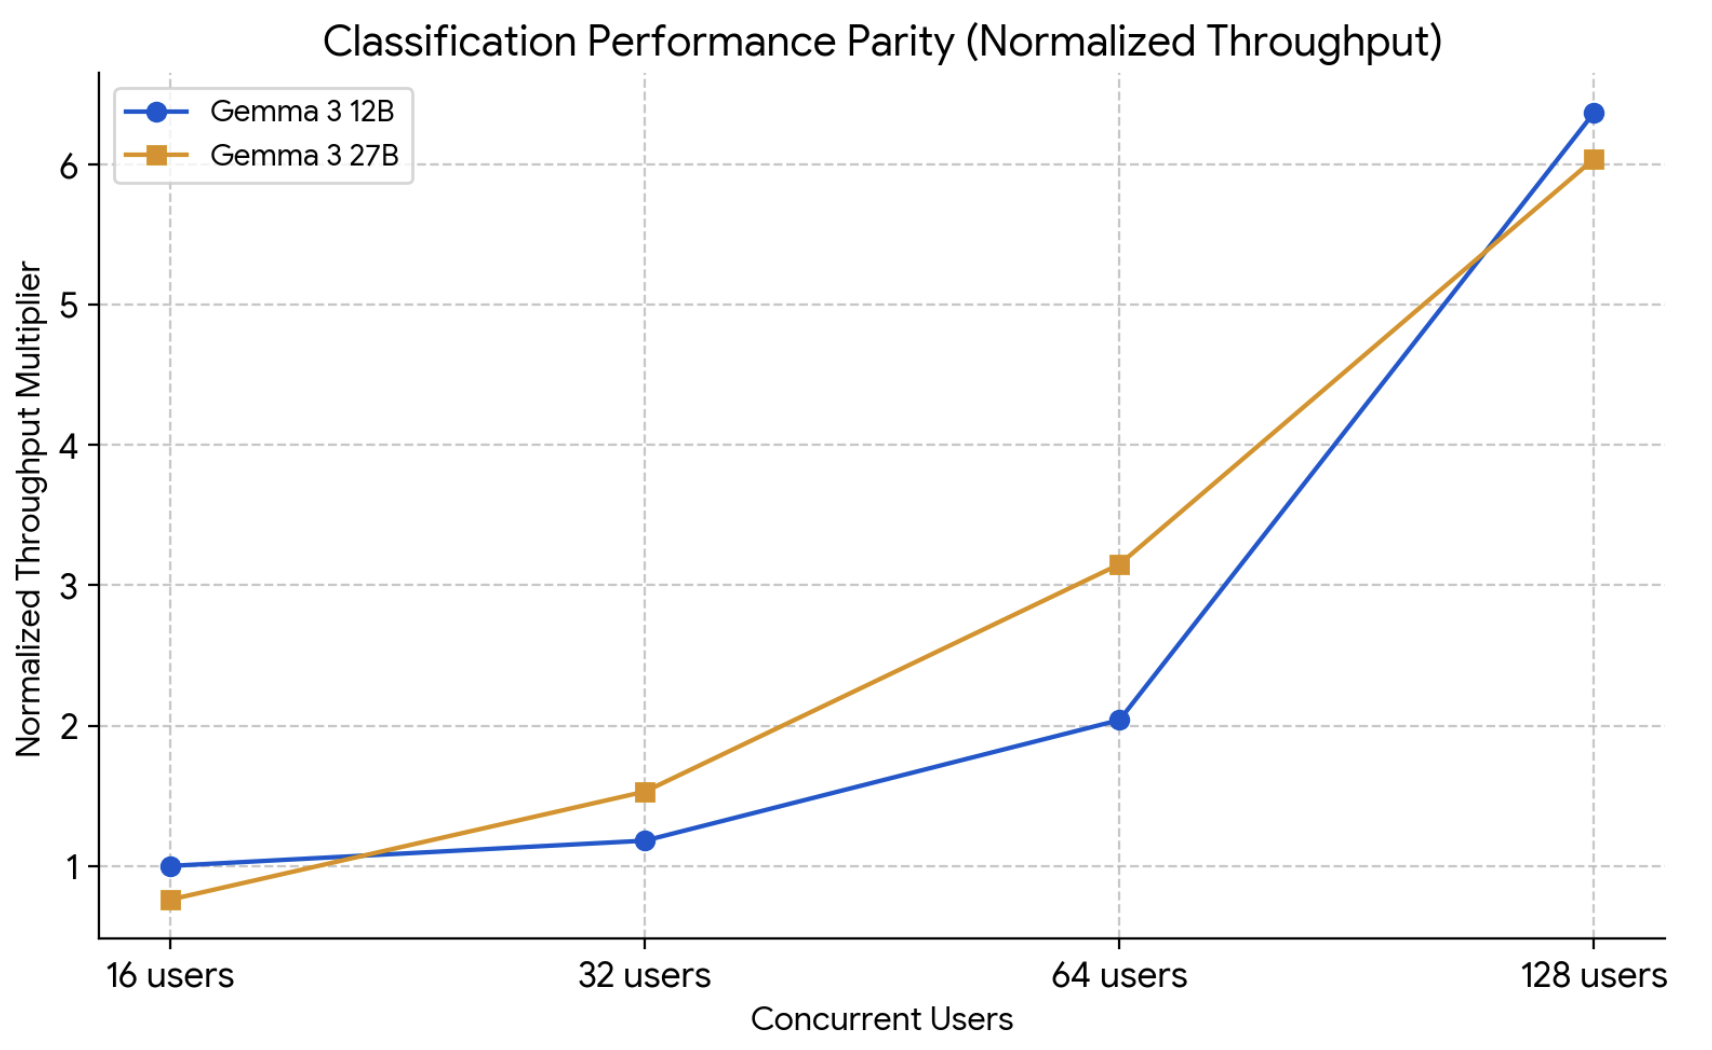
同時ユーザー数 Gemma 3 12B のスループット(リクエスト数/秒) Gemma 3 27B のスループット(リクエスト数/秒)
16 人 1.00 倍 0.76 倍
32 人 1.18 倍 1.53 倍
64 人 2.04 倍 3.15 倍
128 人 6.37 倍 6.04 倍
https://storage.googleapis.com/gweb-cloudblog-publish/images/classification_perf_table_image2.max-1800x1800.png

レイテンシしきい値の分析

エンドツーエンド(E2E)のレイテンシは、モデルのサイズとタスクによって異なるスケーリング動作を示します。同一のサービング ハイパーパラメータ(--max-num-seqs=512)を使用した場合、Gemma 3 12B モデルにおける分類タスクのレイテンシは、ユーザー数が 32 人から 64 人に増えると約 2 倍になり、リソースの競合が発生していることを示します。これに対して、より大規模な Gemma 3 27B モデルでは、分類タスクのレイテンシはユーザー 32 人から 64 人の間で比較的横ばいであり、ユーザー 128 人で 2 倍になります。
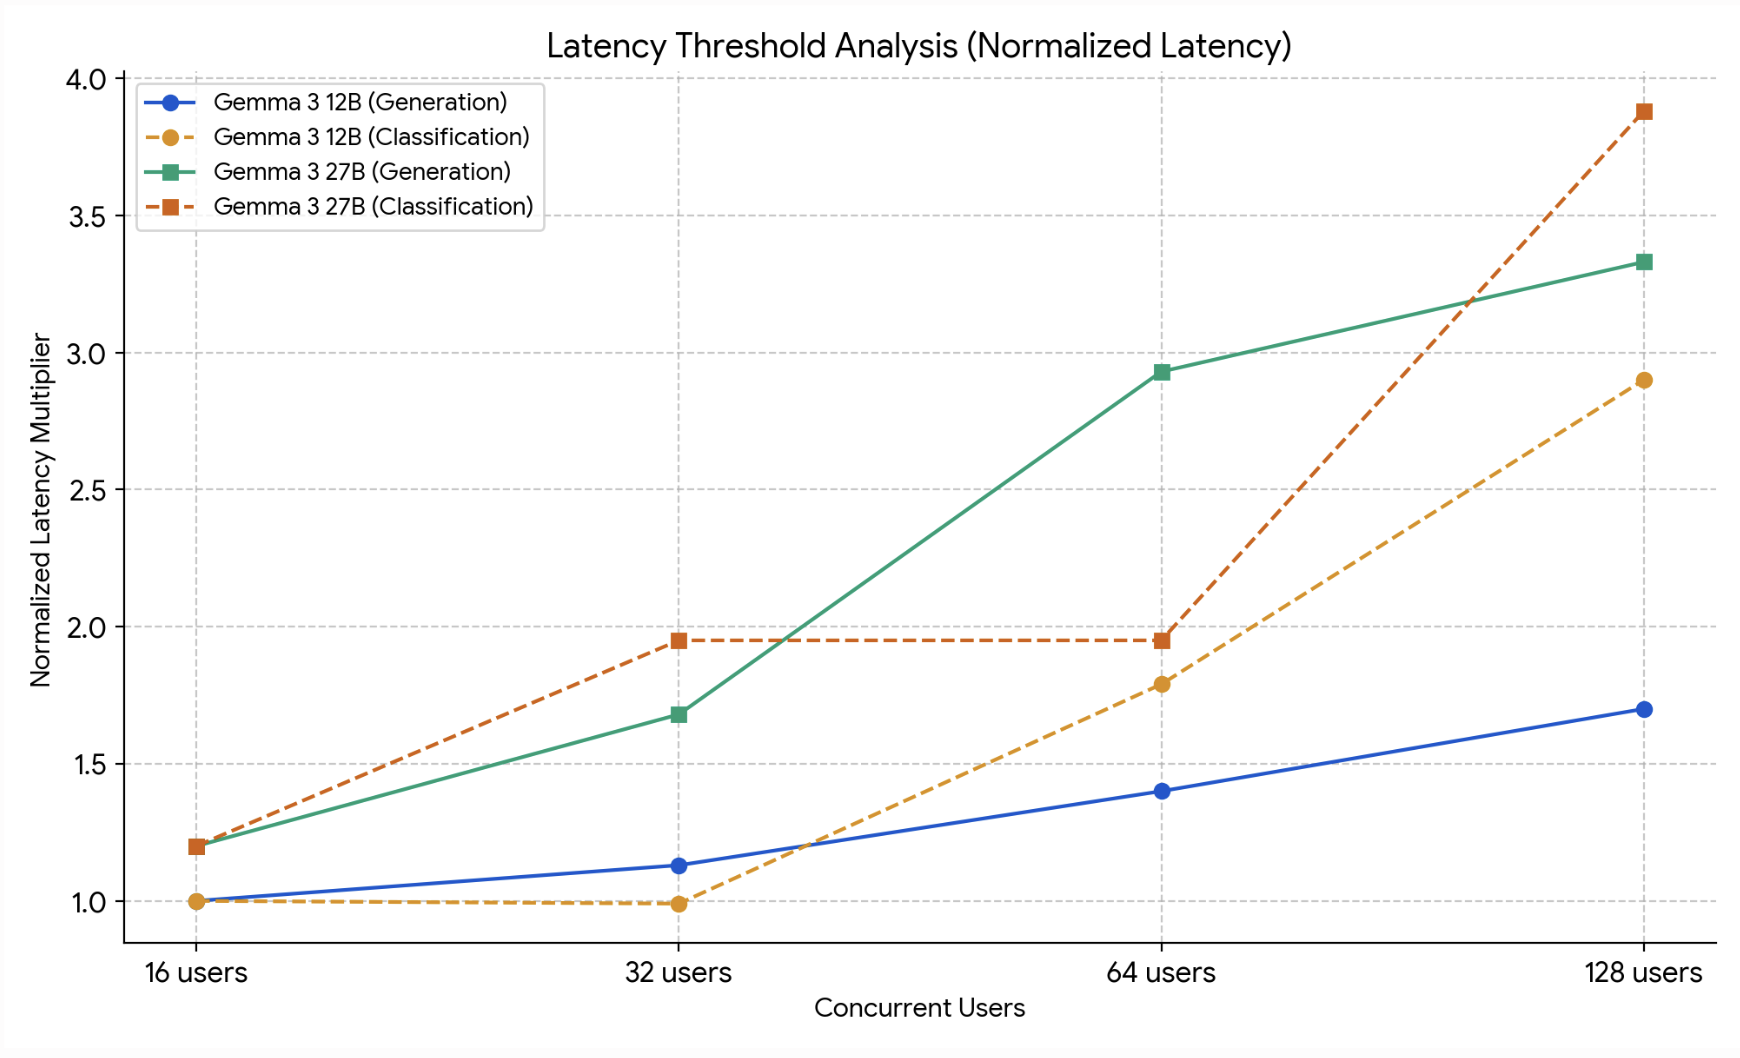
モデル タスク 16 人 32 人 64 人 128 人
Gemma 3 12B 生成 1.00倍 1.13倍 1.40倍 1.70倍
Gemma 3 12B 分類 1.00倍 0.99倍 1.79倍 2.90倍
Gemma 3 27B 生成 1.20倍 1.68倍 2.93倍 3.33倍
Gemma 3 27B 分類 1.20倍 1.95倍 1.95倍 3.88倍
https://storage.googleapis.com/gweb-cloudblog-publish/images/latency_threshold_image3.max-1800x1800.png

まとめ

Google Cloud TPU v6e アーキテクチャで Gemma 3 12B モデルと 27B モデルのベンチマークを実施した結果、推論パフォーマンスの予測因子は、生のパラメータ数だけではないことがわかりました。むしろ、サービング フレームワーク、ハードウェア トポロジ、ワークロード トークン比率の相互作用が効率を左右します。生成タスク(低入力、高出力)では、同時実行数が多い場合、12B モデルのほうが優れていることが実証されました。12B モデルは 8.19 倍の相対スループット係数を維持する一方、27B モデルは 4.12 倍で飽和しました。これに対して、プリフィル負荷が高い分類タスクでは、両モデルのパフォーマンスが同等であるため、組織はスケーリングを大幅に損なうことなく、より大規模なモデルをデプロイできます。今回の評価では、ハードウェアの飽和しきい値を正確にマッピングしました。たとえば、分類ではユーザー 64 人でエンドツーエンドのレイテンシが 2 倍になり、生成ではユーザー 128 人で急激に増加します。この結果をもとに、コストをかけてオーバープロビジョニングを行うのではなく、データドリブンな自動スケーリング トリガーを正確に設定できます。最終的に、これらのピーク指標を達成するには、vLLM のパラメータを積極的にチューニングする必要があります。たとえば、バッチ処理を行うトークンの調整や、TPU 固有のバケット パディングの構成によって、コンピュートの無駄を防ぎます。これは、AI インフラストラクチャの費用対効果を高めるためには、本番環境ワークロード固有の入出力プロファイルにモデルの選択とサービング構成を厳密に合わせる必要があることを実証しています。

LLM ワークロードをスケールするために

最適化されていないインフラストラクチャが、エンタープライズ AI の展開のボトルネックにならないようにしましょう。さまざまなワークロードの形状がハードウェアの飽和にどのように影響するかを理解したところで、これらの知見を実践に活かしましょう。

  • 今回のベンチマークを使用して本番環境アーキテクチャのサイズを適正化します。プリフィル負荷が高い分類タスクには、スループットを低下させることなく、より大規模な Gemma 3 27B を安全に活用できます。一方、デコード負荷が高い生成タスクを高い同時実行数で処理する場合は、線形スケーリングを維持するために 12B モデルへの切り替えを検討してください。

  • TPU v6e ノードプールを備えた Google Kubernetes Engine(GKE)を使用してデプロイし、スケーラビリティに優れたマネージド AI 基盤と専用の vllm-project/tpu-inference ハードウェア プラグインを構築します。また、Gemini Enterprise Agent Platform の Model Garden を介してデプロイすることも、Gemma 3 モデルのサービング用に TPU VM をスピンアップすることもできます。

本番環境へのデプロイで、同様のパフォーマンスの壁にぶつかったことはありませんか?Google Cloud コミュニティ フォーラムで、スケーリング戦略を共有し、質問を投稿し、ディスカッションに参加してください。

- AI エンジニア Rupjit Chakraborty
投稿先