AI エージェントの準備は完了。では、データは?
Sirish Chandrasekaran
VP, Product Management
※この投稿は米国時間 2026 年 7 月 24 日に、Google Cloud blog に投稿されたものの抄訳です。
組織による AI イニシアチブの拡張を妨げている最大のボトルネックの一つは何でしょう?それは、現在のモデルの機能ではありません。ビジネス コンテキストとセマンティックな意味へのアクセスです。
エージェントの時代における企業は、単にデータを保存するだけでなく、信頼できるコンテキストでデータを有効活用し、受動的な記録システムから能動的な「アクション システム」へと移行する必要があります。
しかし、AI エージェントは非線形的な速度で動作します。たとえば、1 つのプロンプトでエージェントが複数のシステムを対象に自律的にブラウジングを行い、クエリを発行して処理を実行する場合、基盤となるインフラストラクチャに負荷をかけることがあります。コンピューティング、ネットワーキング、ストレージの各レイヤがエージェント型 AI 向けに最適化されていない場合、その上に位置するデータ プラットフォームは崩壊します。
Google のインフラストラクチャの現状に関するレポートによると、本番環境グレードのエージェント型 AI システムをサポートするにはインフラストラクチャのアップグレードが必要だと考える組織が 83% を占めています。
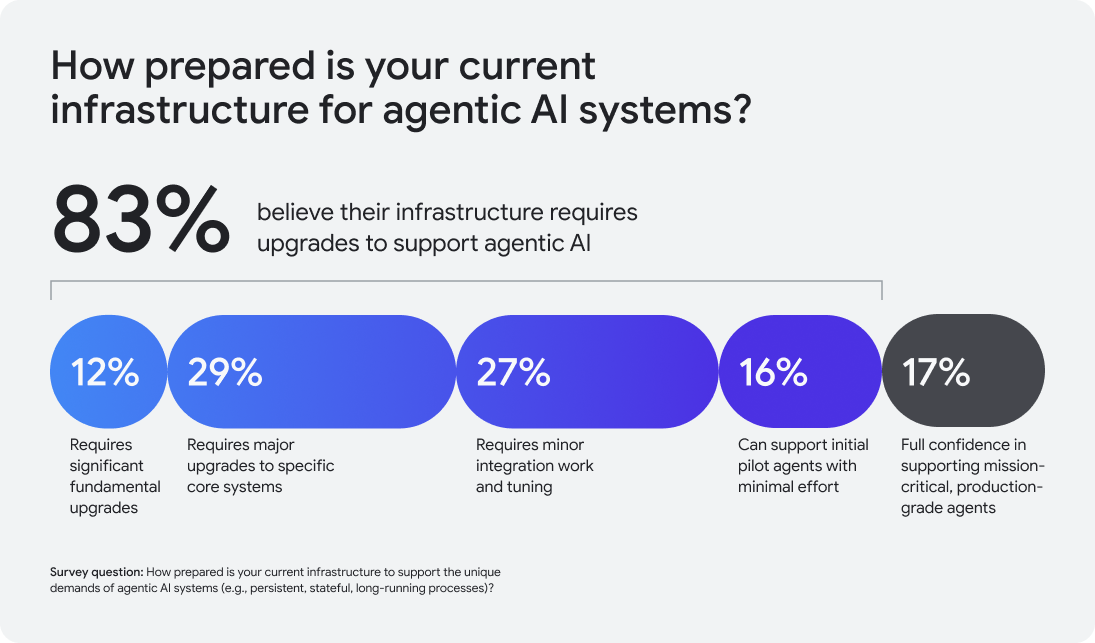
この問題を解決するために、Google は Google Cloud Next 2026 で Agentic Data Cloud を発表しました。これは、データ、AI モデル、運用データベースを単一の「アクション システム」に統合するソリューションです。Agentic Data Cloud を機能させるには、チップからモデルまで、すべてが AI ネイティブである必要があります。基盤となるインフラストラクチャは、エージェントの負荷に対応できる必要があります。
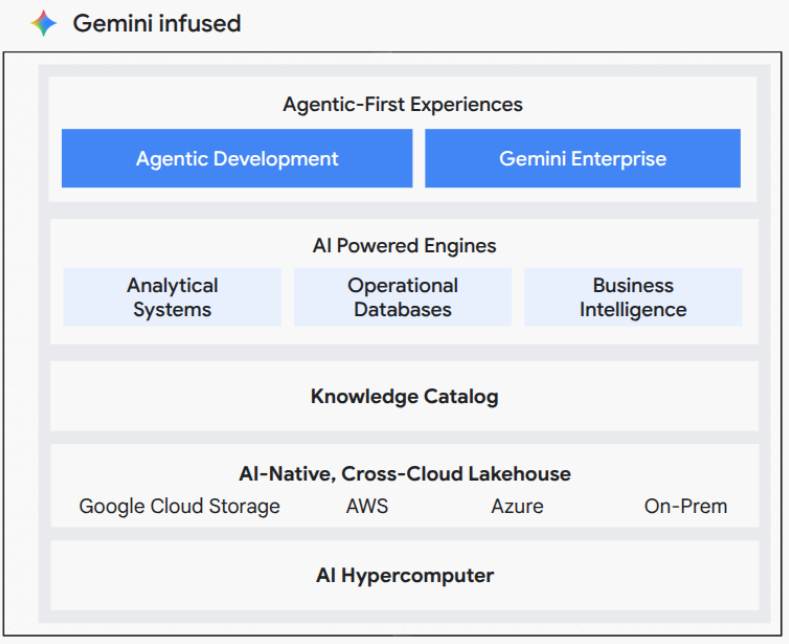
Google の Agentic Data Cloud
適切なインフラストラクチャ基盤を整えることで、組織が現在直面している最大のデータ課題を Agentic Data Cloud がいかに解決できるか、以降で見ていきましょう。
コンテキストの欠如を克服する
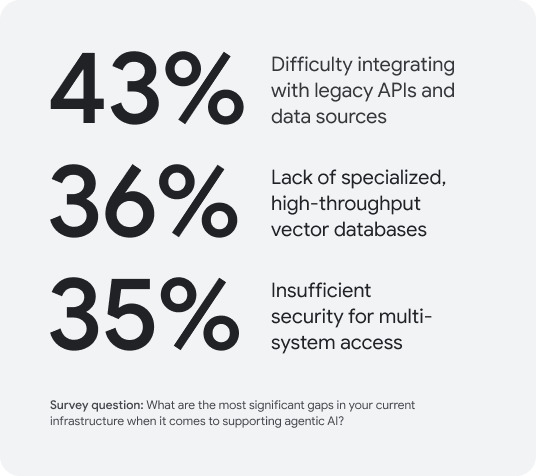
エージェント型システムを効果的に機能させるにはコンテキストにアクセスする必要がありますが、こうしたコンテキストは、多くの場合、断片化されたデータシステムや従来のアーキテクチャに存在します。このため、エージェントがこうしたコンテキストを把握することが難しくなり、不完全かつ不正確な結果につながる可能性があります。実際、Google のレポートによると、43% の IT リーダーが「従来の API やデータソースとの統合の難しさ」をエージェント型 AI インフラストラクチャの最大のギャップとして挙げています。
しかし、組織が膨大なデータセットを移動して AI に接続しようとする場合、必ず複雑さと費用の増大が伴います。
Agentic Data Cloud は、オープンかつ柔軟なインフラストラクチャ上で実行されるボーダーレスなレイクハウスを活用することで、この問題を解決します。エージェントは、オープン スタンダード(Apache Spark、Apache Iceberg)を介して BigQuery や Spanner などの強力なネイティブ エンジンにアクセスすることで、従来の環境で発生するレイテンシと費用を回避しながら、まるでローカルであるかのように複数の環境間でデータを読み取り、推論し、有効活用できます。
不要な手作業を回避する
分断されたシステムの寄せ集めにエージェントをスケールすると、大きなボトルネックが生じる可能性があります。Google の調査では、AI をスケールする際の予期せぬ費用の筆頭として、81% のリーダーが運用の複雑さとエンジニアリングのオーバーヘッドを挙げています。その例として、エンジニアが異なるシステムにまたがる AI エージェントを手動でつなぎ合わせる作業に費やす時間が挙げられています。
「考える」エージェントから「実行する」エージェントに移行するには、分析ソースと運用ソースの両方でリアルタイム データを接続できなければなりません。これには垂直統合が必要です。モデル、データシステム、基盤となるアクセラレータが共同設計された AI ネイティブ インフラストラクチャ上に Agentic Data Cloud を構築すると、ネットワーク ホップが減り、ツールがより適切に統合されます。この統合システムにより、エージェントは典型的なエンジニアリングのオーバーヘッドなしで分析情報を取得し、安全なトランザクションをトリガーできます。
データに信頼と知識をもたらす
エージェントに必要なのは、データを検出してクエリを実行する機能だけではありません。安全かつ正確なアクションを実行するには、豊富なコンテキストとビジネス ロジックも必要です。しかし、36% のリーダーが、AI モデルのグラウンディングに使用される専門的な高スループットのベクトル データベースの不足を、インフラストラクチャの主要なギャップとして挙げています。このギャップにより、エージェントにコンテキストを提供する能力が損なわれます。
エージェントがその可能性を最大限に発揮するには、レガシー ERP やサードパーティ CRM を含むデータシステムに対してリアルタイムで読み書きを実行できるように構築された基盤が必要です。また、複雑なタスクを実行する際に、たとえば 3 週間前のユーザーの好みを「思い出す」ことができる長期記憶も必要です。こうしたリアルタイムの自動化がない場合、エージェントはクエリごとにデータを再処理する必要があります。
AI にコンテキストを提供するために、組織は Knowledge Catalog を使用してデータレイク内のデータを集約して拡充し、エージェントによる検索を可能にしています。非構造化データから意味を抽出してセマンティクスを自動生成することで、カタログはアクティブな推論レイヤとして機能するようになります。そして、そのカタログは、エージェントが適切なコンテキストを取得できるように、高スループットのインフラストラクチャによって支えられている必要があります。
将来を見据える
今こそ、AI によって真の競争優位性を獲得するために、接続されたアクティブなデータ エコシステムを構築する絶好のタイミングです。試験運用から本番環境に移行するには、エージェントがすべてのデータにシームレスにアクセスできるようにする必要があります。また、エージェントの時代の要求に対応できるインフラストラクチャで、これを支える必要があります。2026 年以降に勝利を収められるのは、必ずしも高度にスマートなエージェントを備える企業とは限りません。これらのエージェントに適切な知識を、安全かつ費用対効果の高い方法で大規模に提供できる企業が勝利するでしょう。貴社のデータは、エージェントの時代に対応する準備ができていますか?
エージェント型 AI 時代におけるインフラストラクチャの現状に関するレポートで、アーキテクチャに対して AI に最適化されたアプローチを採用しているリーダーたちの手法をご確認ください。
- プロダクト管理、データ分析担当バイス プレジデント、Sirish Chandrasekaran