AI インフラストラクチャの動的容量管理
Drew Bradstock
Sr. Director, Product, Orchestration & Kubernetes
※この投稿は米国時間 2026 年 8 月 27 日に、Google Cloud blog に投稿されたものの抄訳です。
インターネットによって数十億の人々とモバイル デバイスがつながり、今や誰もがコンピュータを手にしています。現在、私たちは次なる大きなテクノロジー シフトの真っ只中にいます。そこでは、何百万もの自律型 AI エージェントがデプロイされ、従業員やエンドユーザーとともに働くようになっています。このたび、Google は組織がプロジェクト レベルで AI 費用を管理し、トークン ショックを解消できるよう、Gemini Enterprise の新しい FinOps コントロールを発表しました。しかし、エージェント時代の圧倒的なスケールは、インフラストラクチャを含むスタックのあらゆるレイヤに新たな制約をもたらしています。AI ワークロードは、設計の難しさ、リソース消費の激しさ、そしてバースト性があることで知られています。これらはスケーリングのボトルネックを招くだけでなく、十分に活用されない(または誤用される)コンピューティング リソースを大量に発生させる原因にもなります。
組織は、インフラストラクチャへの投資からさらなる価値を引き出すための分析情報を必要としています。このブログ記事では、動的容量管理のベスト プラクティスについて説明します。これは、コストとパフォーマンスの予測可能性を維持しながら、単一の柔軟な基盤上でエンタープライズ アプリケーションと AI アプリケーションを実行できるようにするための、スケジューリングと利用の戦略です。これらの機能は、オンデマンド、Spot、確約利用割引(CUD)といった使用量モデルを強化するように設計されており、ワークロードに応じた柔軟な料金設定と割引を提供します。それでは詳しく見ていきましょう。
概要
動的容量管理を実装する 3 つの方法:
-
計画されたイベントの容量をスケジュールする。Dynamic Workload Scheduler のカレンダー モードを使用して、計画されたイベントに先立ってミッション クリティカルなリソース(GPU、TPU、特定の VM ファミリー)をスケジュールしたり、Flex Start モードを使用して、開始時間が柔軟なバッチジョブの費用を最適化したりできます。容量が確保されると、指定した期間、それらのリソースが保証されます。
-
すべてのアプリケーションのフォールバック計画を作成して、サービスの継続性を維持する。マネージド インスタンス グループ(MIG)を使用して、優先順位に基づいたハードウェアの自動フォールバック リストを定義します。これにより、希望するオプションが利用できない場合でも、アプリが次の承認済みコンピューティング オプションに自動的に切り替わるようにします。
-
単一の適応型コントロール プレーンで、容量管理のライフサイクル全体を自動化する。Google Kubernetes Engine(GKE)は、カスタム ComputeClass を使用したフォールバック リストから、動的リソース割り当てを通じたきめ細かいハードウェア スライスまで、プロセス全体をオーケストレートするエージェント ネイティブ環境を提供します。これにより、リソースを即座に再割り当てしながら、安全なサンドボックスやコンテナ内でエージェントを迅速にスピンアップすることが可能になります。
アーキテクチャの柔軟性が重要な理由
企業の 90% が今後 3 年以内にエージェントを導入したいと考えていますが、現在の IT 環境でその負荷を処理できると確信している IT リーダーはわずか 17% に留まっています。これらのワークロードには独自のパフォーマンス ニーズがあるため、各組織はアクセラレータ(GPU、TPU)や、コンピューティング・メモリ・ストレージの比率をカスタマイズした CPU といった専用インフラストラクチャの導入を急ピッチで進めています。しかし、エージェントはエンタープライズ アプリケーションやデータベースにもアクセスする必要があります。しかもそのアクセス量やスケールは、人間による通常の使用をはるかに凌駕することが少なくありません。エージェントとエージェントがやり取りするアプリケーションの両方からの大きな需要に対応するには、動的なインフラストラクチャが必要です。インフラストラクチャ チームは、Google の Axion のようなカスタム設計のプロセッサを活用してこれらのニーズを満たすことができますが、ハードウェアだけでは完全なソリューションにはなりません。そのインフラストラクチャを賢く利用し、実行の非効率性を解決して、スタック全体でより柔軟性を高める方法も必要です。
インフラストラクチャの制約を克服する方法
このような柔軟性を実現するには、2 つのアプローチが必要です。予測できる需要に対してリソースを確保することと、予測できない需要に対応するための自動化を構築することです。この 2 つを組み合わせることで、計画されたイベントの容量を事前にスケジュールし、手動による介入なしにインフラストラクチャを予期しない変更に適応させることができます。
1. 計画されたイベントの容量をスケジュールする
Dynamic Workload Scheduler を使用すると、予定されているマイルストーン、オフライン トレーニング、予想される需要の急増に先立って、ミッション クリティカルな容量を確保できます。必要なリソースを事前にスケジュールすることで、費用を最適化し、必要なコンピューティング リソースに確実にアクセスできます。Dynamic Workload Scheduler は、ハードウェア アクセラレータ(TPU と GPU)と一部の CPU をサポートしており、次の 2 つのモードがあります。
-
Flex Start モード: バッチ処理、モデル トレーニング、オフライン ファインチューニングなど、レイテンシを許容できるワークロードに使用します。リソースをすぐに要求するのではなく、期間を定義したリクエストを送信することで、システムがジョブをインテリジェントにキューに入れ、容量が利用可能になり次第、リソースをプロビジョニングします。これにより、コスト効率を最大化し、需要の高いアクセラレータを確保できる可能性を大幅に高めることができます。
-
カレンダー モード: 主要なプロダクトのリリース、予定されている移行、季節的なトラフィックの急増など、ミッション クリティカルで時間制限のあるイベントに使用します。イベントの正確な開始日と終了日を指定することで、将来の予約を作成します。これにより、イベントの開始時に、リクエストされた容量が確実に利用可能になります。

2. すべてのアプリケーションのフォールバック計画を作成して、サービスの継続性を維持する
トラフィックの急増は、必ずしも予測できるものではありません。また、ニュース速報や市場の急激な変化などによってユーザー アクティビティが急増し、予期しないトラフィックが発生した場合に備えて計画を立てる必要もあります。サービスが必要なリソースを中断なく取得できるようにするには、フォールバック計画(許容可能なハードウェア構成の優先順位を付けた自動シーケンス)が必要です。この戦略により、以下のことが可能になります。
-
ワークロードを単一の VM シェイプ、サイズ、構成から切り離します。これにより、希望するオプションが利用できない場合でも、手動介入なしで実行できます。
-
最新世代の VM を第一の選択肢として採用し、旧世代の VM を自動フェイルバック オプションとして保持することで、段階的な技術更新を実行できます。
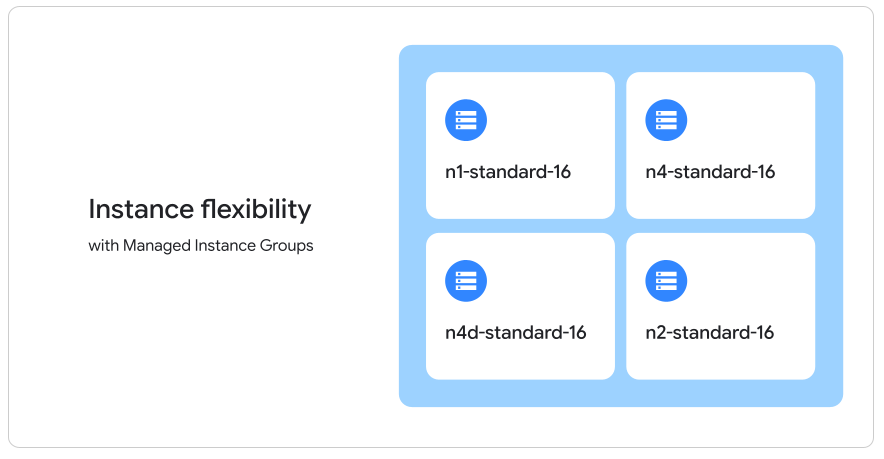
Google Compute Engine でコンテナ化されていないワークロードを実行する場合は、マネージド インスタンス グループ(MIG)のインスタンスの柔軟性と VM の一括作成を使用して、容量を動的に管理できます。インスタンスの柔軟性により、単一のマシンタイプに制限されることなく、VM インスタンスに複数のマシンタイプを指定できます。
仕組み: 希望するマシンタイプが一時的に利用できない場合、MIG はリアルタイムの容量に基づいて、リストから互換性のある代替マシンタイプを自動的にプロビジョニングします。これをロケーションの柔軟性と組み合わせる(MIG がリージョン内で検索できる複数のゾーンを指定する)ことで、プロビジョニングの成功率を大幅に向上させることができます。MIG が Spot VM を使用している場合、Compute Engine は Spot 容量シグナルと自動的に統合し、推定稼働時間が長く、プリエンプションのリスクが低いマシンタイプを優先します。
さらに、ベースライン ディスクのデフォルト設定とディスク オーバーライドの構成により、インスタンスの柔軟性をブロック ストレージ レイヤまで拡張することが可能です。これにより、VM が別のマシンタイプにフォールバックした際、ストレージもそれに応じて自動的に適応します。
仕組み: ほとんどの場合、デフォルトのオプションを使用するだけで十分です。インスタンス テンプレートから「ディスクタイプ」を完全に省略できます。ただし、関連付けられた VM よりも長く存続するデータディスクについては、複数の VM 世代にわたって高速で耐久性に優れた Hyperdisk を有効にできます。
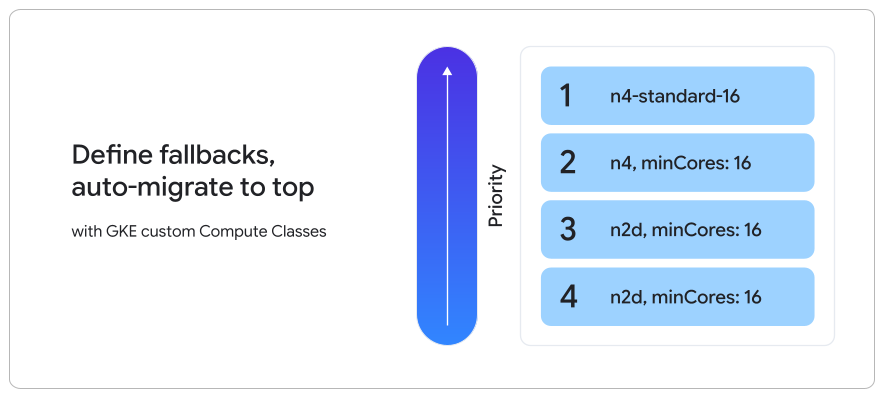
Compute Engine は仮想マシンを使用する組織にインスタンスの柔軟性を提供しますが、GKE はさらに一歩進んで、単一のコントロール プレーンから容量のライフサイクル全体を自動化します。GKE カスタム ComputeClass を活用することで、プラットフォーム チームは多次元のフォールバック リストを設計できるようになります。異なる VM マシン ファミリーやサイズ、構成比の自動的な組み合わせ、複数ゾーンにわたるスケーリング、さらにはオンデマンド VM とスポット VM の切り替えまで、柔軟な運用が可能です。Dynamic Workload Scheduler を容量ターゲットとして使用し、カスタム ComputeClass を使用してポリシーと優先度を定義することで、容量管理のライフサイクルを完全に自動化できます。
仕組み: ComputeClass を設定すると、GKE は希望するノード構成が利用できない状況を自動的に検出し、優先順位に従って事前に承認された代替オプションにフォールバックします。アクティブな移行が有効になっている場合、GKE は容量が利用可能になると、ワークロードを優先度の高いノード構成に正常に移行します。ブートディスクなどの一時的なディスクの場合、GKE はインスタンス ファミリーに基づいて適切なデフォルト設定を動的に選択します。ただし、VM よりも長時間存続するディスクには、Hyperdisk を使用できます。
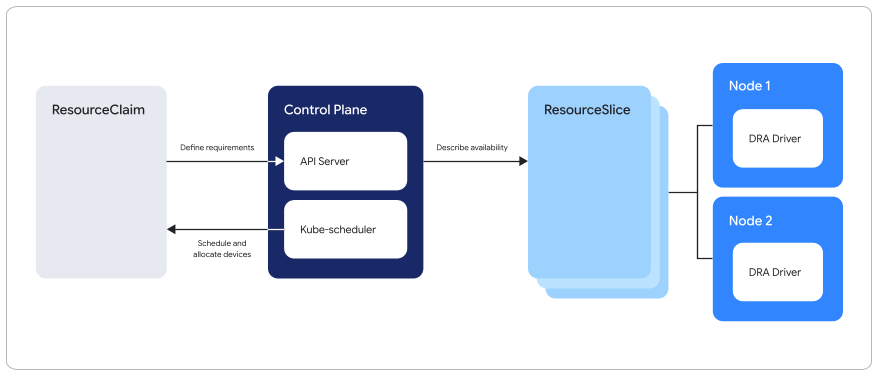
GKE のもう一つの機能である動的リソース割り当ては、リソースの消費方法を指示する高度なルールをデベロッパーが定義できるようにすることで、「全か無か」といった無駄の多いハードウェア割り当てを解消するのに役立ちます。
仕組み: GPU や TPU 全体を要求するのではなく、アプリケーションが合計メモリやコア数などの正確なパラメータを指定します。それに基づき、システムが最適なハードウェア スライスを割り当てるため、使用率を最大化し、費用を削減できます。
動的インフラストラクチャへの次のステップ
AI をスケールしても、インフラストラクチャの予算が比例して増大したり、技術的負債が蓄積したりするわけではありません。これらの例が示すように、適切なツールを使用することで、制約を克服し、コンピューティングへの投資から得られる価値を劇的に変えることができます。利用を開始するには、次の 3 つのステップを実行します。
-
ワークロードを監査して、すぐにコストを削減する: 現在、単一の VM ファミリー、マシンタイプ、またはアベイラビリティ ゾーンに緊密に結合されているアプリケーションを特定し、実行可能な代替ハードウェア シェイプをマッピングします。既存の構成だけでなく、ワークロード レベルの目標に基づいて、より適しているか、代替として機能する可能性のある新しいコンピューティング オプションを評価します。次に、Compute Engine MIG、VM の一括作成、または GKE カスタム ComputeClasses を使用して自動的に採用し、フォールバック リストに統合します。
-
最小利用額を確約して大幅な割引を受ける: 継続利用による自動割引に加え、コンピューティング フレキシブル確約利用割引を利用すれば、最大 63% の割引が適用されます。この割引は、特定のマシンタイプやロケーションに関係なく、使用するリソースに関連付けられます。
-
アカウント チームに問い合わせる: Google Cloud アカウント チームに連絡して、カスタマイズされた容量管理戦略を策定し、自動フォールバック リストを構成します。
- オーケストレーションおよび Kubernetes プロダクト担当シニア ディレクター、Drew Bradstock