パブリック データとプライベート データを統合: Spanner のデータコモンズによるナレッジグラフのスケーリング
Randeep Toor
Senior Technical Program Manager, Data Commons
Piyush Mathur
Group Product Manager, Databases
※この投稿は米国時間 2026 年 8 月 4 日に、Google Cloud blog に投稿されたものの抄訳です。
的確な意思決定を行うために、企業は社内データと公開リファレンス データを接続し、実世界の事物とその関係性を可視化するナレッジグラフを作成する必要に迫られることがよくあります。しかし、パブリックとプライベートのデータをつなぐには、従来、非常に複雑なプロセスを要していました。このたび、Spanner Graph でのデータコモンズの一般提供と、新しいデータコモンズ プラットフォームのプレビュー版のリリースにより、これらの接続を効率化し、独自のナレッジと公開データセットのナレッジグラフを統合できるようになりました。
包括的なデータコモンズ プロジェクトは、世界中の情報を整理し、世界中の人がアクセスできて使えるようにするという Google の使命を後押ししています。データコモンズは、国連、世界銀行、米国国勢調査局、ユーロスタット、WHO、NOAA など、100 を超える信頼できるデータ提供元の断片化された公開データセットを統合しており、標準化された Schema.org 定義で構造化された 4,000 億を超えるデータポイントを網羅しています。データコモンズは、クリーンなデータセットにアクセスして統合するためのデータ探索ツール、MCP ツール、クラウドベースの API を提供します。
データコモンズは、農業、人口統計、経済、環境、保健など、複数の分野にわたる公開情報を統合します。この標準化されたアプローチにより、強力なユースケースが可能になります。たとえば、国の GDP トレンドの分析、地域的な煙による汚染レベルのマッピング、地方自治体レベルでの健康の公平性の追跡、人口分布の経時的な変化の把握など、これらすべてを、事前処理と正規化が済んだデータを使用して行うことができます。
データコモンズ ナレッジグラフのディメンション
データコモンズは、膨大な公的行政データを、即座に活用可能なクラウドベースのインフラストラクチャを通じてユーザーに提供します。
Spanner Graph を活用したモダンなインフラストラクチャ
データコモンズを最初に構築した際、Google が目指したのは、当時利用可能だったツールを用いて、膨大かつ多種多様な公開データセットを統合することでした。このプラットフォームは、キャッシュ レイヤとして Bigtable を利用していました。これは、ネイティブのグラフ データベース テクノロジーが利用できなかった当時、大規模なルックアップを処理するための効果的な手法でした。
現在、Google はアーキテクチャをネイティブのグラフモデルである Spanner Graph に移行しました。これにより、SQL ライクなインターフェースの利便性とグラフの表現力が Spanner に備わるとともに、Spanner の強みである高可用性、水平スケーリング、マルチリージョンでのトランザクション整合性、そしてネイティブの ISO/IEC 39075 Graph Query Language(GQL)サポートが活用可能になりました。
マルチエンティティ Spanner Graph スキーマを採用することで、エンティティをノードとして、ドメインリンクを動的なグラフエッジとして表現できるようになりました。これにより、事前計算されたキャッシュ構造から脱却し、GQL を用いてデータベース内で直接、複雑な関係性クエリを実行することが可能になりました。
このアーキテクチャでは、費用のかかるインメモリでの再構築や複数のスナップショットを必要とする、複雑な事前計算インデックスが不要になるため、パイプラインも簡素化されます。Spanner Graph では、データベース全体を更新せずに特定のデータセットを増分更新できます。また、ステイル読み取りにより、データの取り込み中も一貫したデータ スナップショットが維持されます。
Spanner Graph への移行による主なメリット
-
統合ストレージと増分更新: Spanner Graph のマルチエンティティ スキーマを利用することで、複雑なキャッシュを増分データのインポートをサポートするモデルに置き換え、特定のデータセットに絞った更新を実現しています。
-
GraphRAG による動的なグラフ トラバーサル: 大陸 → 国 → 州 → 郡 → 市といった階層をその場で辿るような、マルチホップ クエリを実行します。これにより、静的キャッシュへの依存が解消され、データベースが自然言語クエリを構造化されたパスマッチング トラバーサルに直接マッピングする GraphRAG ワークフローが可能になります。
-
整合性のあるデータ スナップショット: Spanner の TrueTime とステイル読み取りを活用することで、バージョン整合性のあるデータ スナップショットを提供し、バッチ取り込みサイクル後も分散ノード全体でデータの一貫性を維持します。
-
大規模なオペレーショナル分析: Spanner のカラム型エンジンは、必要なフィールドのみを読み取ることで、大規模な時系列データセットを効率的にスキャンします。一方、Spanner の Data Boost テクノロジーを活用した BigQuery 連携 により、隔離された環境で EXTERNAL_QUERY を介して複雑な集計を実行できるようになり、本番環境のトラフィックを分離するのに役立ちます。
SDMX 3.0 の相互運用性によるシステムの橋渡し
複雑な統計データの活用を容易にするため、データコモンズでは、Statistical Data and Metadata eXchange(SDMX)技術標準のリーン実装を採用しています。SDMX は ISO 仕様として、統計データと記述的な統計メタ情報を記述および交換するための一貫したアプローチを提供します。
今回のデータコモンズ プラットフォームのアップデートでは、SDMX 技術標準バージョン 3.0 のサポートが追加されました。これにより、多次元データセットにおいて、Tableau、Flourish、Observable などのサードパーティ ツールとの即座の連携が可能になります。これは、API 標準の SDMX-JSON および SDMX-CSV 2.0 形式を使用して、2 つの重要なエンドポイントを介して可能になります。
-
アベイラビリティ API: 生のデータを読み取ることなく、既存のディメンション、変数、日付範囲を特定するための、プログラムによる検出メカニズム。
-
データ API: 実際の観測データとメタデータを取得します。名前付きパラメータを使用することで、ディメンションが追加された際にコードが壊れるのを防ぐことができます。
データコモンズ プラットフォームのプライベート インスタンスの変革
データコモンズ プラットフォームのプライベート インスタンスを構築したい組織にとって、この新しいモダンなアーキテクチャは、従来のスケーリング制限を解消し、データスキーマ化を簡素化します。デベロッパーは、Google のデータコモンズ インスタンスを支えるのと同じスケーラブルなテクノロジーを活用して、データコモンズ プラットフォームのプライベート インスタンスをインスタンス化できます。プライベート インスタンスでは、ユーザーは自身のデータを完全に管理し、アクセスを制限することができます。その一方で、自然言語クエリを活用して、独自のプライベート データと Google データコモンズ インスタンス上の公開データをシームレスに組み合わせて表示することも可能です。Google の公開ナレッジグラフと、お客様独自のデータを含むプライベート ナレッジグラフを連携させることで、データの分離を維持し、データの重複を回避しながら、魅力的な新しいユースケースを実現できます。
たとえば、小売企業は、国の GDP 推移、地域の人口構成の内訳、雇用統計などの公開データと、販売履歴、店舗のパフォーマンス指標、サプライ チェーンのロジスティクスといった自社データを組み合わせることができます。これにより、アナリストはマクロ経済の公開指標と自社の取引データを照らし合わせて、商品の流通を最適化し、未開拓の市場を特定することが可能になります。

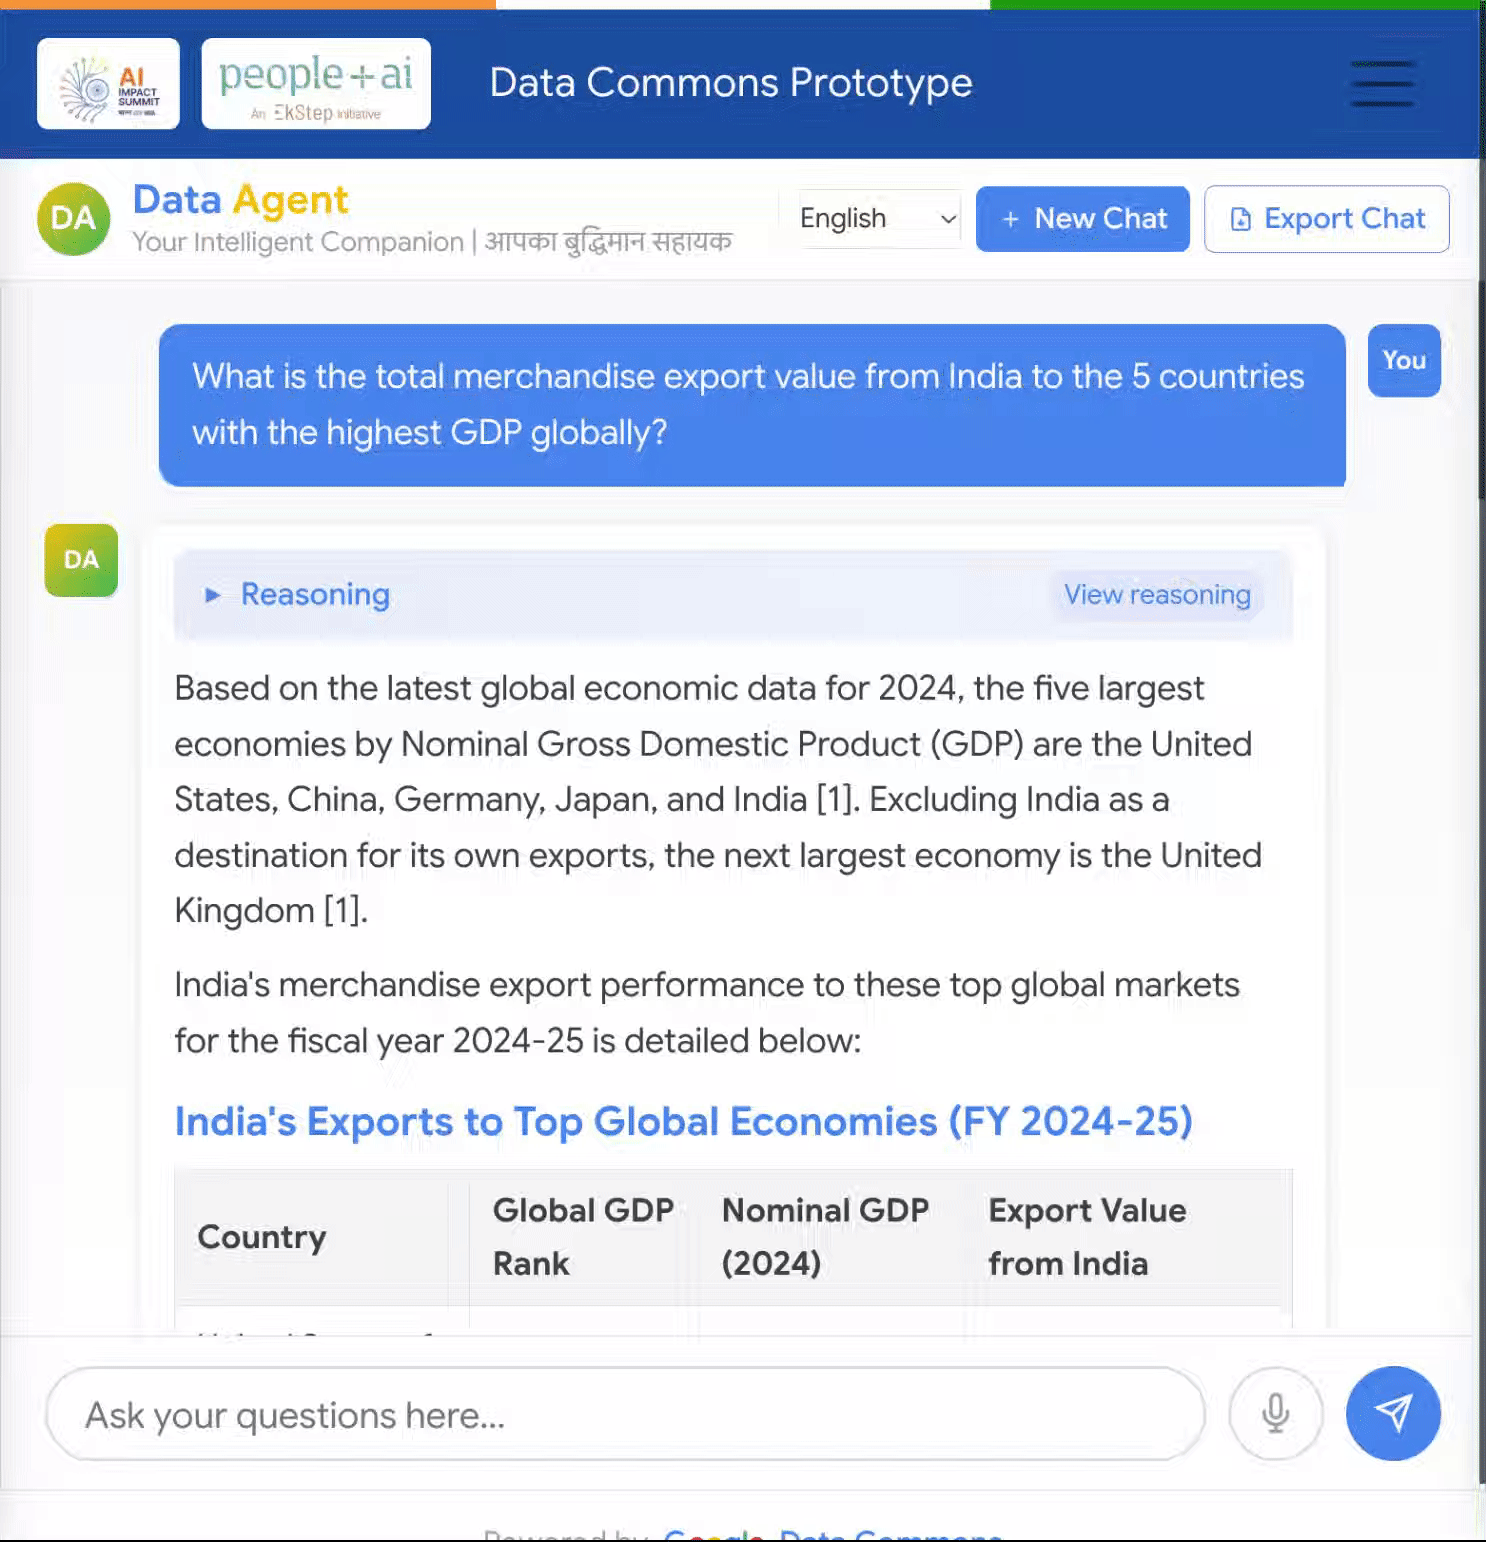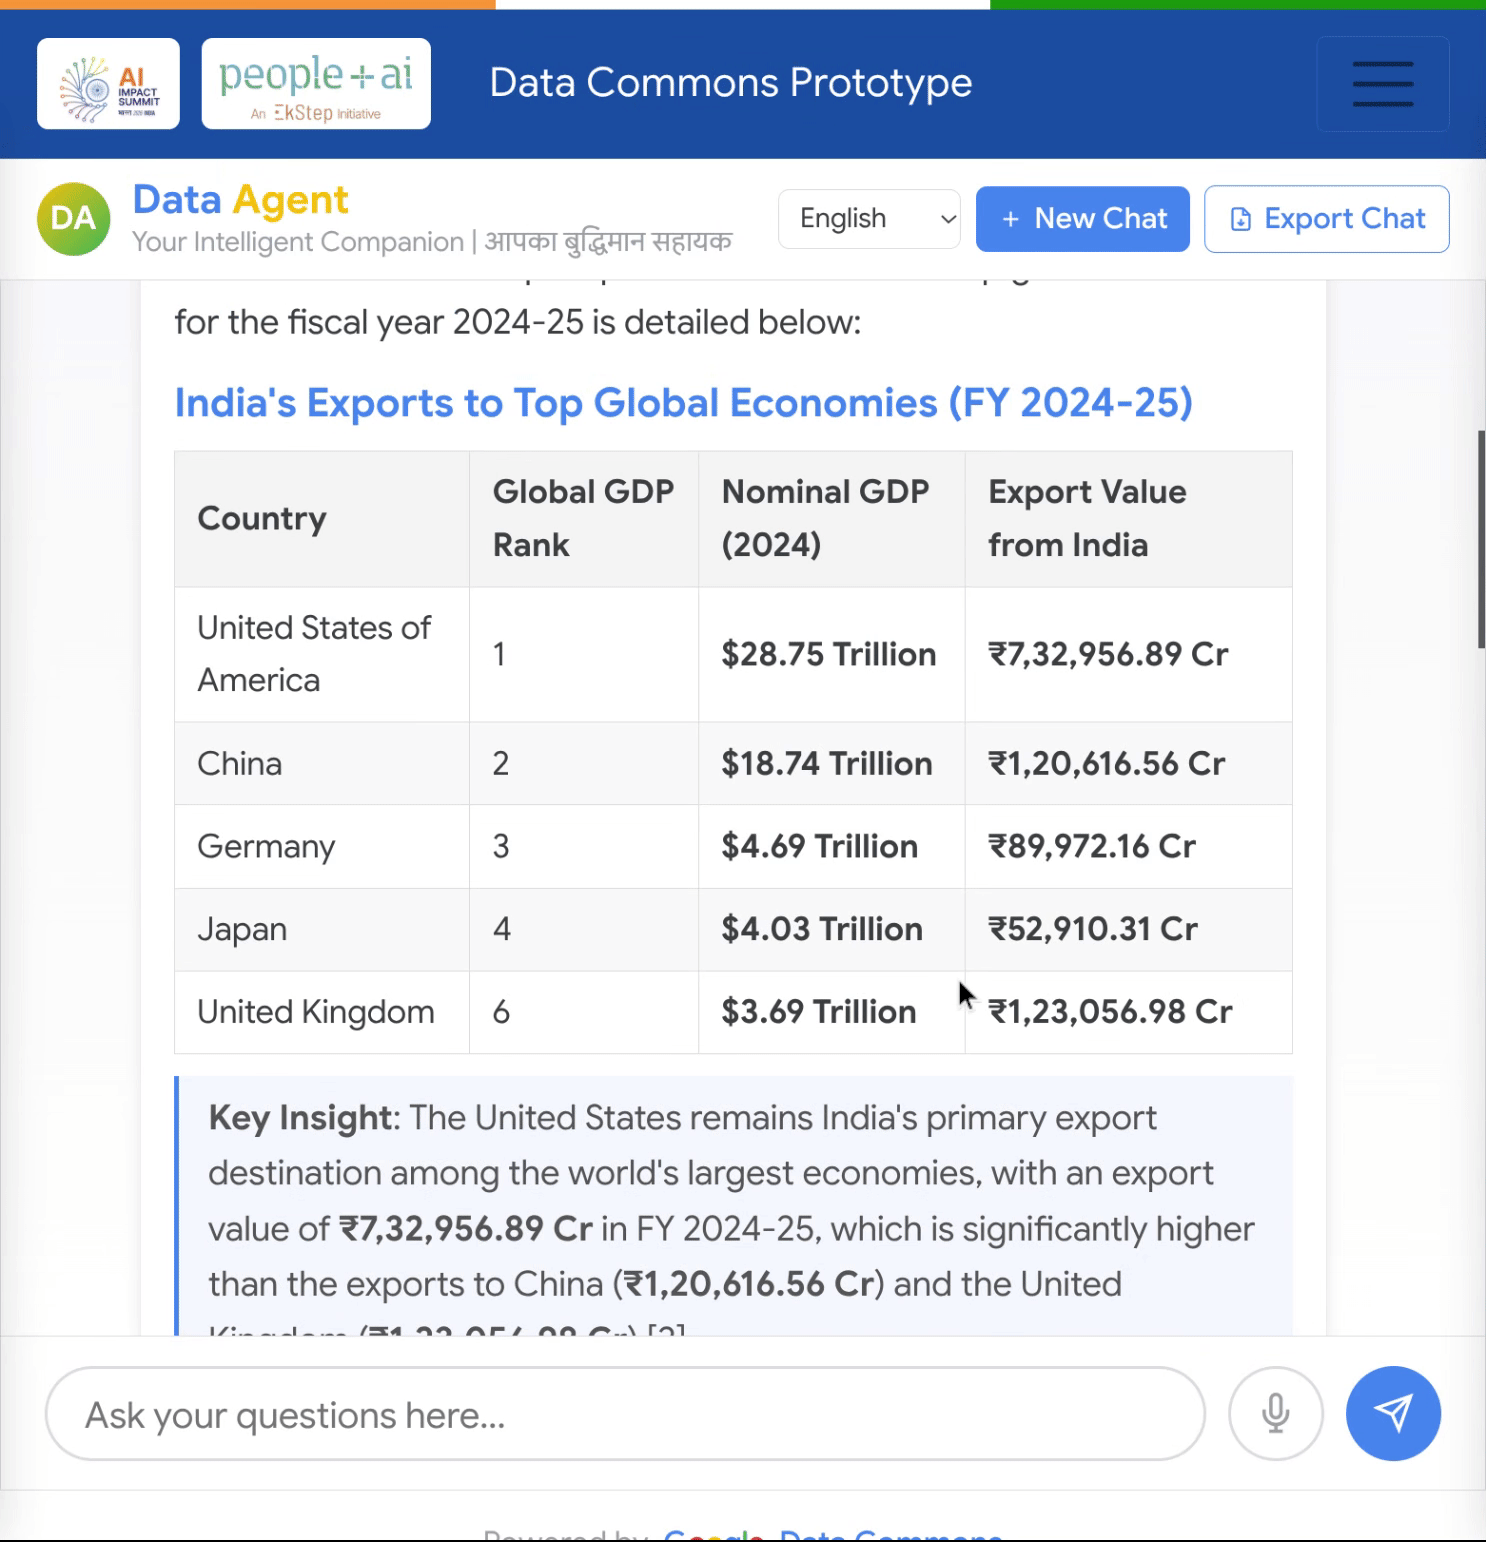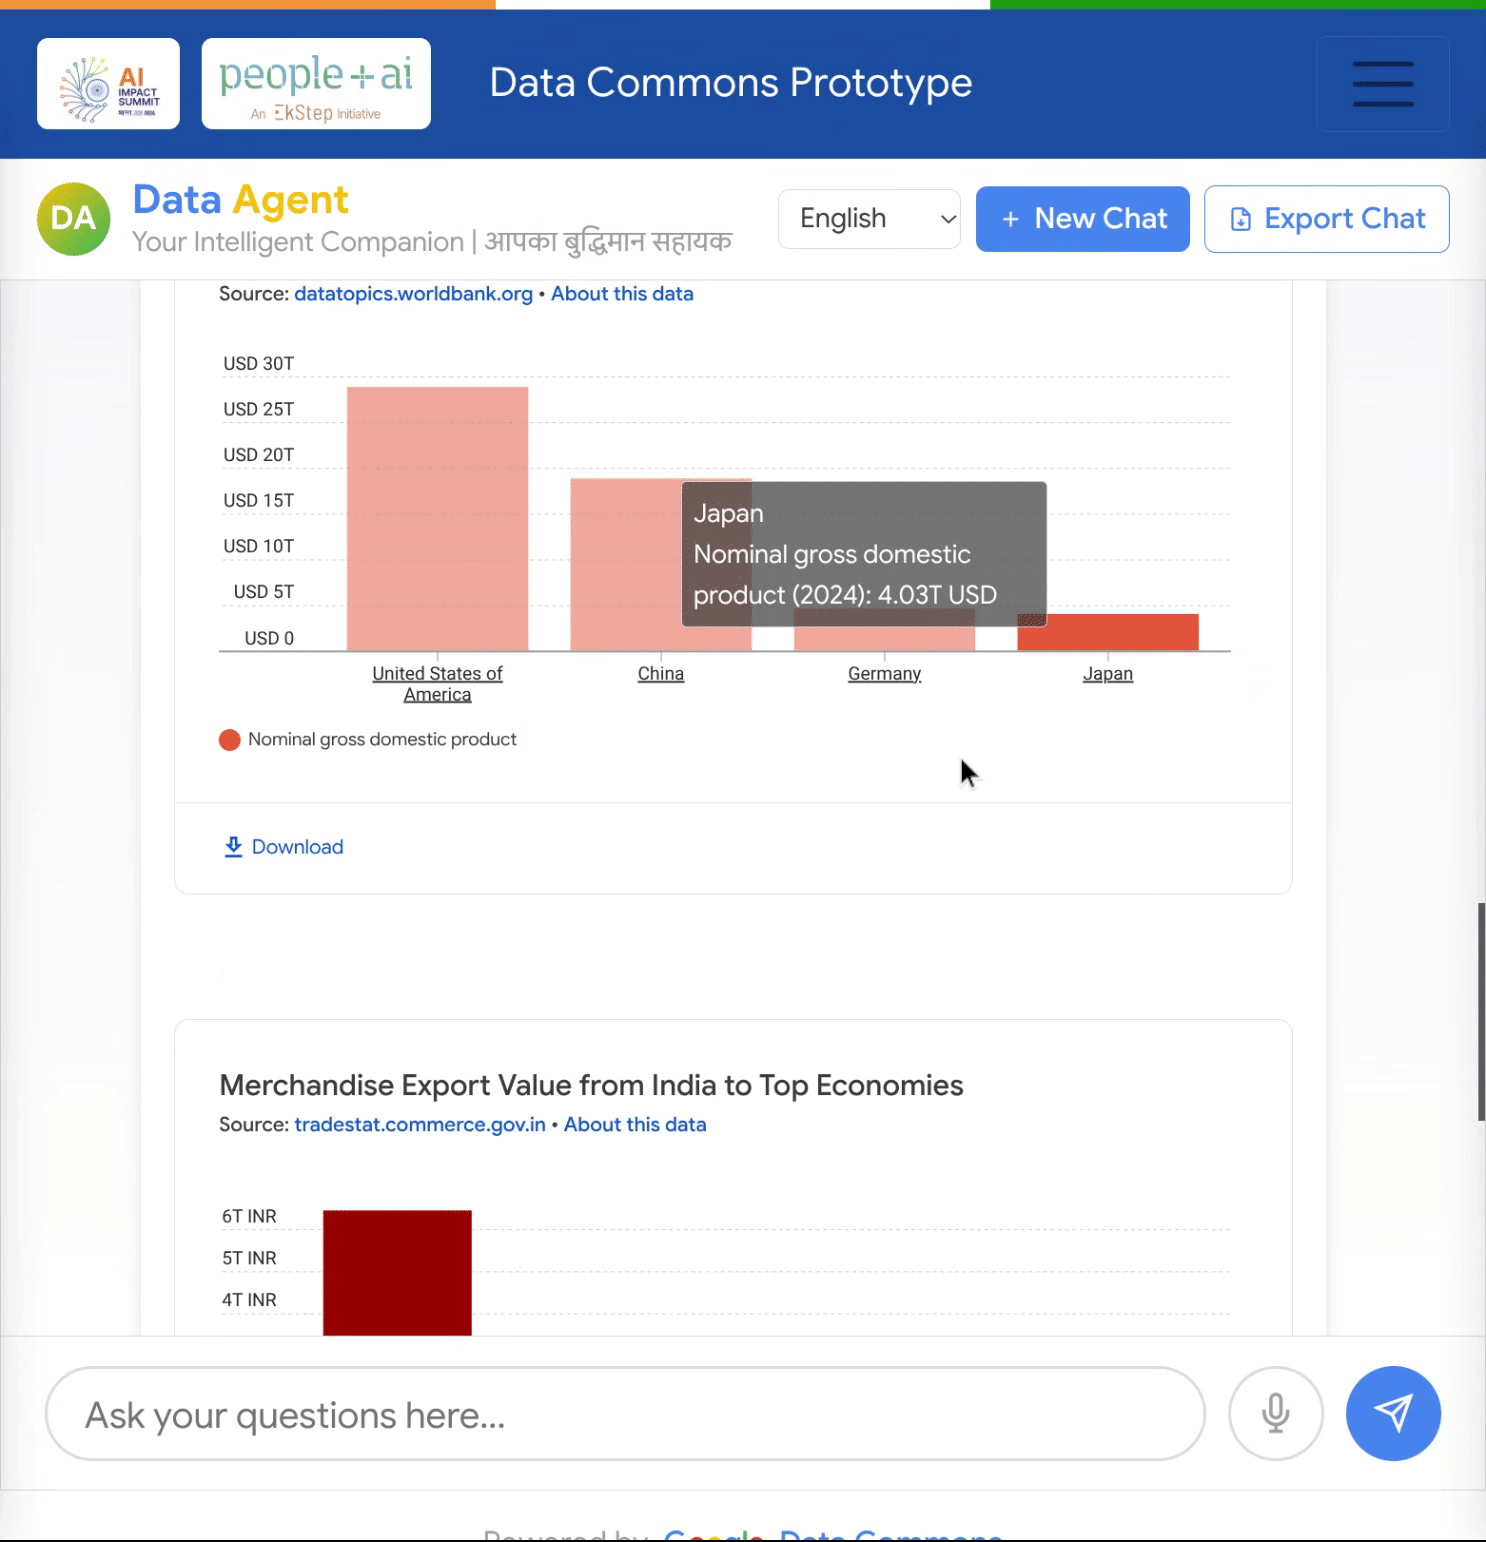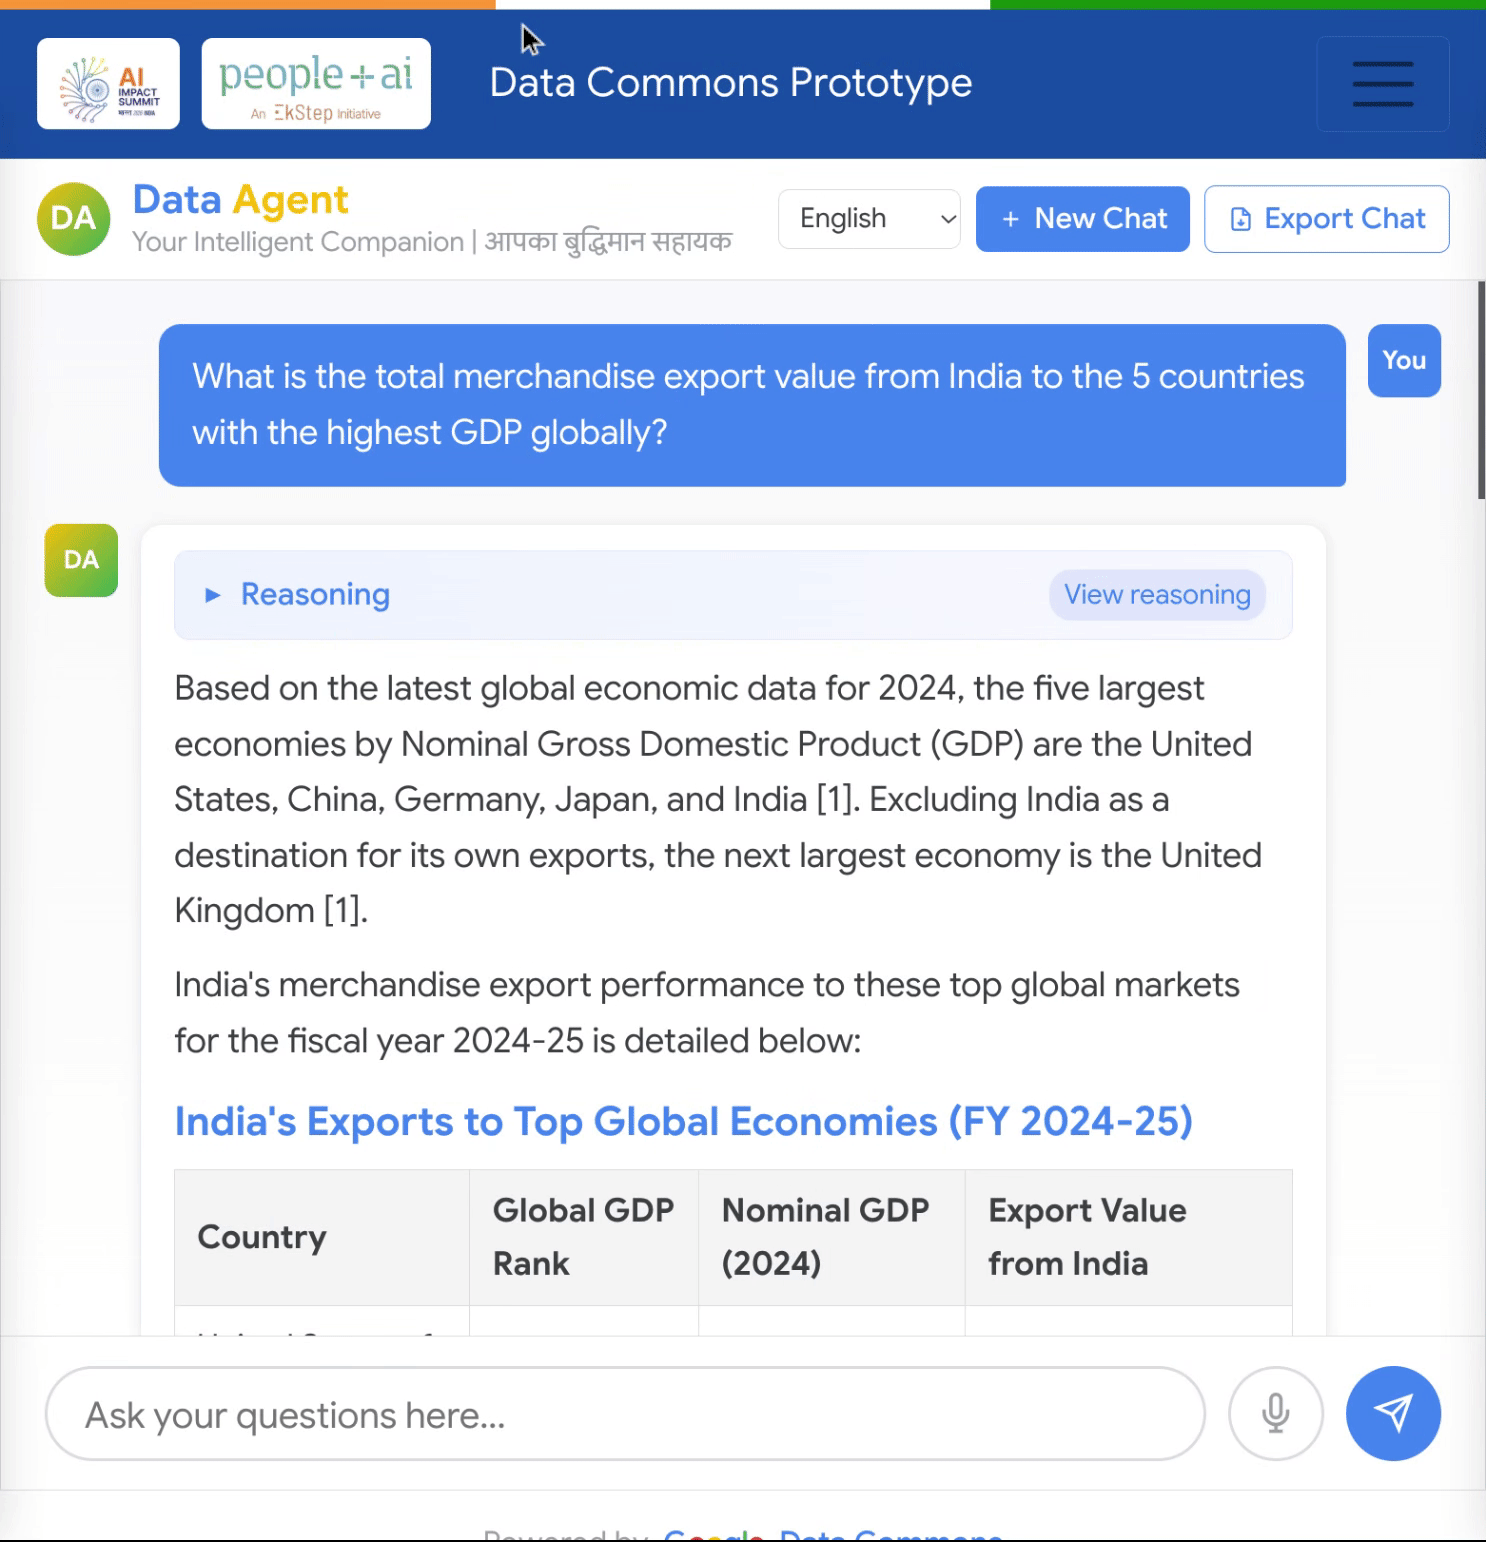
データコモンズ プラットフォームのプライベート インスタンスに保存されている商業情報統計局(DGCIS)の統計データと、Google データコモンズのパブリック インスタンスに保存されている世界銀行の世界開発指標を組み合わせた自然言語クエリの実行例。
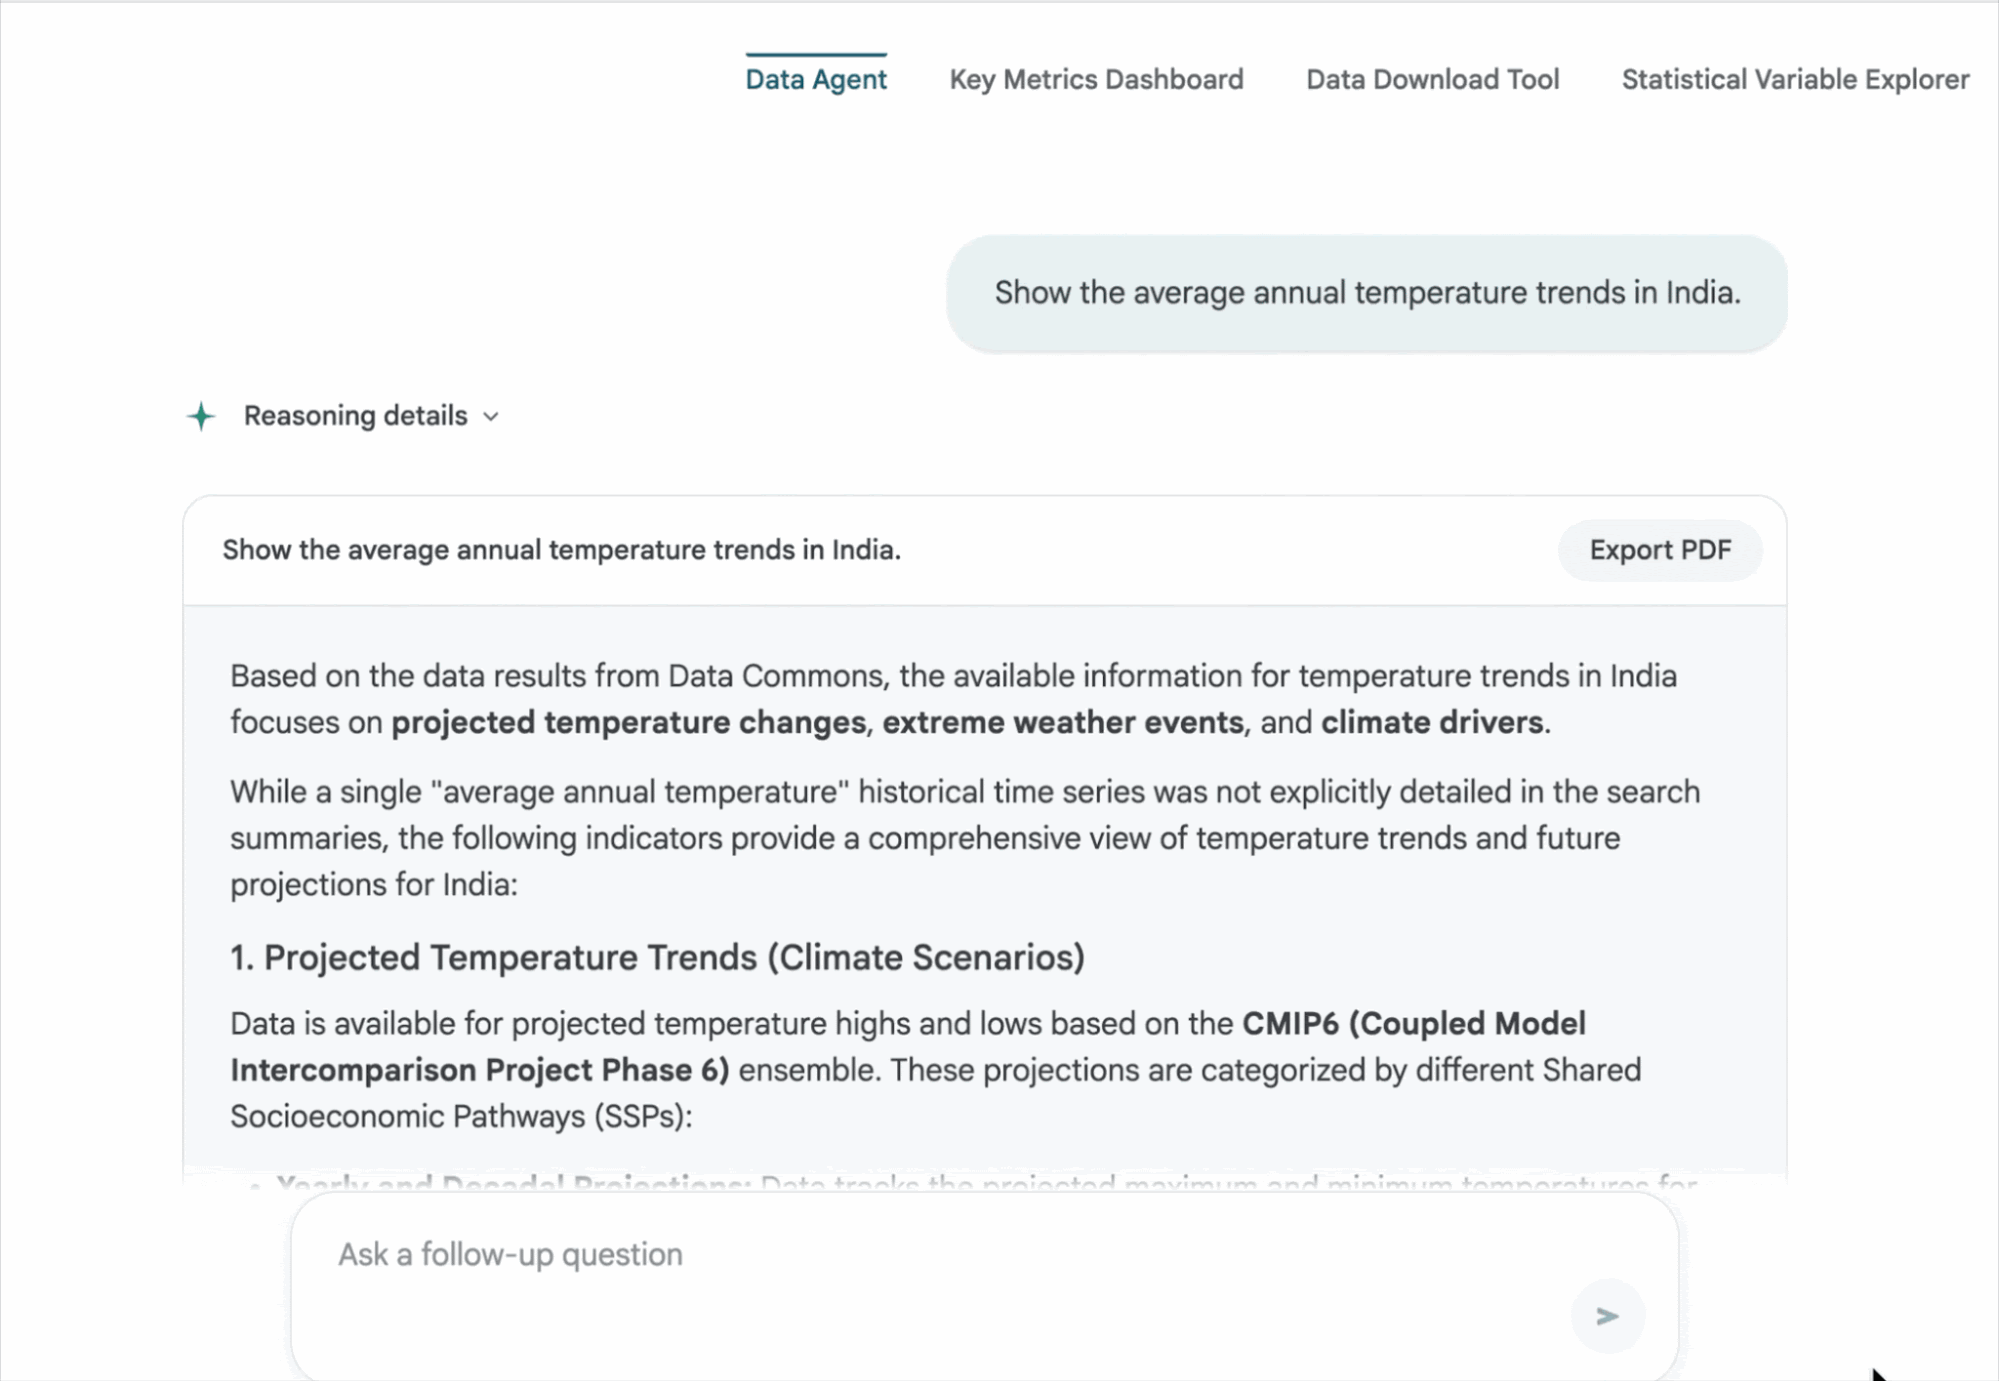
ユーザーが、国内の年平均気温の推移についてデータ エージェントに問い合わせを行っている様子。エージェントはデータコモンズから情報を取得し、過去のデータが利用可能であることを説明した上で、予測される気温変化、気候要因、CMIP6 気候モデルシナリオ(SSP)を提供し、生成されたレポートをエクスポートするオプションを提示します。
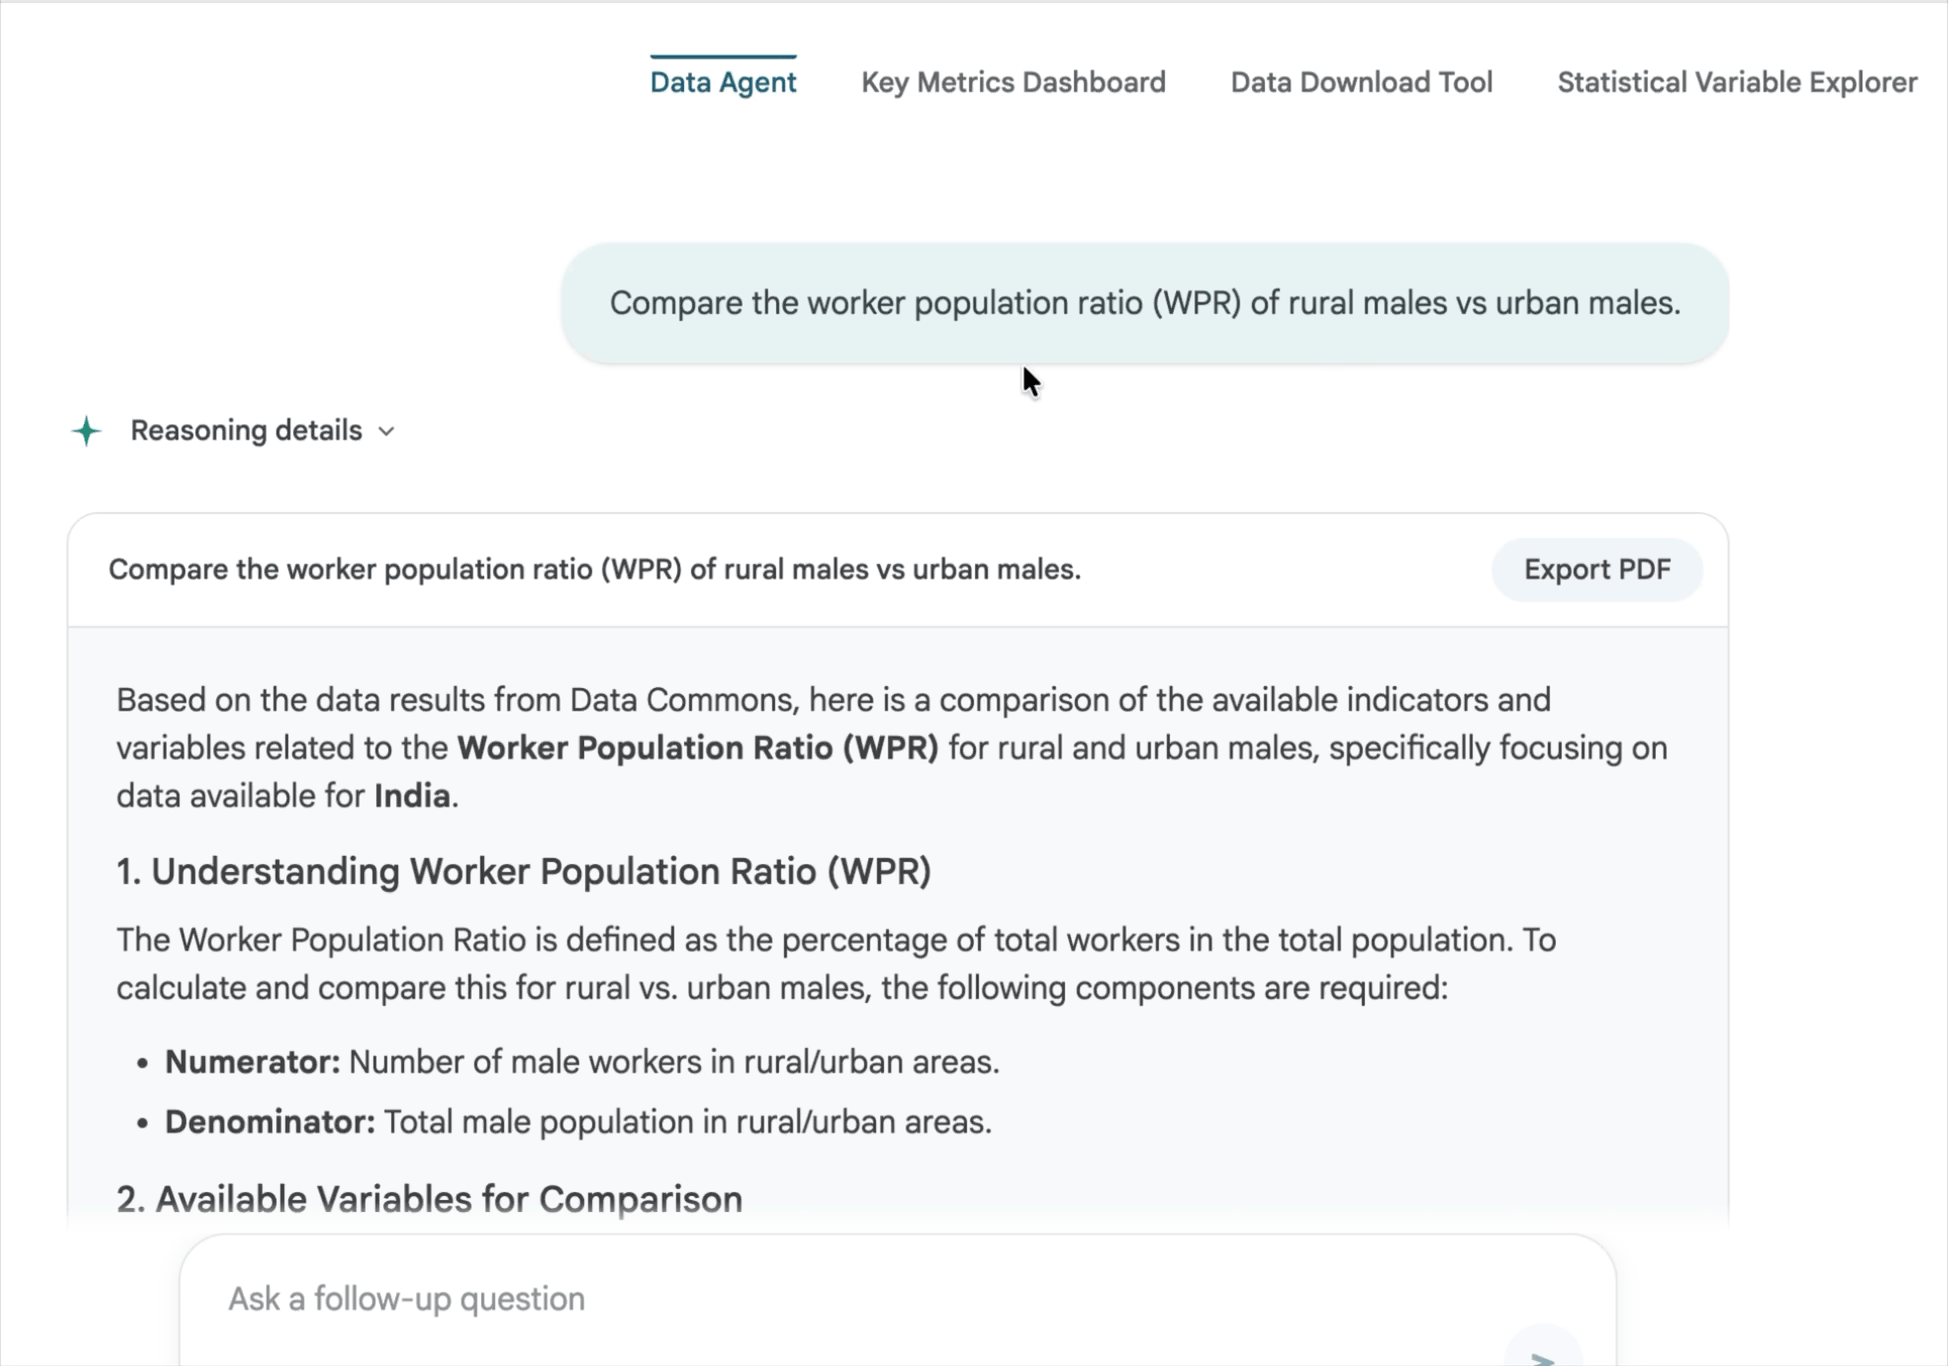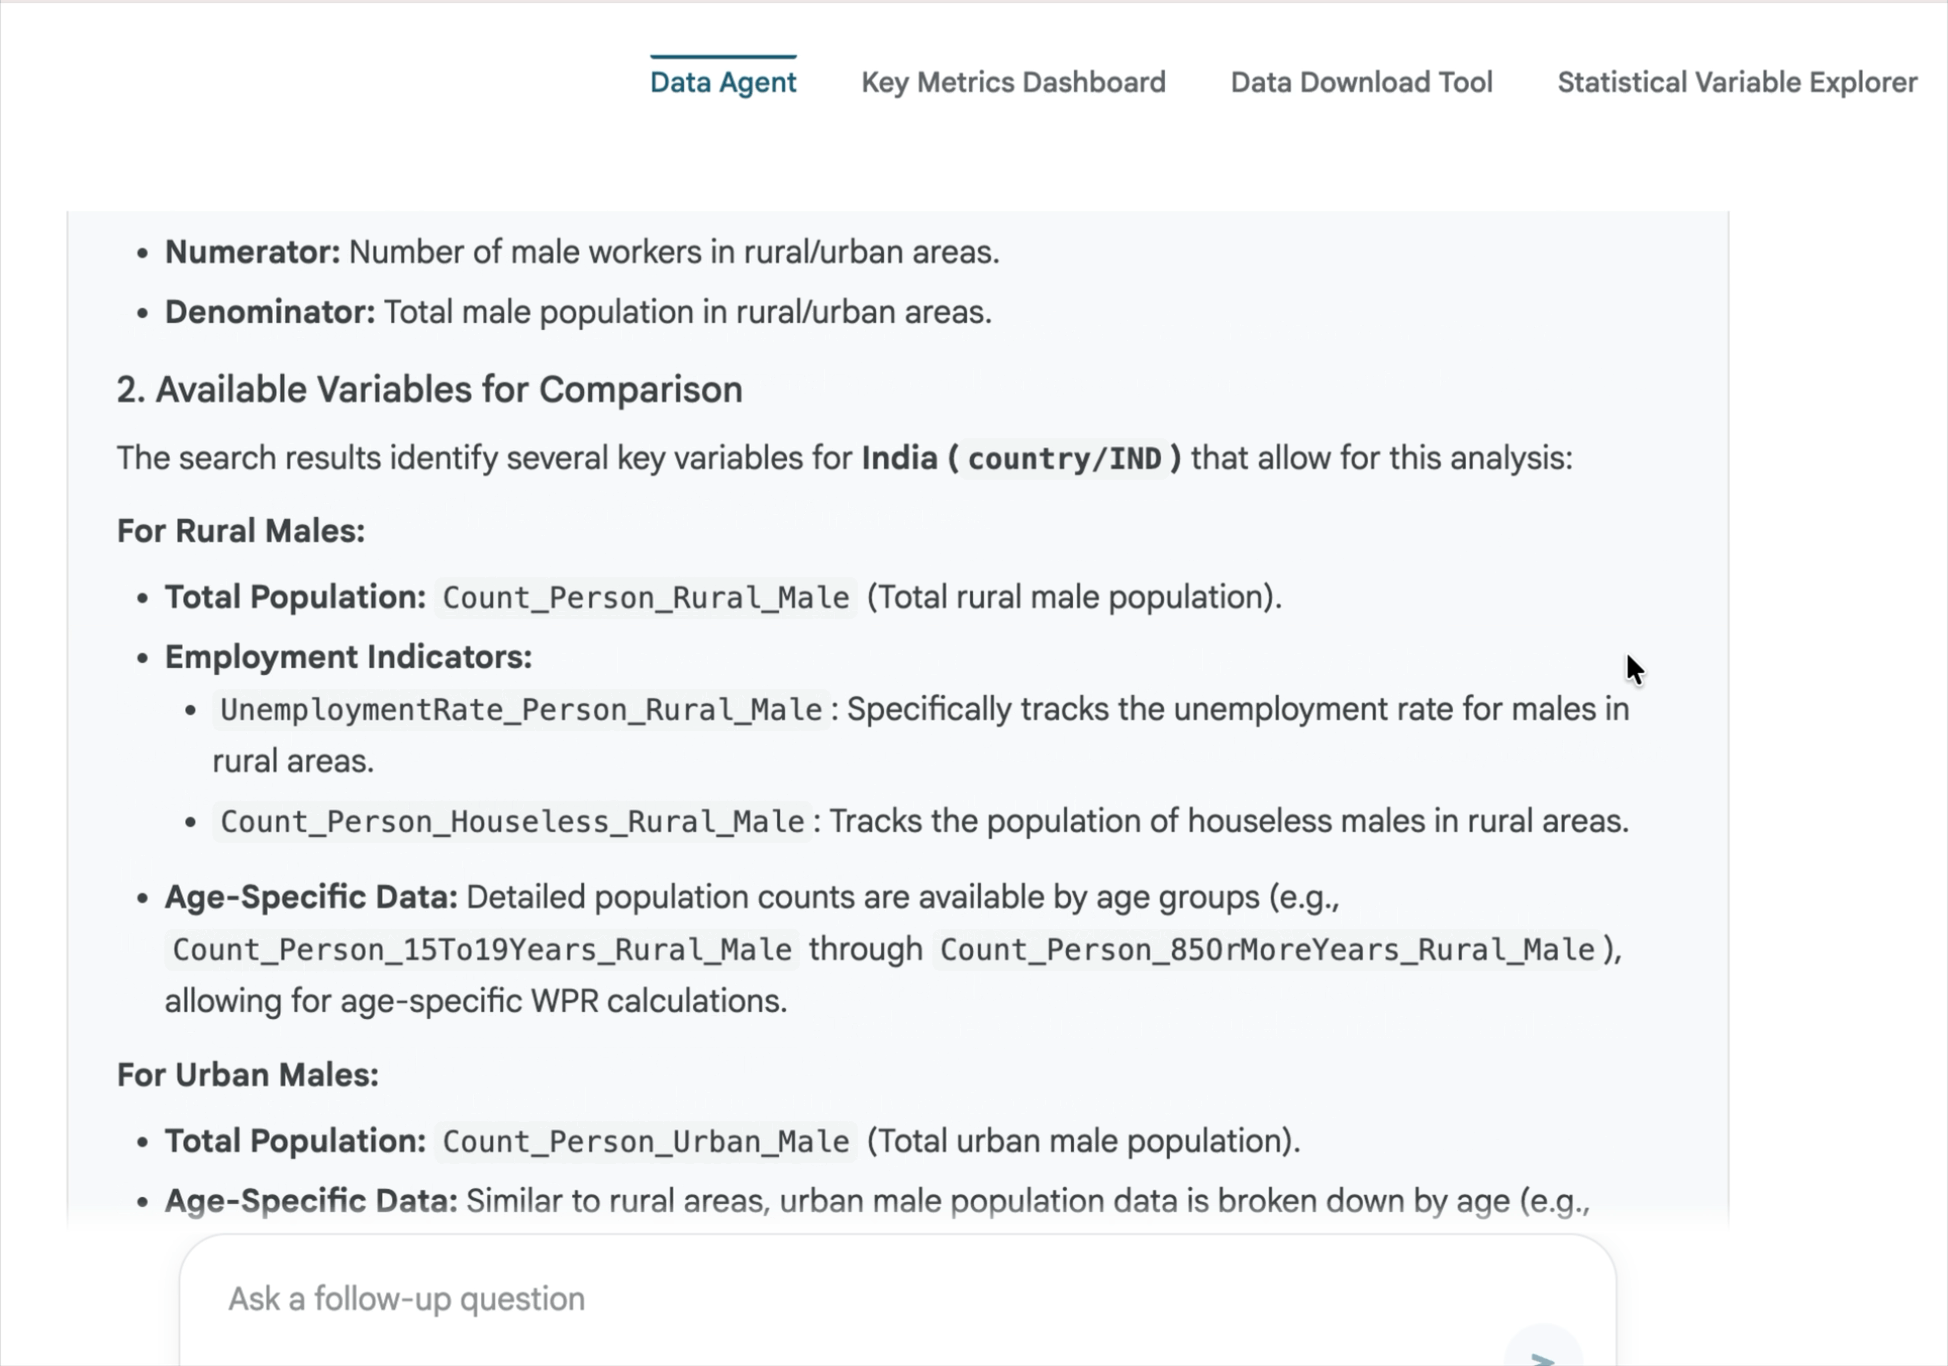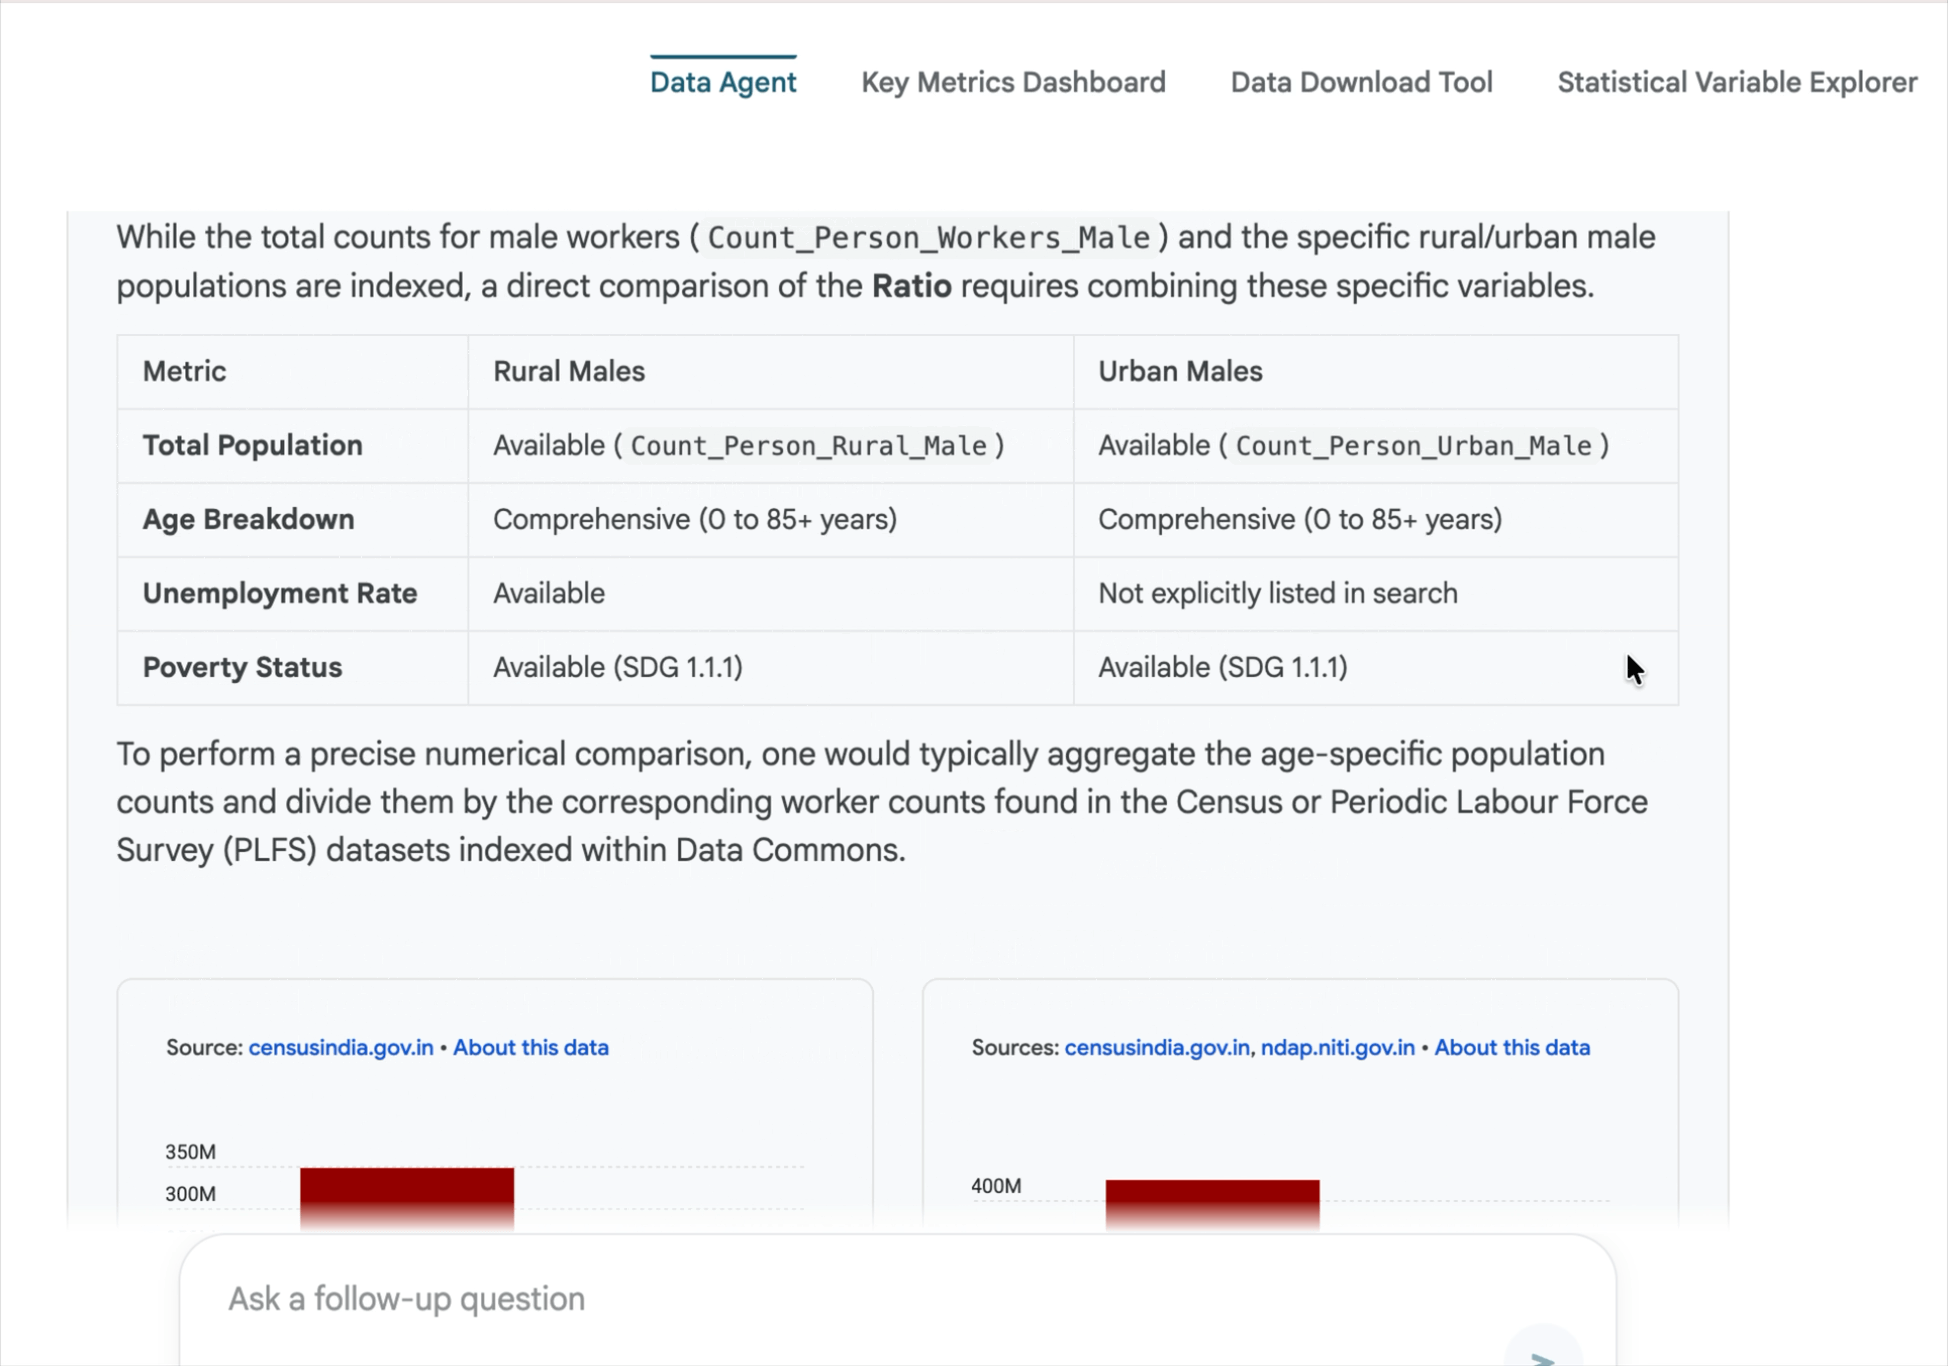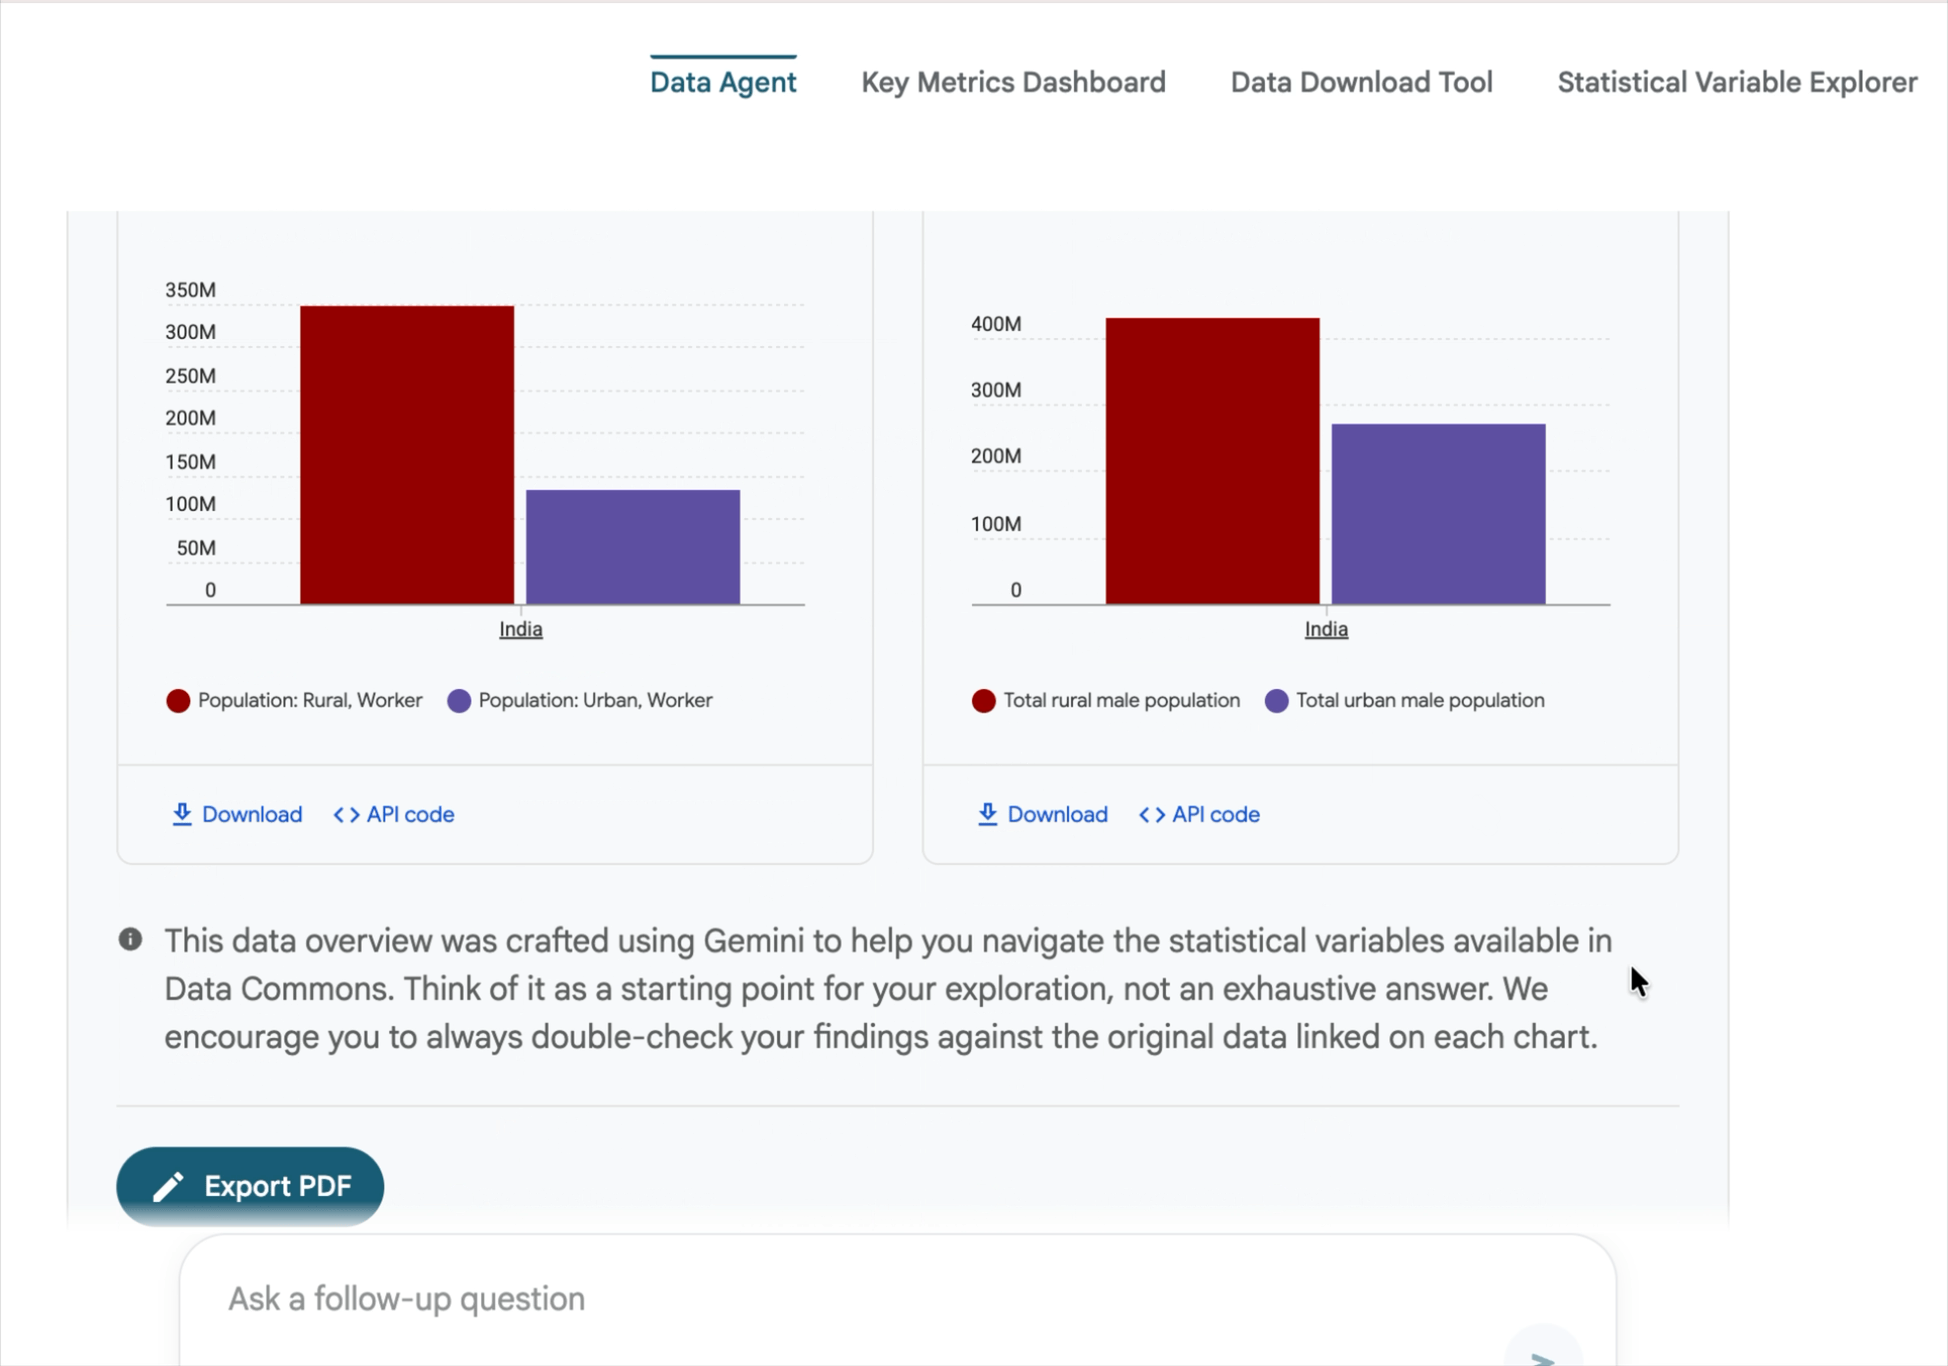
ユーザーがデータ エージェントに対し、ある国の農村部と都市部における男性の就業者人口比率(WPR)を比較するよう指示している場面。エージェントは、データコモンズからデータを取得し、WPR(総人口に対する就業者の割合)を定義して、両グループを分析および比較するために利用可能な人口統計変数の概要を示します。
早速始めましょう
-
データコモンズを探索する: datacommons.org にアクセスして、グローバルな統計知識を検索してみましょう。
-
データコモンズ プラットフォームをデプロイする: support@datacommons.org に連絡して、プレビュー アクセスをリクエストし、デベロッパー ツールをご確認ください。
- データコモンズ、シニア テクニカル プログラム マネージャー、Randeep Toor
- データベース担当グループ プロダクト マネージャー、Piyush Mathur