少ないリソースでより多くの成果を上げる: GKE でエージェントあたりの費用を 75% 削減する方法
Drake Williams
Product Manager
Steve Linde
Engineering Manager
※この投稿は米国時間 2026 年 7 月 31 日に、Google Cloud blog に投稿されたものの抄訳です。
昨今のエージェントの時代において、最新のクラウド アプリケーションは、単なる受動的なツールの集合体から、幅広いタスクにわたって推論、計画、実践する自律的なデジタル ワーカーのフリートへと進化しています。
このような環境を設計するプラットフォーム エンジニアリング チームにとって、最も簡単なアプローチは、仮想マシン(VM)上で動作する OpenClaw や Hermes などのオープンソース フレームワークにエージェントをデプロイすることです。しかし、それらのワークロードが本番環境に移行し、追加のユーザーやユースケースをサポートするためにスケールするにつれ、チームはすぐに重大な課題に直面します。AI エージェントはバースト的に動作する傾向があり、しばらくの間はリクエストを積極的に処理したりコードを実行したりしますが、その後はユーザー入力や外部トリガーを待つ間、長期間の非アクティブ状態になります。静的なコンピューティング割り当てに依存している場合、アイドル状態のエージェントであっても貴重な CPU とメモリを消費し続けます。
問題となるのは、信頼性、スケーラビリティ、効率性を損なうことなく、固定されたコンピューティング フットプリントに、いかに多くのエージェントを安全に詰め込むかということです。
その答えは、初期段階からオーケストレーションをアーキテクチャ全体の一部として組み込むことです。オーケストレーションにより、ユニット エコノミクスとスケーラビリティ、使いやすさ、信頼性を初日から大幅に向上させることができます。Google Kubernetes Engine(GKE)は、高度なオーケストレーション機能を提供します。コンピューティング能力を最大限に活用できるよう、Google は、固定の Google Compute Engine VM インスタンス(n2-standard-48)で実行される単一の GKE ノードに、パフォーマンス低下や繰り返しの障害を発生させずに搭載できる AI エージェントの最大数をテストしました。OpenClaw プロファイルを使用して、段階的な最適化を適用し、エージェント ワークロードを大規模に実行するうえでオーケストレーションが果たす重要な役割を実証しました。詳細については、以下をお読みください。

ベースライン: microVM で OpenClaw を実行する
信頼できないマルチエージェント ワークロードをセキュアに実行するには、強力な分離が必要です。一般的なアプローチとして、Kubernetes デプロイメント上の専用マイクロ VM(Kata コンテナなど)内で各エージェントを実行する方法があります。これにより、ハードウェア レベルでの強力な分離が実現します。
この方法では必要なセキュリティ境界は確保できますが、すぐにスケーリングの限界に直面します。各マイクロ VM には、メモリと CPU リソースを消費する独自のゲスト オペレーティング システムが必要であるため、実際のエージェントで使用できる実際のリソースが制限されます。このベースライン シナリオでは、標準の GKE ノードで OpenClaw エージェントが 61 個に達した時点でスケーリングの限界に達し、信頼性が低下してワークロードのヘルスチェックが定期的に失敗するようになりました。
最適化 1: GKE Agent Sandbox で密度を向上する
この問題に対処するため、同じエージェント ワークロードをマイクロ VM から GKE Agent Sandbox に移行しました。GKE Agent Sandbox は、エージェントの実行におけるセキュリティとパフォーマンスの要件に特化して設計された Kubernetes プリミティブです。
GKE Agent Sandbox は、重いゲスト オペレーティング システムに依存するのではなく、オープンソースの安全なコンテナ サンドボックスである gVisor を活用します。gVisor は、ユーザー空間カーネル(Sentry)を使用してシステムコールをインターセプトし、フィルタリングします。これにより、標準の Kubernetes コンテナの軽量なフットプリントを維持しながら、信頼できないコードの実行に対して本番環境レベルの安全な分離が提供されます。
オーバーヘッドが削減されたことでサンドボックス自体の効率が向上し、障害が発生する前に同じ VM 内に 88 個の OpenClaw エージェントをデプロイできるようになりました。これは、信頼性の高いセキュリティ境界を維持しつつ、同じ固定容量で実行できるエージェントの数が 44% 増加したことを意味します。
そのため、5 月に GKE Agent Sandbox の一般提供が開始してから、4 週間足らずで使用量が 7 倍以上に増加したのも不思議ではありません。
重要なポイント: Google のテストでは、OpenClaw タイプのエージェントを GKE Agent Sandbox に移行することで、vCPU あたりのエージェント数を 40% 以上増やし、エージェントあたりの費用を 30% 以上削減しながら、パフォーマンス プロファイルはほぼ同じ水準を維持できました。
最適化 2: オーケストレーションの価値
GKE Agent Sandbox はアクティブなワークロードを最適化しますが、アイドル状態の AI エージェントの問題を解決するには、ワークロード オーケストレーションをエージェント アーキテクチャの中心に据える必要があります。
アイドル状態のエージェントをバックグラウンドで実行し続けるのではなく、GKE Pod スナップショットを使用して永続ストレージにチェックポイント(固定)することで、物理 CPU とメモリリソースをクラスタに解放できます。新しいタスクトリガーが到着すると、軽量の Kubernetes コントローラまたはイベント ゲートウェイがリクエストをインターセプトし、スナップショットからエージェントを再開するよう GKE にシグナルを送信します。この処理はミリ秒単位で行われます。
このパターンにより、ワークロードの動作に基づいて物理的なコンピューティング リソースを確実にオーバーサブスクライブできるため、同じノードにより多くのエージェントを配置できます。ただし、オーバーサブスクリプションは万能なアプローチではなく、いくつかのトレードオフが伴います。AI エージェントごとにレイテンシ要件と実行モデルが異なるためです。すべてのエージェントを同じように扱うと、レイテンシによってユーザー エクスペリエンスが低下するか、VM のオーバープロビジョニングによってプロジェクトが破綻することになります。
GKE を使用すると、さまざまなタイプのエージェントやユースケースに合わせてカスタマイズされたデプロイをサポートするエージェント プラットフォームを運用できます。各デプロイは、独自のパフォーマンスと費用の要件に合わせてファインチューニングされます。
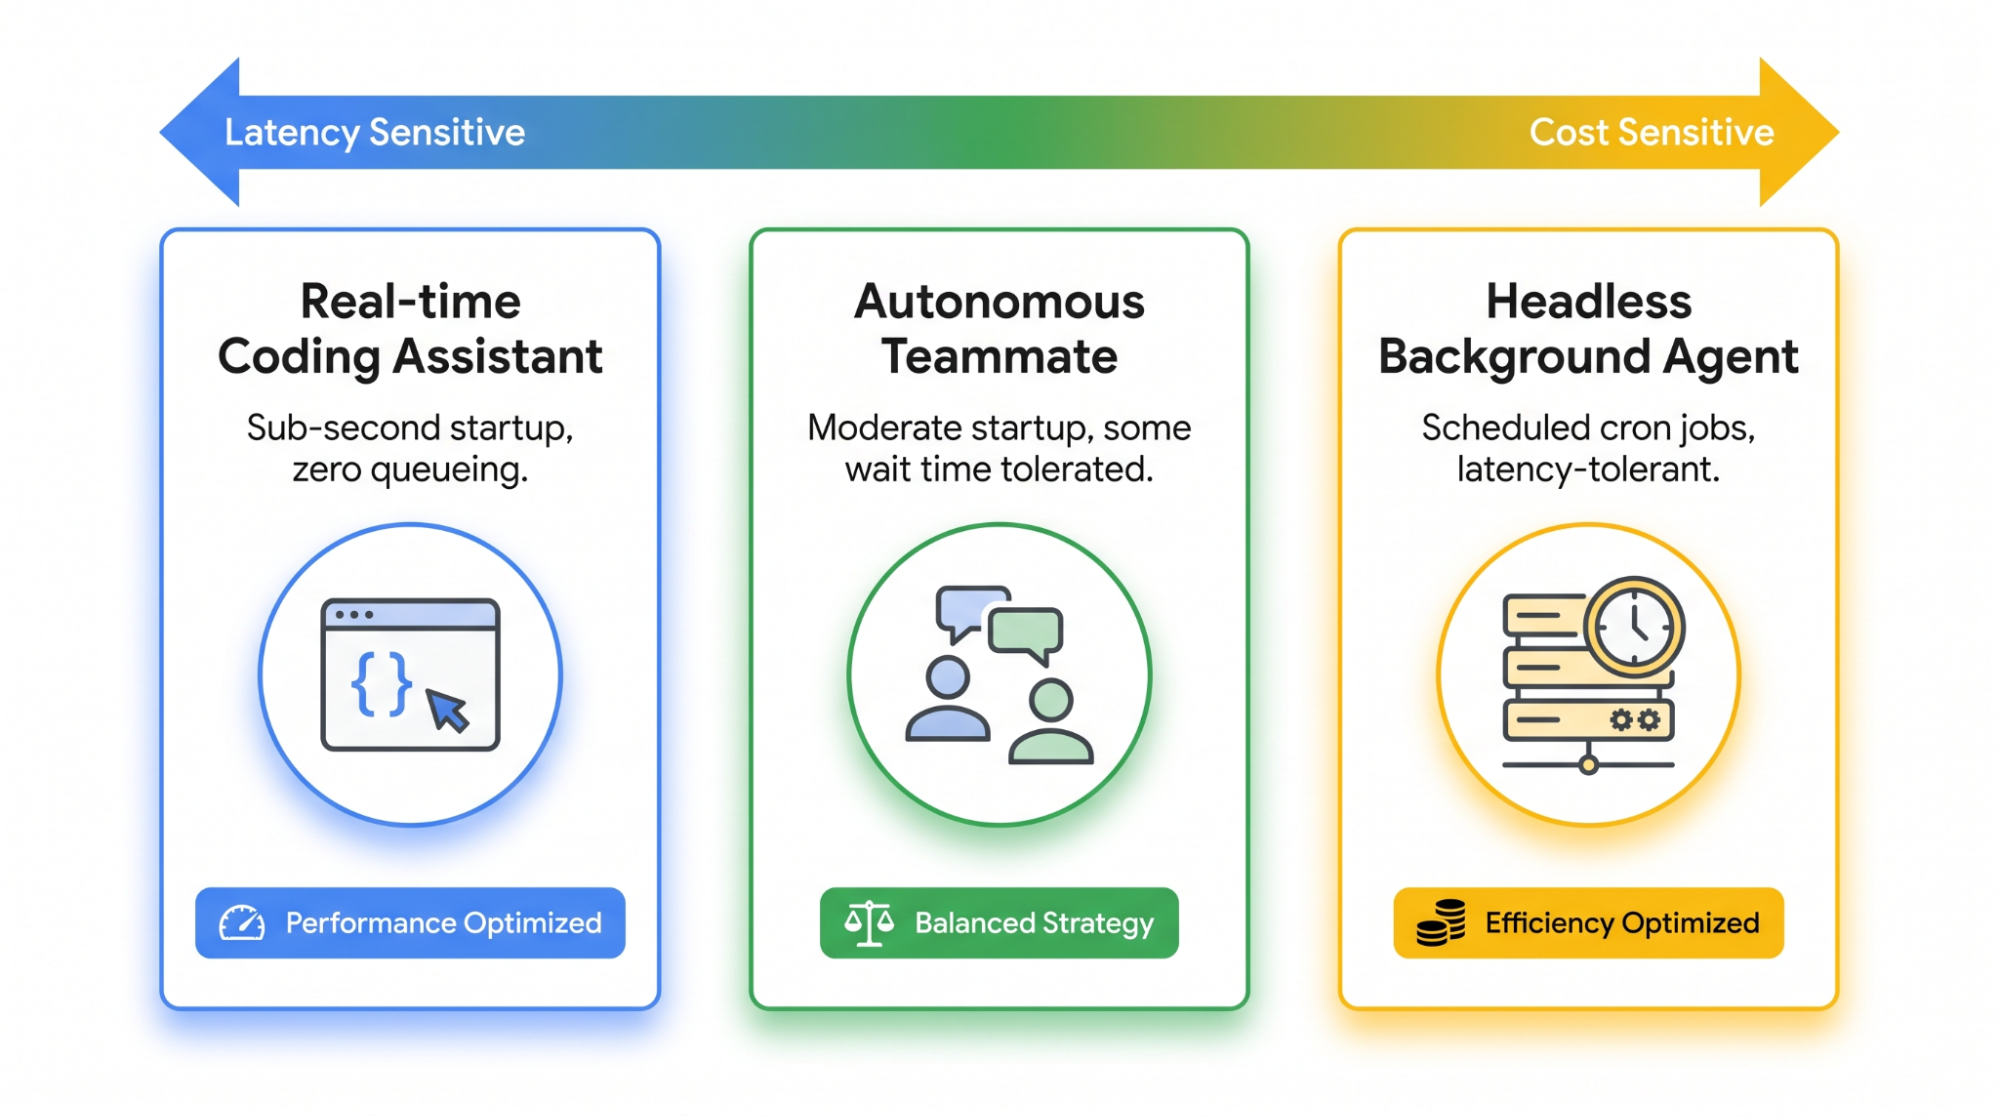
GKE は、レイテンシの感度とリソース密度のバランスを取りながら、エージェント ワークロードのさまざまな動作をサポートします。
以下に、パフォーマンス要件が大きく異なるエージェント ワークロードの例を紹介します。
-
リアルタイムのコーディング アシスタント(レイテンシの影響を受けやすい): 開発者向けの直接エージェントには、1 秒未満の起動時間(1 秒未満)が求められ、キューイングは一切許容されません。GKE は、GKE Pod スナップショットと Agent Sandbox ウォームプールを組み合わせることで、ほぼ瞬時に実行できる、ウォームアップ済みの分離されたサンドボックスを維持します。
-
自律型チームメイト (バランス型): インタラクティブなバックグラウンド エージェントは、平均的な起動時間(数秒)を許容できます。GKE の一時停止と再開の機能により、これらのエージェントはオンデマンドで復元されるため、アイドル状態の間にコンピューティング リソースを消費することはありません。
-
ヘッドレス バックグラウンド エージェント(レイテンシ許容型): 毎日スケジュール設定される調査や分析の cron ジョブは、キューの遅延を許容できます。クラスタ容量が利用可能になるまで 1 時間待ってこれらのジョブを実行しても、ビジネスの成果が損なわれることはありません。このようなエージェントのコストを抑えるには、最大のリソース オーバーサブスクリプションを使用します。
つまり、GKE では、クラスタ全体で単一の戦略を強制するのではなく、ノードプールとワークロード構成全体で異なる動作を同時にサポートできます。
「Thundering Herd」問題、つまり、エージェントが一斉に起動し、同時にコンピューティングを要求する状況を想定してください。GKE では、Agent Sandbox ウォームプールや一時停止と再開などの機能を使用して、特定の要件(パフォーマンス重視かコスト重視か)に基づいて、コスト削減の可能性とパフォーマンス保証とのバランスをチューニングできるようになっています。
-
パフォーマンス重視: 大規模で突発的なトラフィックの急増時にも、1 秒未満のパフォーマンスを保証する必要があるユースケースの場合は、Agent Sandbox のウォームプールを使用してバッファをプロビジョニングできます。この構成では、同じノードで 133 個の OpenClaw エージェントを実行できました。
-
コスト重視: レイテンシを許容できるワークロードや、段階的に実行できるワークロードでは、オーバースクリプション率を高くすることでノード密度を大幅に高めることができます。この構成では、起動時間を 5 秒未満に抑えながら、同じノードで 274 個のエージェント(ベースラインの 3 倍以上)を実行できました。
重要なポイント: GKE Agent Sandbox と GKE の一時停止および再開機能を組み合わせることで、アイドル状態のエージェントを固定し、固定のコンピューティング容量をオーバーサブスクライブできます。アクティビティが断続的に発生するエージェントの場合、エージェント密度が最大 3.5 倍になり、エージェントあたりのコストが最大 75% 削減されます。
予算を増やさずにエージェントをスケールさせる
エージェントをスケールしても、インフラストラクチャの予算を比例してスケールする必要はありません。例が示すように、適切なプラットフォーム機能を採用し、最初からオーケストレーションを考慮することで、コンピューティング容量から得られる価値を劇的に変えることができます。GKE を使用すると、積極的なコスト削減を優先する場合でも、パフォーマンスを最適化する場合でも、インフラストラクチャをビジネス目標に容易に合わせることができます。
そして、これはまだ始まりにすぎません。Google Cloud は、エージェントの時代の要求に対応できるよう、常に新しいイノベーションを推進しています。コンピューティング容量をさらに有効活用する準備はできていますか?GKE Agent Sandbox に関するドキュメントで、GKE がチームのイノベーションをより迅速かつ低コストで実現するのにどのように役立つかをご覧ください。
- プロダクト マネージャー、Drake Williams
- エンジニアリング マネージャー、Steven Linde