GKE の弾力性がさらに向上: ゼロへのスケーリング、費用削減、ワークロードの応答性維持
Eyal Yablonka
Product Manager, Google Kubernetes Engine
Scott Funkenhauser
Senior Software Engineer, Google Kubernetes Engine
※この投稿は米国時間 2026 年 9 月 24 日に、Google Cloud blog に投稿されたものの抄訳です。
真の弾力性は、クラウドネイティブ エンジニアリングの究極の目標として長年追求されてきました。Kubernetes はリソース管理に革命をもたらしましたが、散発的に実行されるワークロード(バッチ プロセッサ、イベント ドリブン ワーカー、開発環境など)は、処理を待機している間もコンピューティング リソースを消費するため、費用の増加を招きます。
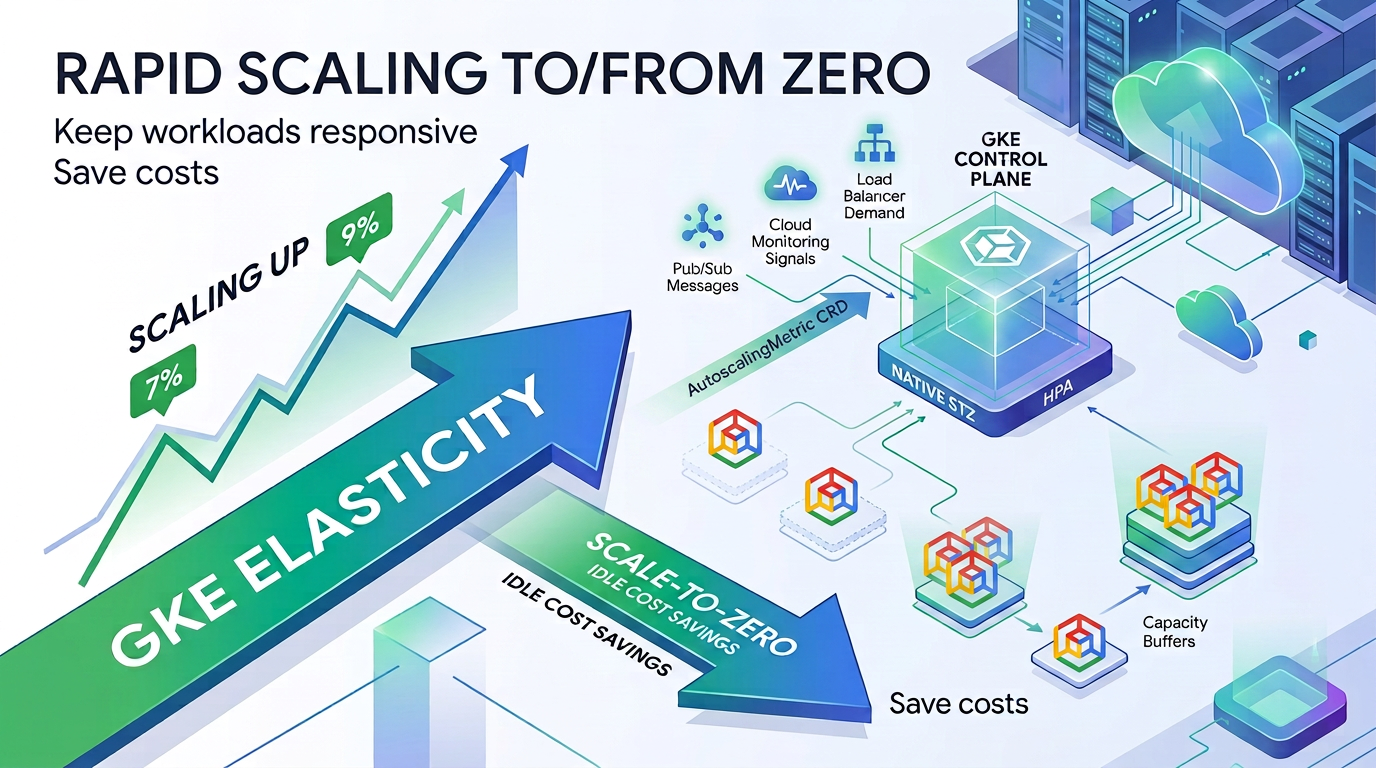
Google Kubernetes Engine(GKE)1.37 では、ゼロへのスケールダウンとゼロからのスケールアップをネイティブに実現することで、この問題に正面から取り組んでいます。新しい一連の機能を使用すると、ワークロードを完全にゼロレプリカにスケールダウンして、リソースの消費を停止できます。同時に、需要が戻ったときには、GKE のキャパシティ バッファでこれらのワークロードを迅速かつ簡単に再起動できるため、インフラストラクチャの無駄を減らすことができます。これは単に費用を削減するだけでなく、常時稼働のインフラストラクチャの費用をワークロードの準備状況から切り離すことにもつながります。
進化: HPA ベースのゼロへのスケーリングと KEDA
長年にわたり、Kubernetes Event-Driven Autoscaling(KEDA)というオプションの Kubernetes コンポーネントが、ゼロへのスケーリングの定番ソリューションでした。KEDA は強力ですが、環境が複雑になります。
ゼロへのスケーリングを GKE コントロール プレーンに直接組み込むことで、アドオン オペレーターや数千行の構成が不要になります。ロジックは「サイドカー管理」からワークロードのネイティブ属性に移行します。
仕組み: AutoscalingMetric と KEP-2021 を使用した HPA
GKE 内でゼロにスケールする鍵は、2 つの重要なコンポーネントの統合にあります。
-
AutoscalingMetric を使用した HPA: これは、Google Cloud Managed Service for Prometheus からの外部シグナルの直接読み取りをサポートするマネージド指標シグナル パイプラインです。AutoscalingMetric を使用した HorizontalPodAutoscaler(HPA)は、Pub/Sub、Cloud Monitoring、ロードバランサのシグナルからオートスケーラーに指標を送信するための、統合された高パフォーマンスのパスを提供します。アダプターの煩雑さを伴わずに済みます。
-
KEP-2021: HPA で
minReplicas: 0 を可能にするKubernetes Enhancement Proposalに基づいて構築されたこのメカニズムにより、指標がしきい値を下回ると、HPA はすべての Pod を停止できます。また、指標が保留中の作業を示したらすぐに、HPA が Deployment を「起動」できるようにします。
最初の「ゼロへのスケーリング」ワークロードの構成
ネイティブなゼロへのスケーリングを実装するには、指標定義と HPA という 2 つの主要なオブジェクトが必要です。次の例では、Pub/Sub サブスクリプションの未配信メッセージ数に基づいてワーカーをスケーリングします。
指標のソースを定義する
AutoscalingMetric CRD を使用して、外部の Cloud Monitoring 指標をクラスタにマッピングします。
minReplicas: 0 を使用して HPA を構成する
HPA で指標を参照し、最小レプリカ数を明示的にゼロに設定します。
これで、外部指標に基づいてワークロードをゼロにスケールダウンしたり、ゼロからスケールアップしたりできるようになりました。
ゼロへのスケーリング機能は、Cloud Monitoring からの外部指標を GKE でサポートすることで実現しています。AutoscalingMetric カスタム リソースを拡張することで、複雑なサードパーティ アダプタを使用せずに、Google Managed Service for Prometheus から指標をクエリできるようになりました。これにより、レイテンシが短縮され、セキュリティが簡素化されます。また、ネイティブな「ゼロへのスケーリング」ワークロードを構成するための重要な基盤となります。このインテグレーションについて詳しくは、GKE での外部指標のネイティブ サポートに関するブログ投稿をご覧ください。
キャパシティ バッファによる起動レイテンシの管理
ゼロからのスケーリングにおける最大の課題は、いわゆるコールド スタートです。これは、GKE がノードをプロビジョニングし、コンテナがそれを pull して起動するまでにかかる時間です。そこで役立つのが GKE キャパシティ バッファです。
キャパシティ バッファは、プールされたウォーム状態のキャパシティとして機能します。GKE は、ゼロにスケールできる複数のワークロードで共有できる少量のウォーム コンピューティング リソースを維持することで、HPA が 0 から 1 にジャンプしたときに、Pod がすぐに要求できるリソースを確保します。これにより、新しい GKE ノードがスピンアップするまでの 60~90 秒の待ち時間がなくなり、起動レイテンシが数分から瞬時に短縮されます。その間、ワークロードの費用はゼロに抑えられます。
キャパシティ バッファには、アクティブとスタンバイの 2 種類があります。小さなアクティブ バッファは、ゼロにスケールされた数百のワークロードに対応できます。各ワークロードがレプリカを維持するのではなく、アクティブ バッファがクラスタ全体にサービスを提供するワイルドカード キャパシティとして機能します。スタンバイ バッファはアクティブ バッファに比べて大幅に低コストで、サイズが大きくなるため、クラスタで持続的な負荷が発生した場合にアクティブ バッファを迅速に補充できます。これらを併用することで、即時のスケーリングを実現しながら、低コストも維持できます。
今後について
Google は、GKE の弾力性に関するロードマップを継続的に拡大しています。たとえば、開発環境を午後 8 時にゼロにスケールダウンし、午前 7 時にスケールアップするとします。繰り返し発生するスケーリングをより細かく制御する方法に注目し、ゼロへのスケーリングの時間枠を事前に定義できるようにしましょう。
ゼロへのスケーリングを今すぐ始めましょう
アイドル状態のリソースに料金を支払う時代は終わりを迎えようとしています。イベント ドリブンなワークロードや散発的なワークロードに対して GKE のネイティブなゼロへのスケール機能を有効にすることで、起動パフォーマンスを犠牲にすることなく費用を削減できます。ゼロへのスケールを開始するには、次の手順を行います。
-
アイドル期間を伴う、需要が変動するワークロードを特定します。
-
AutoscalingMetric を構成し、minReplicas をゼロに設定します。
-
クラスタまたはワークロードにキャパシティ バッファを追加して、応答時間を短縮します。
詳細は、HPA を使用した GKE ワークロードのゼロへのスケールダウンとゼロからのスケールアップに関するドキュメントをご覧ください。
- Google Kubernetes Engine、プロダクト マネージャー、Eyal Yablonka
- Google Kubernetes Engine、シニア ソフトウェア エンジニア、Scott Funkenhauser