SOAP Architecture: S3 に眠るデータを、Google Cloud で AI エージェントの基盤に変える
Google Cloud Japan Team
利用している主なサービス・ソリューション
- Products Used: BigQuery, Looker / LookML, Knowledge Catalog, BigQuery Graph, Cross-Cloud Interconnect, Gemini Enterprise
- Solutions Used: Borderless Lakehouse, Data Analytics & AI Platform
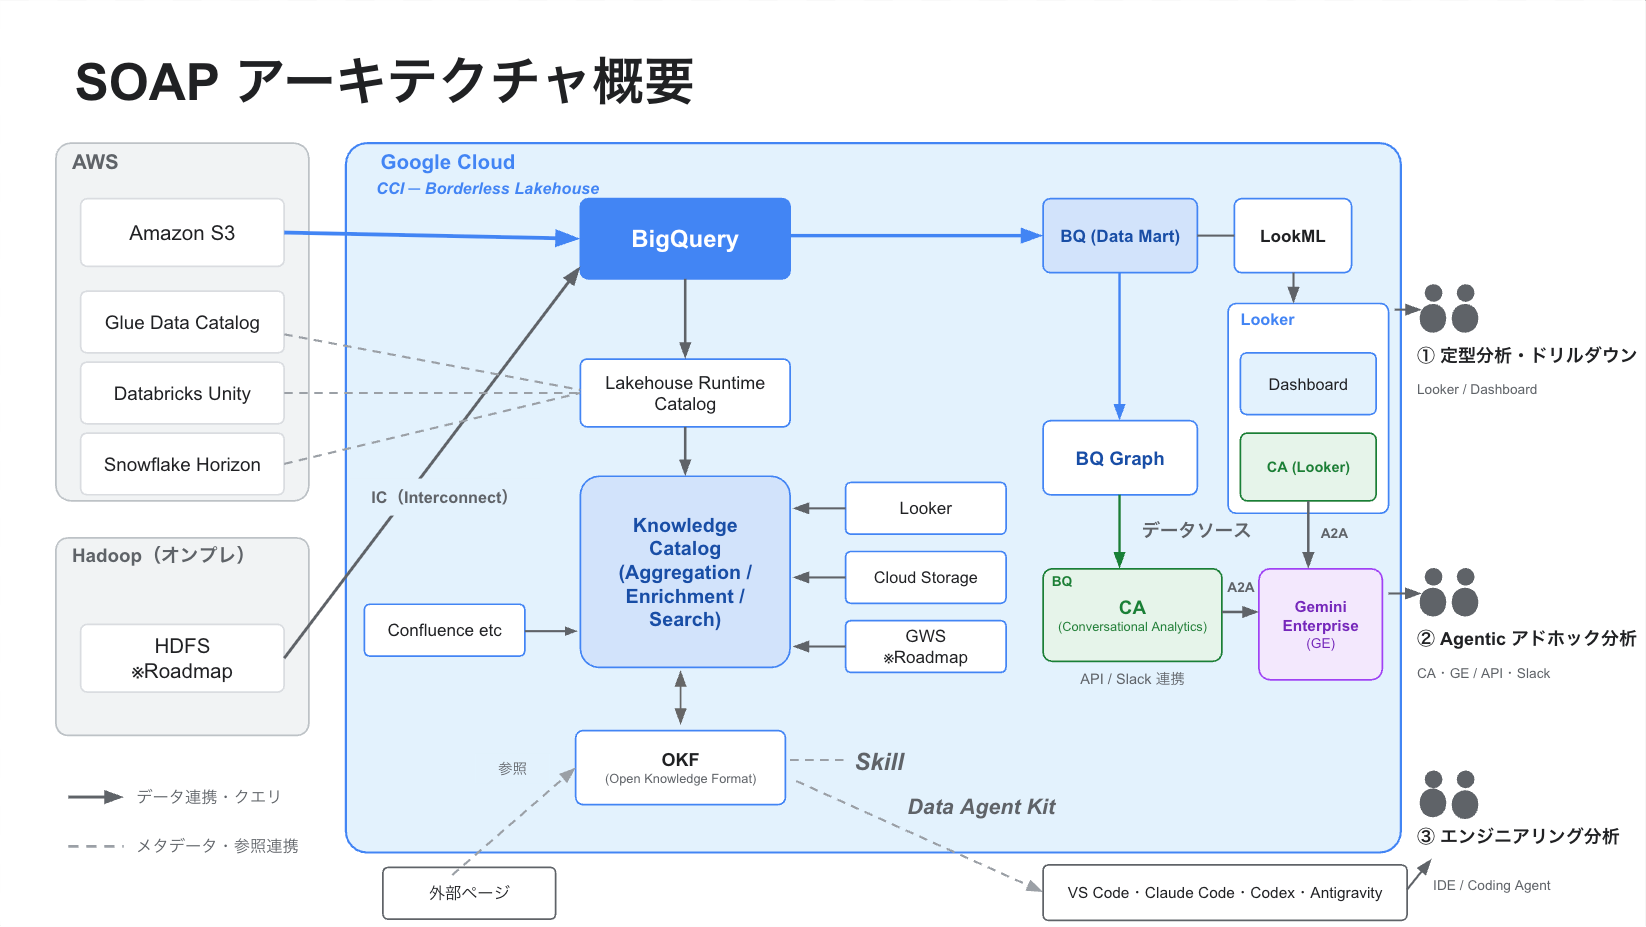
SOAP の考え方はシンプルです。
- つなぐ - データは AWS 等に置いたまま、BigQuery から直接分析します。
- 意味を与える - LookML、BigQuery Graph、Knowledge Catalog、Open Knowledge Format がデータに文脈を与えます。
- 働かせる - Conversational Analytics と Gemini Enterprise が、その意味を理解して動きます。
大規模なデータ移行プロジェクトは、前提ではありません。
データは動かさない: Borderless Lakehouse で「いま在る場所」につなぐ
SOAP の土台は Borderless Lakehouse です。 S3 上の Apache Iceberg テーブルは、Cross-Cloud Interconnect とキャッシュ(プレビュー版)を通じて BigQuery から直接クエリでき(Cross-Cloud Interconnect を導入していない環境でも、インターネット経由での接続が可能です)、AWS Glue Data Catalog / Databricks Unity Catalog / Snowflake Horizon のメタデータは、カタログ フェデレーション(プレビュー版)で Lakehouse のランタイム カタログと自動的に同期されます。 ETL パイプラインを組む前に、まず「つながる」のです。 ( Iceberg 形式のファイルでない場合は Cross-Cloud Connections で直接参照可能です)
このアプローチは、次のメリットをもたらします。
- ゼロコピーのクロスクラウド分析: ファイルを複製することなく、S3 のデータをその場で分析できます。 分析のために「まずコピー」する運用から解放されます。
- 「クラウド間の税金」の解消: 外向きデータ転送料はかかりません。(相互接続サービスの時間単位の料金はかかります) 従量の egress 課金に怯えることなく、クロスクラウド分析を定額で計画できます。 (Partner Cross-Cloud Interconnectを使用した場合)
- 初日からの価値: 接続したその日から、使い慣れた SQL でレガシー データに問い合わせできます。 移行の完了を待つ必要はありません。
AI の信頼性は、モデルではなく「意味の層」で決まる
SOAP の名前の中核である Semantic and Ontology は、このアーキテクチャの最も重要な主張を表しています。エージェントの回答品質を決めるのは、モデルの選定ではなく、データに与えられた意味と関係の質だということです。
ここで言うオントロジーとは、業務上の実体 (顧客・注文・商品…) と、その関係と意味を、AI が直接読める形で表現した知識の構造のことです。メタデータが「何があるか」の目録なら、オントロジーは「何を意味し、どう繋がるか」の地図です。
セマンティック レイヤを担うのは LookML です。 指標やディメンションの定義を一元管理し、ダッシュボードと AI が同じ「言葉の定義」を共有します。 オントロジーを担うのは BigQuery Graph、Knowledge Catalog、そして Open Knowledge Format (OKF) です。 テーブル間の関係をグラフとして明示すれば、エージェントが結合方法を推測する余地がなくなり、ハルシネーションの入り口を塞げます。
この層は、次の 3 つの要素で構成されます。
- セマンティック レイヤ(LookML): 「売上」「アクティブ顧客」の定義を一箇所に。 BI と AI の回答が食い違う問題を根本から解決します。
- ナレッジ グラフ(BigQuery Graph): 顧客、注文、商品といった実体の関係をプロパティ グラフとして定義し、ISO 標準の GQL で問い合わせます。 グラフはそのままエージェントのデータソースになります。
- オントロジーの「共通語」(OKF + Knowledge Catalog): Knowledge Catalog が社内 Wiki のようなページも参照しながら、テーブルの意味、指標の背景、運用のナレッジを OKF (Markdown のバンドル) として生成します。生成した OKF は Git で管理し、エージェントへは Knowledge Catalog が供給します。散在していた組織のナレッジが、AI の資産に変わります。
3 つの入口、1 つの基盤: エージェントが「使う」
意味の層が整うと、その上で複数の利用スタイルが同じガバナンスのもとに成立します。 SOAP では、利用者を 3 つのペルソナで捉えます。
- 定型分析とドリルダウン: Looker のダッシュボードが LookML に接地した指標を提供します。Looker の Conversational Analytics は最大 5 つの Explore を束ね、質問ごとに適切な Explore へルーティングします。
- Agentic なアドホック分析: BigQuery の Conversational Analytics が、BigQuery Graph をデータソースとして自然言語の質問に答えます。 エージェントは A2A(Agent2Agent)プロトコルで Gemini Enterprise に公開され、ビジネス ユーザーは Slack や社内ポータルから話しかけるだけです。
- エンジニアリング分析: VS Code や Claude Code などのコーディング エージェントが、Data Agent Kit を通じて同じ基盤に接続します。 OKF は Git ネイティブなので、エンジニアはナレッジそのものをコードと同じレビュー プロセスで育てられます。
入口は 3 つですが、接地はひとつです。どの入口から入っても、同じ定義、同じ権限、同じナレッジで答えが返ります。権限はエージェントのために新設するものではなく、BigQuery と Looker の既存のアクセス制御がそのまま適用されます。
モダナイズもエージェントと進める: 「移行計画書」から始まる
データ基盤のモダナイゼーションが止まる本当の理由は、技術ではなくアセスメントです。 ストレージ内に何があるか誰も説明できず、棚卸しに数か月を要し、その間に意思決定が止まる——多くの企業で繰り返されてきた光景です。
SOAP では、この最初の壁もエージェントに任せます。 既存のメタデータやクエリ履歴などを読み取り専用で収集すれば、コーディング エージェントがテーブル単位の処遇(移行 / アーカイブ / 残置 / 廃棄候補)を判定根拠つきで分類し、フェーズ単位の移行計画書をドラフトします。 判断できない項目は「確認事項」として人間に返してくるため、レビューと承認に集中できます。
生成される計画書には、機械可読な移行マニフェストが付属します。 つまり、資料のための計画ではなく、そのまま次のフェーズで DDL 等に変換できる、実行可能な計画です。 データの棚卸しからドキュメント整備、移行計画の立案まで——これまで数か月を要した工程が、エージェントとの協働では最初のワークショップのアジェンダになります。
SOAP の経済性
このアーキテクチャの経済性は、「運ばない・書き換えない・全部やらない」の 3 点に集約されます。 S3 のデータはゼロコピーで分析し、既存の Parquet 資産はメタデータだけで Iceberg 化し、移行対象はアクセス実態にもとづいて絞り込みます。 実際の棚卸しでは、テーブルの相当数が 12 か月以上参照されていない「廃棄候補」であることも珍しくありません。 移行の恐怖の大半は「全部運ぶ」という誤解から来ています。
次のステップ
AI の賢さは、モデルの選定ではなく、データに与える意味で決まります。 そしてその意味の層は、データを動かす前から作り始めることができます。
最初の一歩は、大きな移行の決断ではありません。 読み取り専用の棚卸しと、最初の OKF バンドルから始めてください。
- Borderless Lakehouse の全体像は、概要ドキュメントをご確認ください。
- Open Knowledge Format は、紹介ブログと仕様をご覧ください。
- グラフを AI との対話に使う方法は、グラフとチャットすることで今日から試せます。
SOAP という名前は Semantic and Ontology Agent Platform の頭字語ですが、そこにはもうひとつの意図も込められています。 長年の運用で埃をかぶったデータも、意味の層で洗い上げれば AI の一級の資産になる、ということです。
レガシーも、洗えば資産です。
著者・コントリビューター紹介
- 執筆者:
- Kuma Arakawa: Senior Customer Engineer
Yu Yamada:Data Analytics Specialist Tech Lead
Akira Igarashi: Data Analytics Specialist Sales Manager
Mei Sakurai: Head of Data Analytics Specialist Customer Engineering, Japan
- Kuma Arakawa: Senior Customer Engineer
- お問い合わせ: Google Cloud のデータ分析・AI エージェント基盤導入に関するご相談は、担当営業またはカスタマー エンジニアまでお気軽にお問い合わせください。