Google Cloud で Claude を大規模に展開: エンタープライズ本番環境向けに構築された最先端の AI
Schneider Larbi
Sr Manager, Global Partner Technical Architecture, AI & SaaS ISVs
Ivan Nardini
Sr. Developer Relations Engineer
※この投稿は米国時間 2026 年 7 月 15 日に、Google Cloud blog に投稿されたものの抄訳です。
最先端の AI を本番環境で運用するには、アクセラレータの管理、大陸間のレイテンシの安定化、規制対象データの地域内保持、長いコンテキストを扱うリクエストの確実な処理など、多くの課題があります。Google Cloud 上の Claude は、まさにこうした課題を解決するために構築されています。
モネと「睡蓮」のように、最先端のモデルとエンタープライズ プラットフォームは、組み合わせることでより大きな価値を生み出すことがよくあります。今回のケースでは、推論機能を Claude が提供し、企業がすでに利用しているマネージド インフラストラクチャ、グローバルなリーチ、コンプライアンス体制を Google Cloud が提供します。Claude の呼び出しは、他の Google Cloud サービスを呼び出すのと運用上まったく同じになります。Identity and Access Management(IAM)、VPC Service Controls、オブザーバビリティも同じであるため、推論インフラストラクチャの運用に時間を費やす代わりに、機能開発に注力できるようになります。
この投稿では、Google Cloud 上の Claude が本番環境で提供する以下の 4 つの領域について説明します。
-
エンジニアの負担を減らすマネージド インフラストラクチャ
-
世界各地のユーザーベースに対してレイテンシを低く抑え、稼働時間を長く保つグローバル エンドポイント
-
Google Cloud から直接継承されるセキュリティとデータ主権の管理
-
大規模な環境でも費用とパフォーマンスを最適化するサービング レイヤの機能
エンジニアの負担を減らすマネージド インフラストラクチャ
Google Cloud 上の Claude はフルマネージド インフラストラクチャ上で実行されるため、エンタープライズ チームはクラスタの構築に時間を費やすことなく、機能の提供に集中できます。最先端モデル規模でのコンピューティング プロビジョニング、自動スケーリング ロジック、ロード バランシング、フェイルオーバーはプラットフォームによって処理されます。これらは、通常であれば複数のチームがフルタイムで取り組む作業です。
Claude は、Agent Platform の Model Garden を通じて Model-as-a-Service として利用でき、標準の REST / JSON over HTTP/1.1 または HTTP/2 エンドポイントを介してすぐに使用できます。Claude の呼び出しは、他の Google Cloud サービスの呼び出しと運用上は同じです。同じ IAM ポリシー、同じ VPC 制御、同じオブザーバビリティ スタック(Cloud Logging や Cloud Monitoring 経由)を利用できます。
Claude をサービングするには、AnthropicVertex クライアントを使用して、数行の Python コードを記述します。
同じ AnthropicVertex クライアントが、プロンプトのキャッシュ保存、ツールの使用、構造化された出力、ストリーミング、適応型思考を処理します。バッチ予測には Vertex AI Batch Prediction を使用します。認証にはアプリケーションのデフォルト認証情報が使用され、リクエストはプロジェクトの IAM と VPC の構成を自動的に継承します。
一貫した低レイテンシと組み込みのフェイルオーバーを備えたグローバルなリーチ
単一のエンドポイントから世界中のユーザーベースにサービスを提供すると、テール レイテンシが高くなり、単一障害点が発生します。安定したパフォーマンスを維持したうえで、複数の大陸にまたがって推論インフラストラクチャを複製できる企業はほとんどありません。
Agent Platform では、Claude 向けに以下の 3 種類のエンドポイントを提供しており、それぞれが異なる本番環境の要件に対応しています。
-
グローバル エンドポイント: 利用可能な AI コンピューティング容量があるリージョンにリクエストをルーティングします。たとえば、us-central1 の容量に制限がある場合、トラフィックは europe-west1 や、利用可能な容量がある別のリージョンにリダイレクトされます。これは、アプリケーション側でのルーティング ロジックを必要とせずに、自動フェイルオーバーと地理的なロード バランシングを行います。グローバル エンドポイントは、費用を最小限に抑えながら最大限の可用性を実現するのに最適です。
-
リージョン エンドポイント(us-east5 や europe-west1 など): プロンプト、完了状況、中間状態を特定の地理的境界内に保持できるため、低レイテンシやデータ所在地の要件に最適です。
-
マルチリージョン エンドポイント: 単一リージョンに依存することなく、米国や EU のデータ所在地を確保できます。リージョンのエンドポイント間で動的にルーティングできるほか、リージョンの障害や容量の制約に対するレジリエンスも組み込まれています。
以下の図は、アプリケーションがこれらのエンドポイントを介して Claude にアクセスする方法と、Agent Platform のサービング レイヤがリージョンをまたいでコンピューティング AI クラスタにトラフィックをルーティングする方法を示しています。
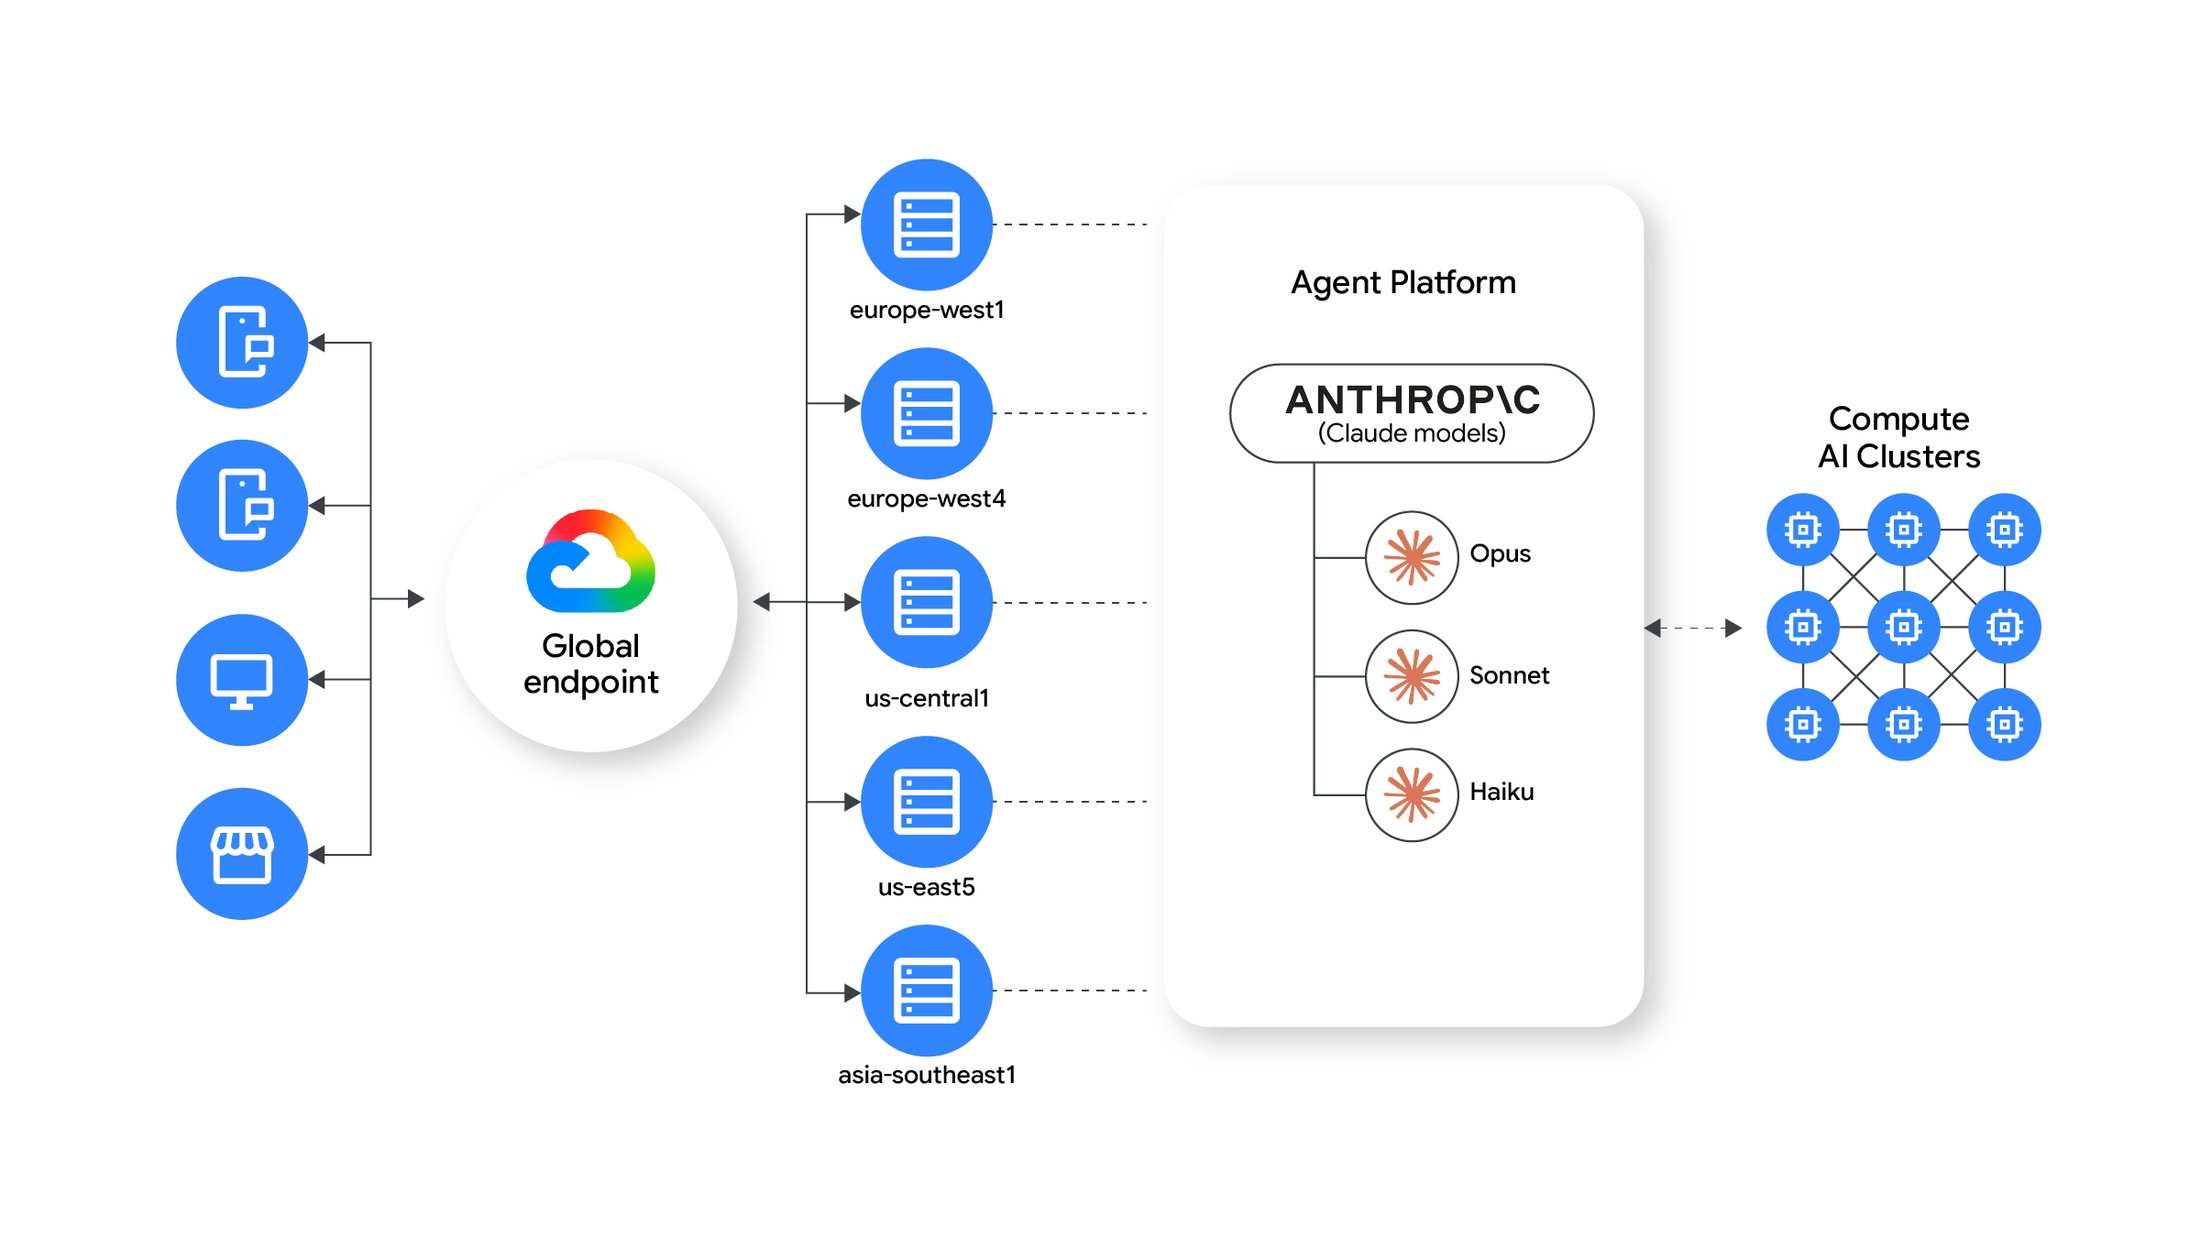
リージョン エンドポイントとグローバル エンドポイントからの Claude モデルのサービング
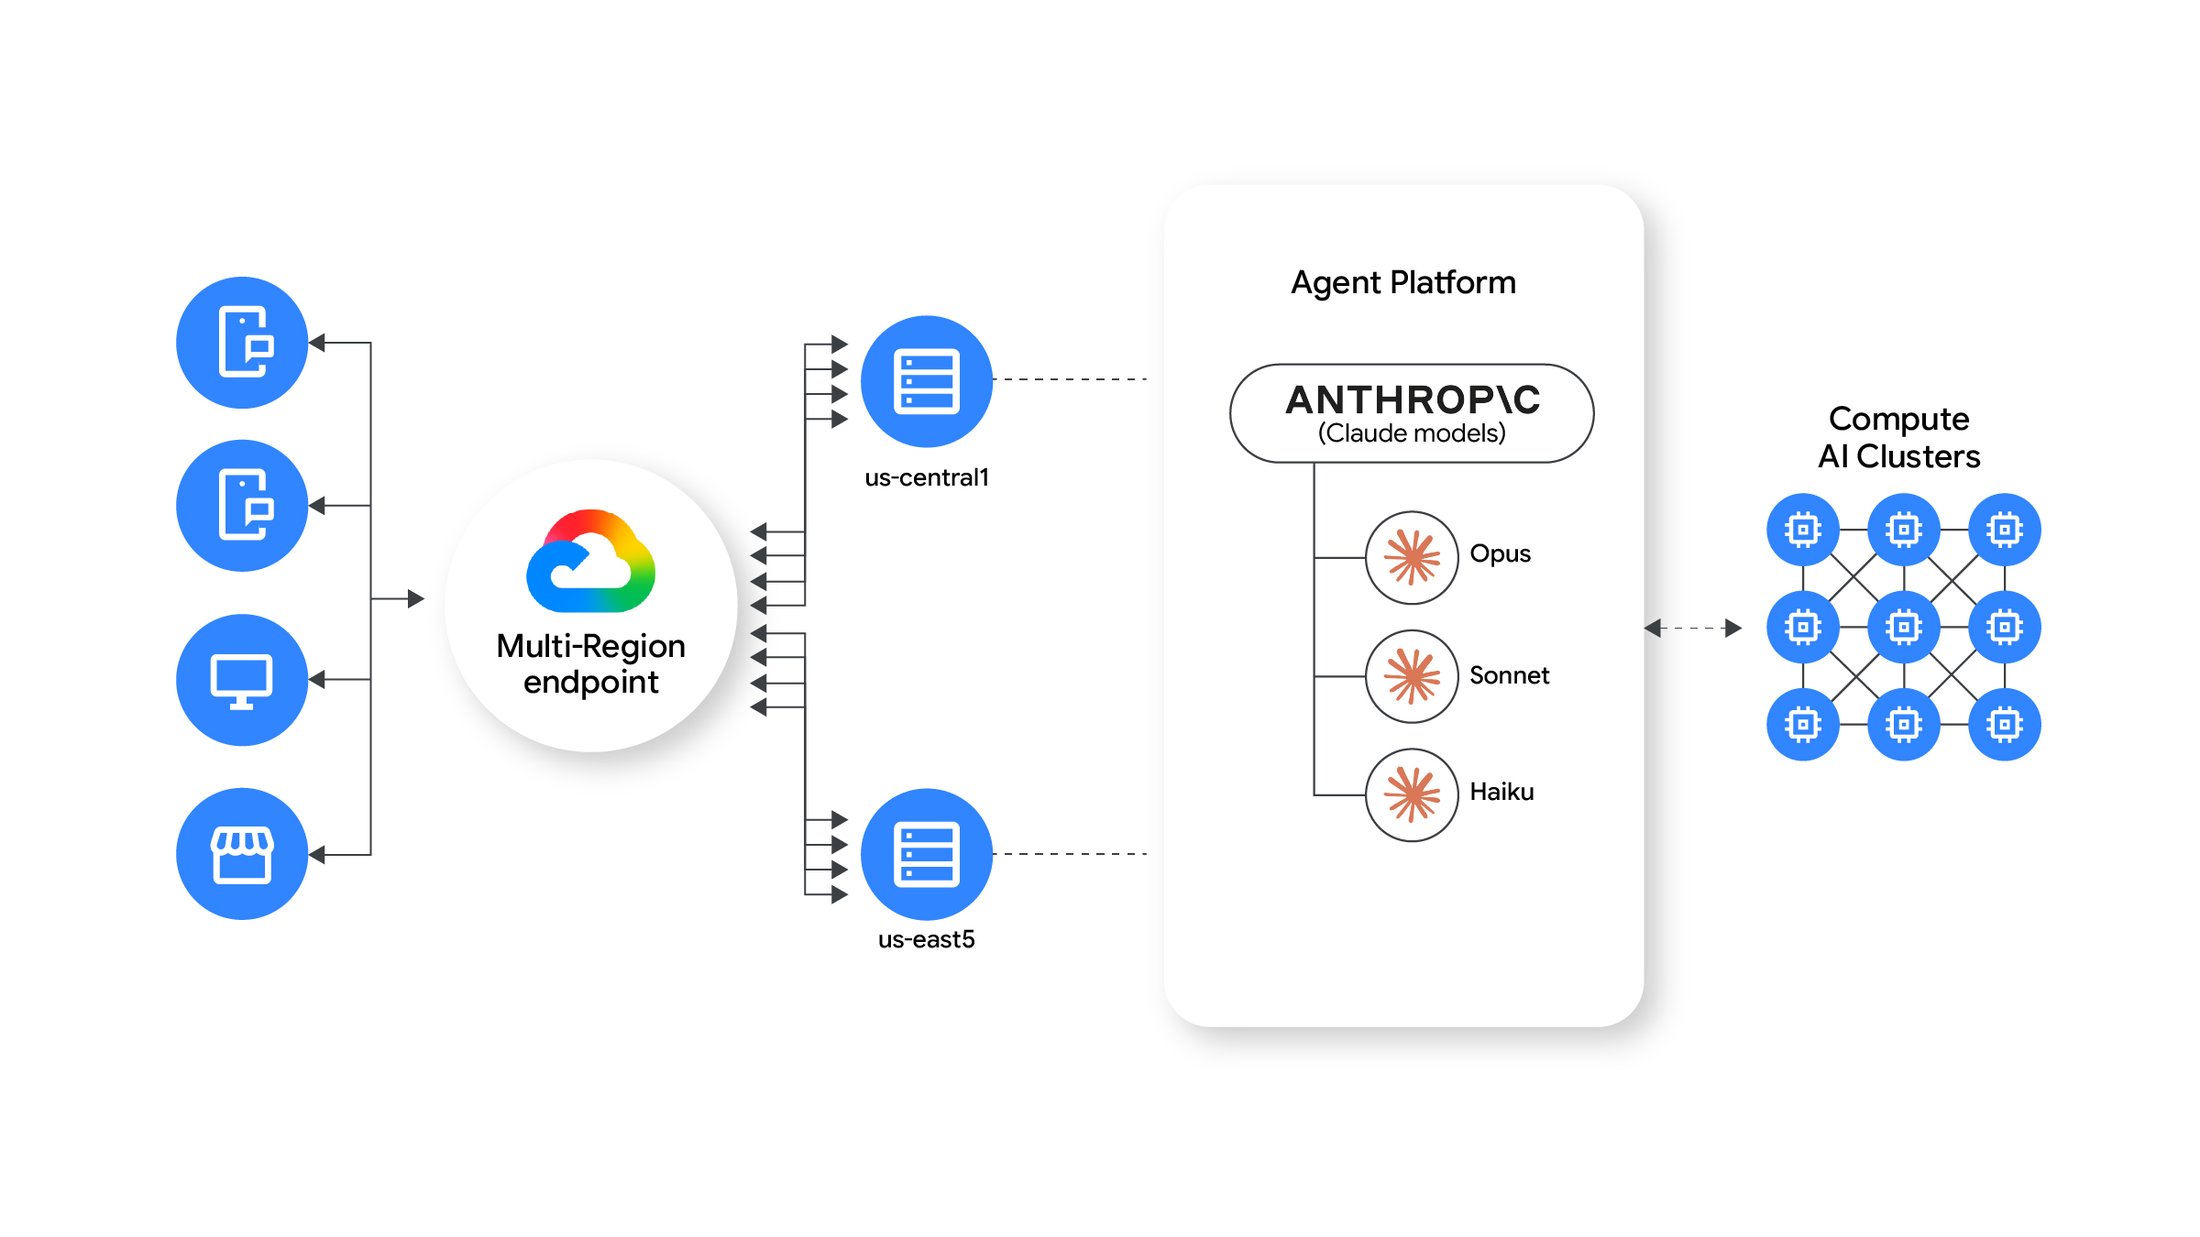
マルチリージョン エンドポイントからの Claude モデルのサービング
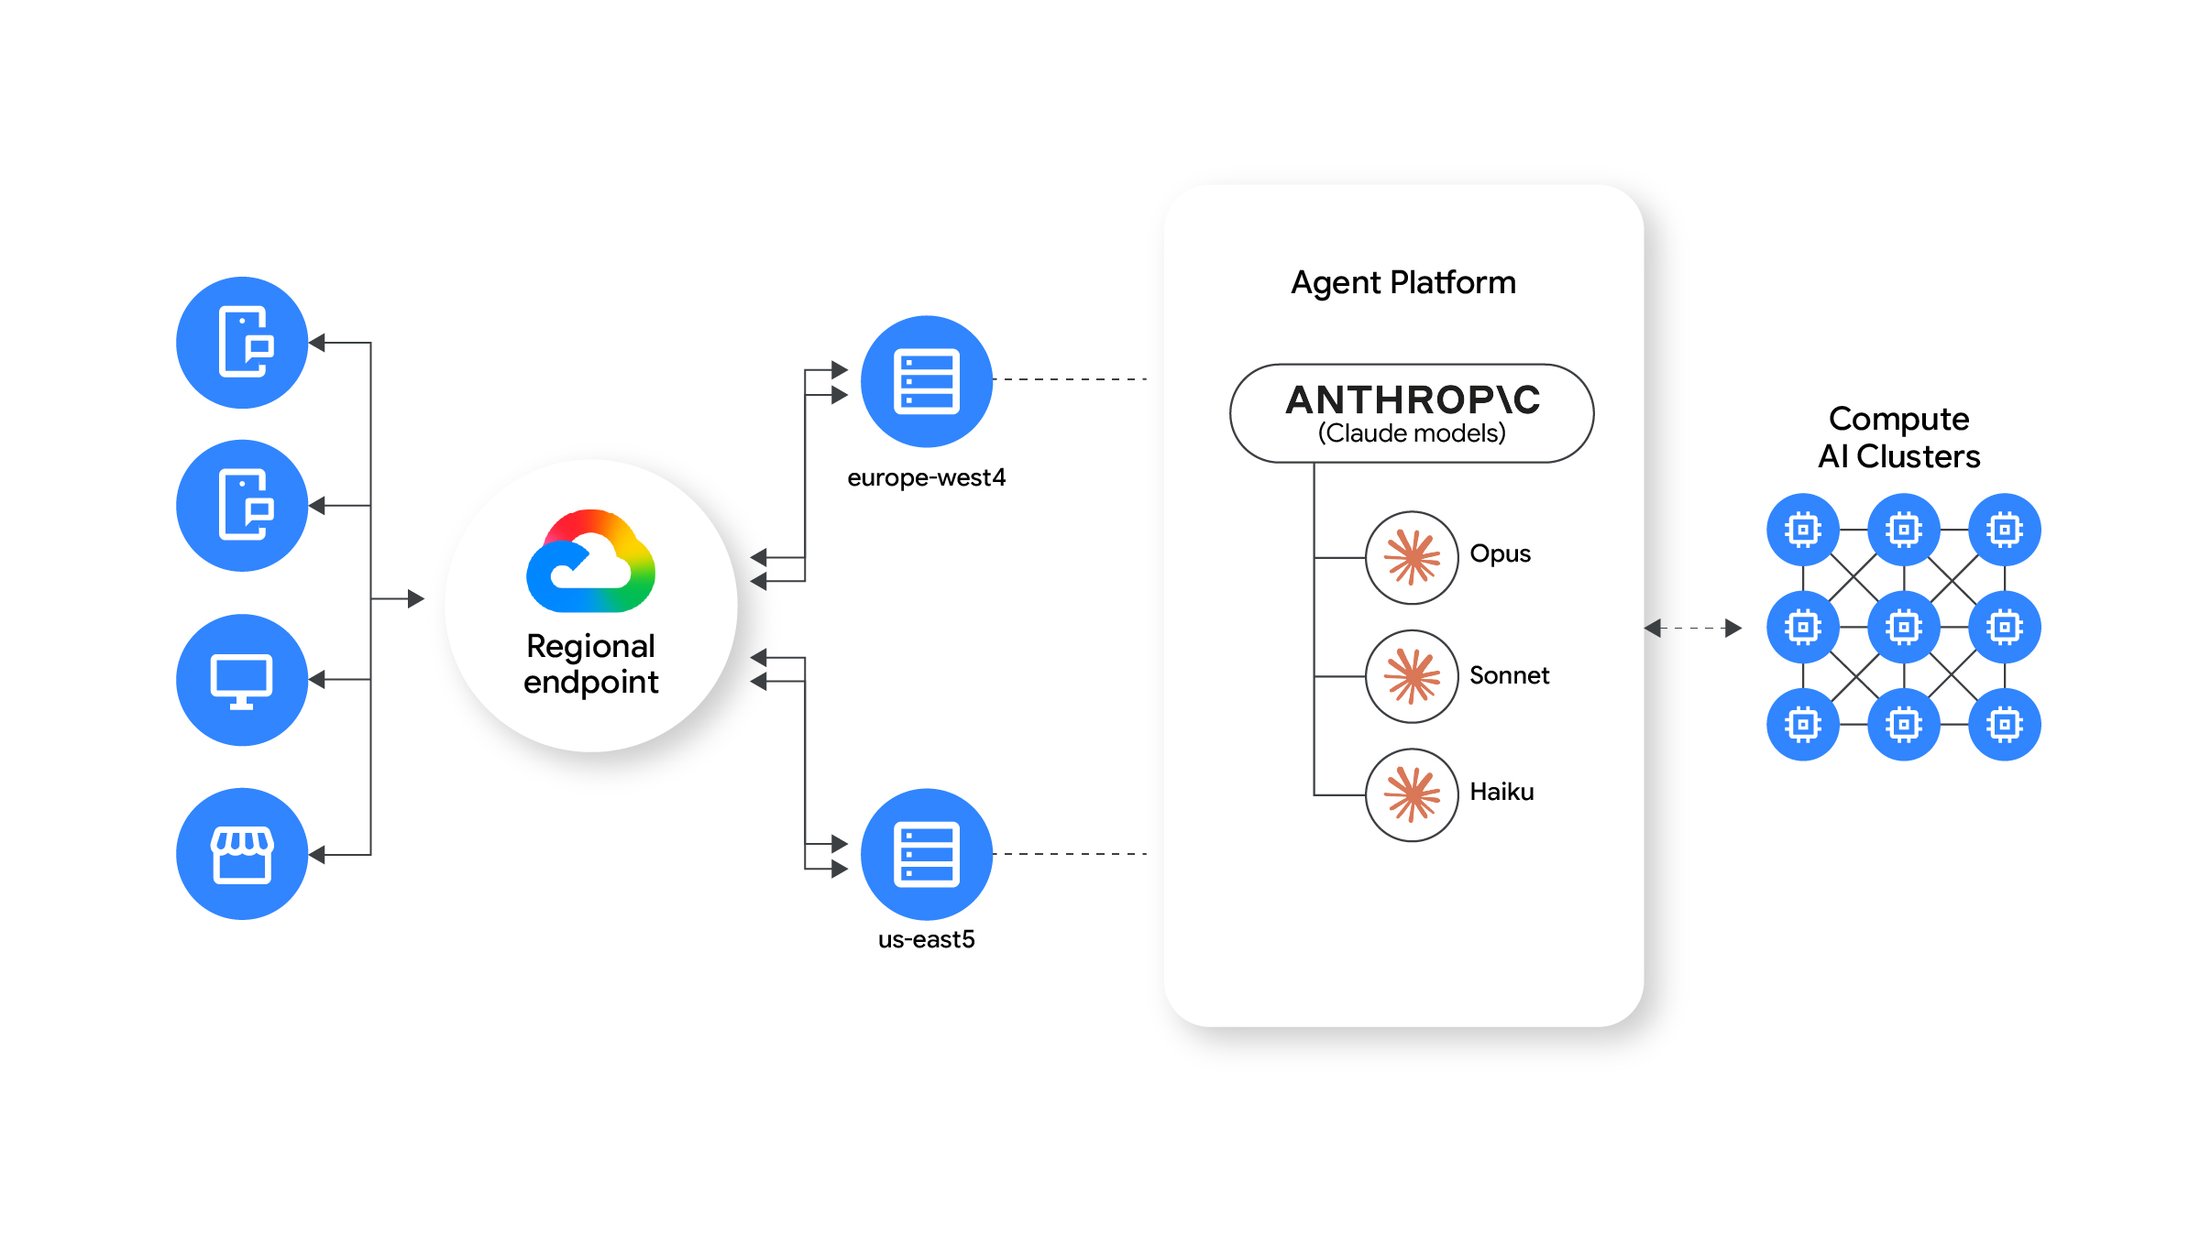
リージョン エンドポイントからの Claude モデルのサービング
エンタープライズ セキュリティとデータ主権を組み込み
金融サービス、ヘルスケア、行政といった規制対象のワークロードであっても、コンプライアンスを犠牲にしたり、利便性を手放したりすることなく、エンタープライズ グレードのセキュリティとデータ主権を確保できます。しかも、「推論」という制御が最も難しいレイヤ(プロンプト、完了状況、中間状態のすべてがサービング スタックを通過するプロセス)を再設計する必要もありません。
Agent Platform 上の Claude は、Google Cloud のセキュリティ ポスチャーを完全に継承します。FedRAMP High および HIPAA への準拠により、政府機関、医療機関、金融サービス環境での導入が可能となります。VPC Service Controls を使用すると、Agent Platform リソースの周囲に境界を定義して、データ漏洩を防ぐことができます。IAM ネイティブのアクセス制御により、他のすべての Google Cloud リソースを保護するのと同じロールとポリシーで Claude エンドポイントを管理できます。別途 API キーを管理したり、ローテーションしたりする必要はありません。Cloud Logging と Cloud Monitoring を使用すると、トークンの使用状況、エラー率、レイテンシ、割り当て使用量を準リアルタイムで可視化できます。
上記のリージョン エンドポイントとマルチリージョン エンドポイントを組み合わせることで、規制対象のお客様は、コンプライアンス体制の再監査を行うことなく、最先端の AI を本番環境で運用できるようになります。
費用とパフォーマンスを大規模に最適化
本番環境では、費用とパフォーマンスがあらゆるアーキテクチャ上の意思決定を左右します。この両方を適切に実現するには、Claude のネイティブ モデル機能と Google Cloud のサービング インフラストラクチャという 2 つのレイヤの機能が必要です。Agent Platform は両方をサポートしているため、これらを個別に管理することなく、スタック全体にわたって最適化を図ることができます。
Agent Platform で完全にサポートされる Claude ネイティブの機能
以下の機能は Claude に組み込まれているため、追加構成を行わなくても Agent Platform で利用できます。
-
プロンプト キャッシュ: 共有プレフィックス(長いシステム プロンプト、法的文書、コードベースなど)を保存して再利用することで、リクエストのレイテンシを最大 80%、費用を最大 90% 削減します。
-
サーバー送信イベントを介したレスポンスのストリーミング: トークンが生成されるたびに配信されます。これは、認識されるレイテンシが重要となるチャット インターフェースやコーディング アシスタントにとって非常に重要です。
-
拡張された適応型思考: Claude は複雑な多段階の問題に対して、いつ、どの程度推論するかを動的に判断できます。また、ユーザー側で思考量を直接調整することも可能なため、費用管理などに活用することもできます。高度なコード生成、数学的推論、複数ドキュメントの分析などのユースケース向けに最適化されています。
-
最大 100 万トークンまで拡張されたコンテキスト ウィンドウ(Claude Opus 4.6、Sonnet 4.6、およびそれ以降のモデル): 長文ドキュメントの分析、大規模なコードベースの推論、マルチターンの深い会話が可能になります。
Google Cloud のサービング インフラストラクチャ
Agent Platform は、Claude のネイティブ機能に加えて、以下のような独自のサービング レイヤ機能を提供します。
-
バッチ予測: ドキュメント分類、コンテンツ モデレーション、一括要約といった大規模なオフライン ワークロードを、低優先度で非同期的に処理し、費用を削減します。
-
プロビジョンド スループット: ミッションクリティカルなワークロードのために専用の推論容量を確保し、パブリック トラフィックから分離することで、需要のピーク時でも予測可能なパフォーマンスを保証します。
-
メモリ管理とスケジューリング: 長いコンテキストを扱うリクエストに対するメモリ管理やスケジューリングは、インフラストラクチャ レイヤで処理されます。
これらの 2 つのレイヤを組み合わせることで、モデルレベルの効率性からインフラストラクチャ レベルの容量制御に至るまで、単一の統合プラットフォームであらゆる最適化手段を活用できるようになります。
推論からエージェントへ
Claude の推論機能を提供するのと同じインフラストラクチャが、Google Cloud の Agent Platform のエージェント レイヤを支えています。構築と登録のフローには、以下の 3 つのステップがあります。
-
Claude で構築する。Claude はオーケストレーションのバックボーンとして非常に適しています。拡張されたコンテキスト ウィンドウ、ネイティブなツール使用、適応型思考により、複数のステップからなるタスクの計画やサブエージェントへの委任を効果的に行うことができます。Model Garden から任意の Claude モデル(Opus、Sonnet、Haiku)を選択し、Agent Development Kit(ADK)を使用して Python、Go、Java、TypeScript でコード ファーストの構築を行った後、Agent Runtime、Cloud Run、Google Kubernetes Engine にデプロイします。
-
エージェントをランタイムにデプロイする。ユースケースに応じて、Agent Runtime、Google Kubernetes Engine、GKE Agent Sandbox を選択し、デプロイしたエージェントを実行します。
-
A2A を介して相互運用する。Agent2Agent(A2A)プロトコルはすでに 150 以上の組織で運用されています。このプロトコルを活用することで、登録済みの Claude 搭載エージェントが、SaaS やその他のサービス プロバイダのエージェントにタスクを委任できるようになります。
この結果、Claude を基盤とするプランニング エージェントは、統合された IAM の下で完全に監査可能となり、より広範なエージェント エコシステム全体でサブタスクをオーケストレートできます。しかも、基盤となる推論機能を提供するのと同じインフラストラクチャ上で動作します。
構築を開始しましょう
Agent Platform コンソールを開き、Model Garden で Claude を有効にして、AnthropicVertex SDK を使用して最初の API 呼び出しを行います。ワークロードの要件に応じて、プロンプト キャッシュやプロビジョンド スループットのほか、その他の機能も追加できます。エージェントを利用する準備が整ったら、Agent Platform 上の Claude の詳細をご確認ください。
Claude を本番環境に大規模に導入する方法については、Google Cloud の営業担当者にお問い合わせください。
- AI および SaaS ISV 担当シニア マネージャー兼グローバル パートナー テクニカル アーキテクチャ、Schneider Larbi
- シニア デベロッパー リレーションズ エンジニア、Ivan Nardini